 AI-Papers
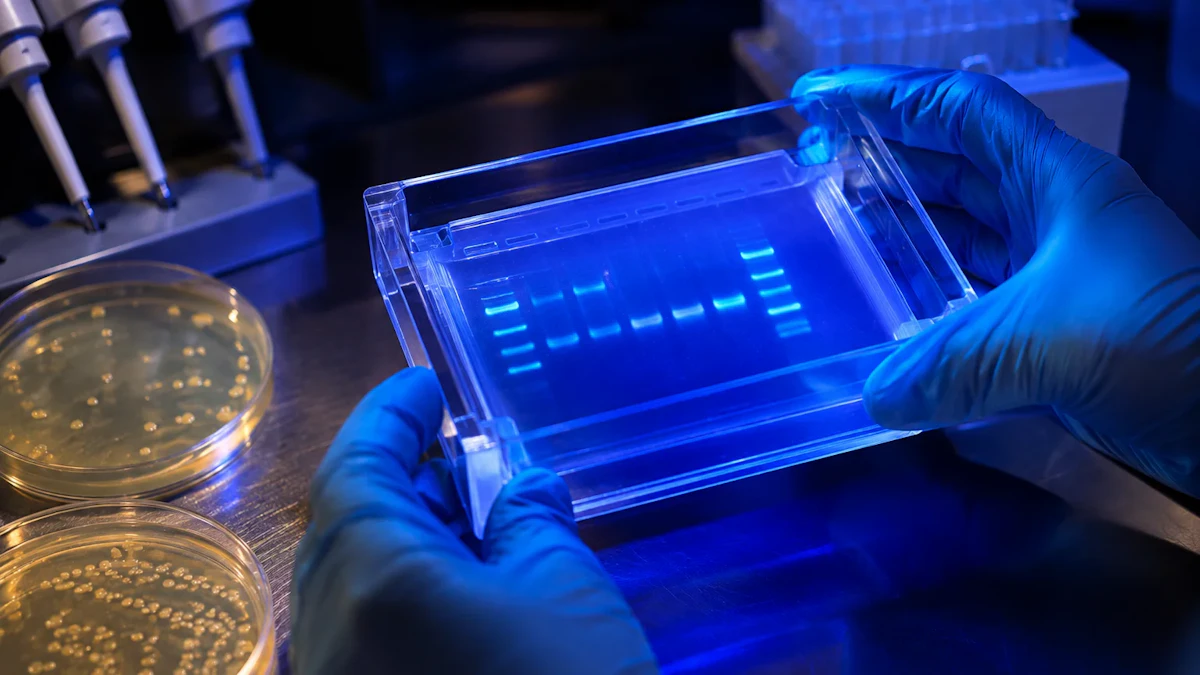
- OpenAIが酵素設計企業Ligoと共同で、ウェットラボの日常業務を題材にした100タスクのベンチマークBioBasicsBenchを公開した
- ゲル画像や装置の出力、寒天プレートの写真など生の実験データを素材に、専門家が書いたルーブリックで部分点を含めて採点する
- 最高はGPT-6 Astraの66.7%で、コントロールの読み違いやコロニーの約12%過大計数といった失敗が残る
BioBasicsBenchとは?
OpenAIは2026年11月6日、AIエージェントがウェットラボ(実際に試薬や細胞を扱う実験室)の日常的な作業をどこまで正しく処理できるかを測るベンチマークBioBasicsBenchを公開しました。酵素設計を手がけるバイオテクノロジー企業Ligoとの共同開発で、タスク数は100です。
狙いは、論文読解や仮説生成ではなく「生の実験データを正しく解釈できるか」にあります。既存の生物学系ベンチマークは論文掲載用に選ばれた図を素材にすることが多く、失敗した実験、判別しにくい画像、互いに矛盾する観察といった現場の曖昧さが抜け落ちるとOpenAIは指摘しています。
実験の加速をAIに任せるなら、まず日常の判断を外さないことが前提になるという整理です。トラブルシューティングを含む地味な作業こそが評価対象になっています。
100タスクの構成
タスクは実験手法ごとに5つの領域へ分かれています。いずれも研究者が日々向き合う工程です。
- タンパク質実験(protein methods)
- イメージングとサイトメトリー
- 定量とアッセイ
- 核酸実験(nucleic acid methods)
- 分子クローニング
入力として与えられるデータは幅広く、電気泳動ゲルやブロットの画像、プロトコルや実験メモ、表形式の装置エクスポート、実験台の写真、顕微鏡画像、装置の画面やプロット、シーケンシングファイル、手順を撮った動画、寒天プレート上のコロニーなどが含まれます。ラダーの対応表やプラスミドマップは補助資料として添えられます。
多くのタスクは生物学の知識、画像やデータの解釈、異常の検知、プロトコルの理解といった複数のスキルを同時に問う作りです。スキルタグやデータ種別は互いに重複するため、タグ件数を足してタスク総数にはできないと注記されています。
作問と採点の仕組み
各タスクは研究者が自身の実験データをもとに作問し、質問ごとに専門家が採点ルーブリックを用意しました。品質確認は3段階で、作問していないLigoの研究者による内部レビュー、博士号を持つ外部のウェットラボ研究者によるレビュー、そして最終の内部レビューを通しています。
エージェントは結論、測定値、あるいは推奨事項を構造化された形式で返し、必要な場合は根拠となる推論も添えます。採点はルーブリックの項目単位で行われるため、部分的に正しい解析には部分点が入ります。項目は結論の正しさ、数値、推論の筋道に加え、証拠が不十分だと認識できたかも評価します。
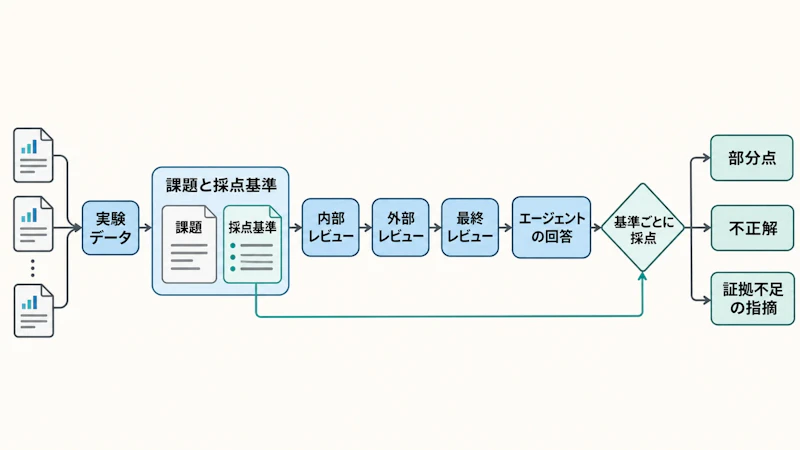
図1のように、作問からレビュー、ルーブリック採点までが一本の流れで設計されています。スコアは獲得点の割合を平均したmean rewardで報告され、信頼区間はタスク単位のリサンプリングで求めた95%区間を用います。
モデル別の評価結果
評価は7つのモデルを対象に、モデルと推論強度の組み合わせ37設定、1タスクあたり5試行で実施され、結果は合計18,500件に達しました。推論強度を最も高いxhighに設定したときのmean rewardは次のとおりです。
モデル | mean reward | 95%信頼区間 |
|---|---|---|
GPT-6 Astra | 66.7% | 60.3〜73.1% |
GPT-6.1 Sol | 62.0% | 55.6〜68.4% |
GPT-5.6 Sol | 43.8% | 37.6〜50.0% |
GPT-6 Luna | 38.3% | 32.3〜44.5% |
GPT-5.5 | 35.4% | 29.7〜41.0% |
GPT-5.4 | 33.2% | 28.3〜38.4% |
GPT-5.2 | 31.2% | 26.2〜36.3% |
GPT-5.2からGPT-5.5までは31〜35%台で横並びですが、GPT-6.1 SolとGPT-6 Astraで20ポイント前後の差が開いています。OpenAIは、この伸びの背景としてネイティブなマルチモーダル処理能力の強化が鍵になっている可能性を挙げています。
3つの失敗パターン
最高スコアのGPT-6 Astraでも、失敗の内容には共通した傾向が見られました。1つ目は思い込みがコントロール(対照実験)に基づく解釈を上書きするケースです。コロニーPCRの課題では「産物が大きいほうが成功」という前提で判断し、コントロールから導かれる解釈を逆向きに読んで誤ったコロニーを選びました。
2つ目は矛盾する観察を切り捨てる傾向です。液胞の例では「液胞は暗く見える」と一般化し、同じ画像内にある明るい液胞を記述から落としました。これは焦点の違いによるコントラストの変化で説明できるものでした。
3つ目は計数の誤りです。コロニーの計数では、近接したコロニーを分離できず、見えているコロニーを見落とし、何もない寒天を数え上げる誤りが重なり、純計で約12%の過大計数になりました。この種のずれはDNAの形質転換効率の見積もりを過大にし、下流の判断に影響します。
実務投入への示唆
OpenAIは、ベンチマークのスコアが上がったことをもって実験室で信頼できる判断ができるようになったとは言えない、と明言しています。生データの読み取り、コントロールの確認、根拠のない結論を結論として出さないこと、この3点が改善目標として示されました。
創薬やバイオの現場でエージェントを使う側にとっては、どの工程を任せられてどこに人のレビューを残すかを考える材料になります。計算側ではGoogle DeepMindがCheminformatics Skillsを公開、約1時間で新規分子設計のように分子設計の自動化が進んでおり、実験台側の能力を別途測る指標が並ぶ形になりました。
OpenAIはこうした能力を継続的に追跡することが、バイオセーフティとバイオセキュリティ上の含意を把握するうえでも役立つとしています。なお、データセットを公開するかどうかについては記事中で言及されていません。


