 AI-Papers
- 理解用と生成用のパラメータを分けたMixture-of-Transformers骨格に疎なMoE層を組み合わせ、総計31.7Bのうち生成時は約5.4Bのみを動かす構成
- PRISM-BenchやQwen-Image-Bench、編集系のGEdit・ImgEditでオープンソースモデルの中では上位、ただし商用モデルには届かない水準
- MeanFlow蒸留版のWeLM-Image-Turboは単一のNVIDIA H20で1024px画像を8ステップ4.98秒、50ステップ構成比で11.4倍の高速化
研究の背景
テキストから画像を生成する、指示文に従って既存画像を編集する、複数の参照画像を組み合わせて合成する。これらはそれぞれ別のモデルで扱われることが多く、サービスとして束ねると運用コストが膨らみます。一方で1つのモデルに統合しようとすると、画像を理解する能力と画像を生成する能力が同じ重みを取り合い、学習が互いに干渉しやすくなります。
arXivで公開された「WeLM-Image: A Unified Image Foundation Model towards Visual Intelligence」(arXiv:2611.07392)は、この統合を単一GPUでの運用を前提に設計した研究です。WeChatという大規模な消費者向けアプリでの提供を想定し、生成・編集・複数参照合成を1つのモデルで扱いながら、1枚あたりの推論コストを抑える方向に振り切っています。
WeLM-Imageは、プロンプト文、参照画像、生成対象のノイズ付き潜在表現をすべて1本のインターリーブされた系列として処理します。つまりタスクごとに専用の入力経路を用意するのではなく、系列の並べ方と注意の掛け方でタスクを切り替える設計です。
理解と生成を分けた骨格
骨格はMixture-of-Transformers(MoT、経路ごとに別の重みを持つTransformer)です。理解経路と生成経路がそれぞれ独立したフィードフォワード層を持ち、注意機構(入力のどこに注目するかを決める仕組み)だけを全層で共有します。これにより、理解と生成が重みを奪い合う干渉を抑えつつ、両者が同じ文脈を見られるようにしています。
さらに各経路のフィードフォワード層にMixture-of-Experts(MoE、入力ごとに一部の専門家ネットワークだけを使う仕組み)を入れています。デコーダは27層で隠れ次元は2048、各経路にルーティング対象のエキスパート64個と常時使う共有エキスパート2個を持ち、理解経路は上位6個、生成経路は上位20個を選びます。
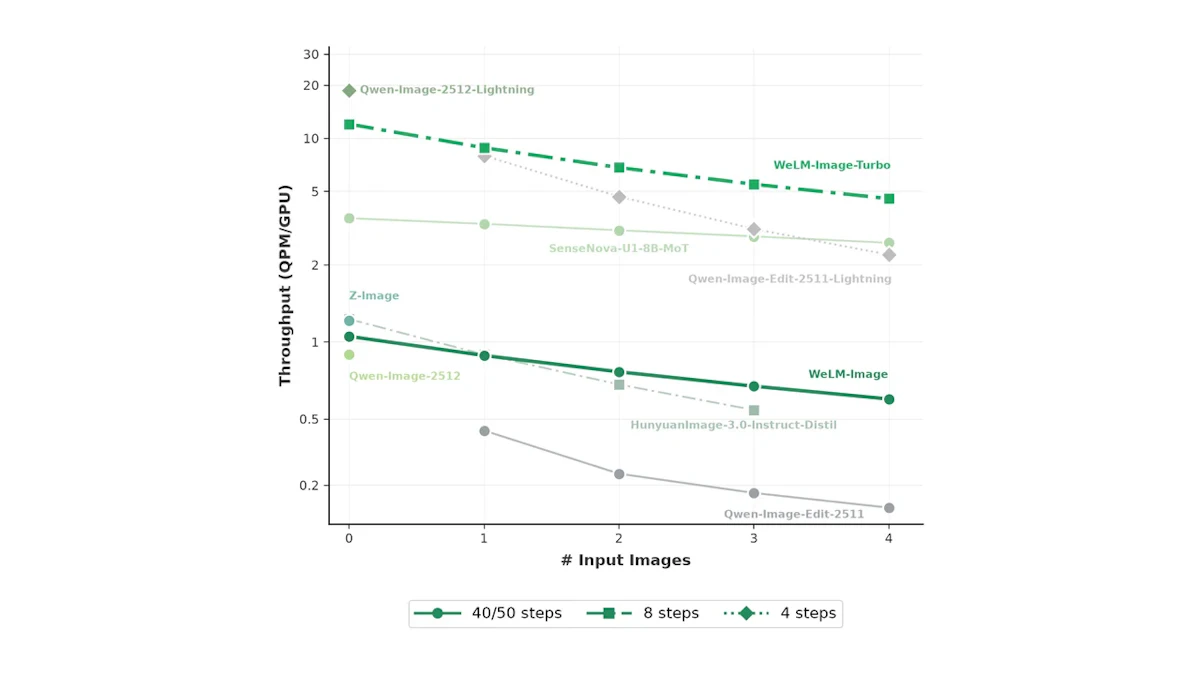
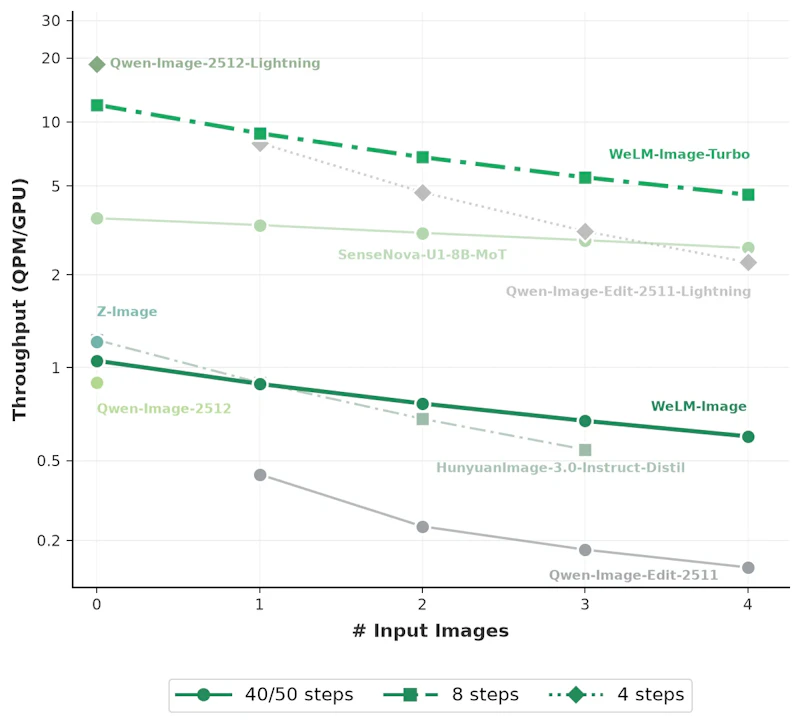
結果として、保存されるパラメータは31.7Bに達する一方で、実際に動くのは理解トークンあたり約2.2B、生成トークンあたり約5.4Bにとどまります。視覚入力はViTが高レベルな内容を捉え、独自のVAEが8倍の空間圧縮と16チャネルの潜在表現を担います。言語側は専用のテキストエンコーダを置かず、Kimi-VLから初期化した言語モデル本体のトークナイザと重みをそのまま使う構成です。図1の左側に示されているように、入力画像の枚数が増えても1GPUあたりのスループットを保てる点が、この疎な構成の狙いです。
1本の系列を注意で仕切る
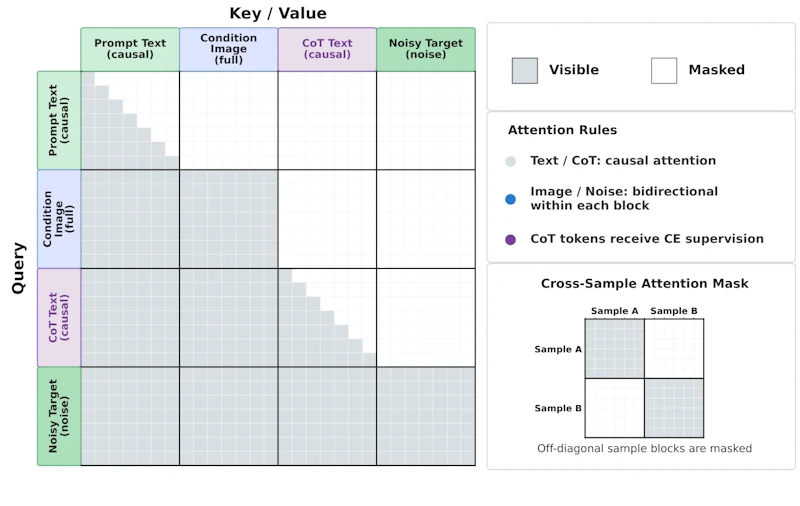
タスクの違いを吸収しているのは、ブロック単位で設計された注意マスクです。テキスト部分は過去だけを見る因果的な注意、条件画像と生成対象のノイズ付き潜在表現はそれぞれのブロック内で双方向の注意を使います。
重要なのは、ノイズ付き潜在表現が先行する条件をすべて読める一方で、その鍵と値は前方のブロックから隠されている点です。これがなければ生成対象の情報が条件側に漏れ、学習が成立しません。図4では、この可視・不可視の関係が行列として示されており、Chain-of-Thought(思考過程のテキスト)のトークンにクロスエントロピー損失が掛かる箇所や、まとめて詰め込んだ複数サンプル同士が隔離されている様子も読み取れます。
データと学習の進め方
データ側では約50億枚の原画像プールを約6億枚まで絞り込み、残った画像のうち59.74%が1024以上の解像度です。美的品質の評価にはElo方式のペア比較で学習した内製モデルを使い、知識に紐づけた視覚語彙でコンセプトごとの採用枠を決め、球面k-meansで画像プールを均衡させています。編集データはタスクのオントロジーと編集タグに沿って構築され、強化学習の段階では27種類の編集アクションを扱います。複数参照の合成データは18タスクで数十万件規模です。
学習は512解像度の事前学習から始まり、1024で複数参照データを追加し、1536では64Kトークンの文脈長に拡張して理解データを外します。その後SFTを経て、テキストから画像への生成と画像編集を別々に強化学習(DiffusionNFTとLoRAを使用)で最適化し、分かれた方針をノイズを考慮したon-policy蒸留で1つに統合します。最後にMeanFlowベースの少数ステップ蒸留でTurbo版を作ります。
実験結果
生成系と編集系の主要ベンチマークでの比較は次のとおりです。PRISM-BenchとQwen-Image-Benchは生成、GEditとImgEditは単一画像の編集を評価します。
モデル | PRISM-Bench | Qwen-Image-Bench | GEdit | ImgEdit |
|---|---|---|---|---|
GPT-Image-2 | 8.039 | 63.165 | 8.580 | 4.665 |
Seedream-5.0-Pro | 7.421 | 59.591 | 8.460 | 4.650 |
FLUX.2-dev | 7.385 | 53.048 | 4.347 | 2.890 |
HunyuanImage-3.0-Instruct-Distil | 6.959 | 50.087 | 8.101 | 4.552 |
WeLM-Image | 7.555 | 54.155 | 8.381 | 4.581 |
WeLM-Image-Turbo(8ステップ) | 7.482 | 55.992 | 8.314 | 4.537 |
論文は1536解像度のモデルがPRISM-Bench、Qwen-Image-Bench、UnicBenchでオープンソースモデル中の首位だと報告しています。UnicBenchの編集側では8.992、ImgEditでは追加や合成の項目でオープンソース勢の最高値を取りました。ただしGPT-Image-2やSeedream-5.0-Proといった非公開モデルは多くの項目で上回っており、個別の指標では他のオープンソースモデルが勝つ場面もあります。
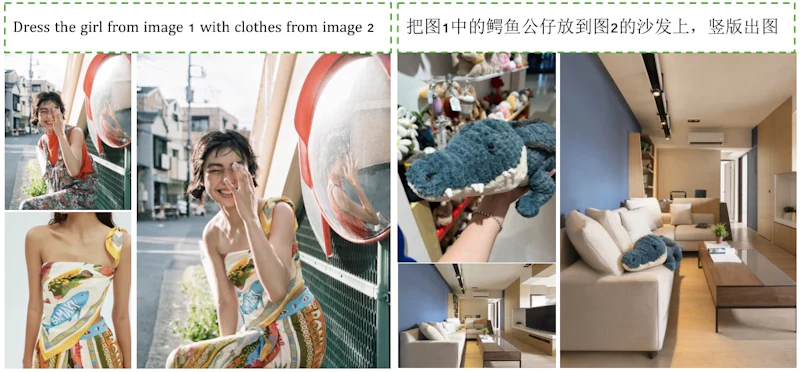
興味深いのは、8ステップのTurbo版が元のモデルから大きく劣化していない点です。Qwen-Image-Benchではむしろ上回っており、少数ステップ蒸留が指示追従の面で必ずしも犠牲を伴わないことを示しています。編集結果の例は図14に並べられており、指示の対象だけを変えて周囲を保つ挙動が確認できます。多ターンの編集で品質が崩れていく問題については、TailSteenのような軌道末尾を学習する手法と合わせて考えると論点が見えやすくなります。
速度と残る課題
実用面での数値は明快です。WeLM-Image-Turboは単一のNVIDIA H20で1024×1024の画像をguidance-freeの8ステップ、4.98秒で生成します。これは50ステップにclassifier-free guidanceを併用する構成に対して11.4倍の高速化にあたります。編集では入力画像1枚から4枚で6.78秒から13.17秒です。
著者自身が計測の前提に注意を促している点も見ておきたいところです。これらの数値はカーネルレベルの最適化や量子化、ステップキャッシュ、グラフコンパイルを適用しない状態のもので、改善の余地が残る上限値として提示されています。またレイテンシの比較はモデル規模やスケジュール、並列化の違いを含むため、アーキテクチャ単独の寄与を切り分けたものではありません。guidance-freeの構成は1ステップあたりのネットワーク評価が1回で、通常構成の2回とは条件が異なります。
まとめと今後の展望
WeLM-Imageは、大規模言語モデルで定着した疎なMoEを画像生成の基盤モデルに持ち込み、理解と生成でパラメータを分けるMoT構成と組み合わせた事例です。31.7Bという総容量を持ちながら1トークンあたり5.4Bで動かす設計は、品質と単一GPU運用の両立を狙った現実的な折衷と言えます。
一方で、統合モデルとしての完成度には偏りがあります。現時点では生成と編集に重心が置かれ、理解データの役割は限定的で、著者も視覚理解の強化を次版の課題に挙げています。複雑な指示下での制御の信頼性と効率改善も継続テーマとされており、公開されたのは統合の到達点ではなく出発点に近い位置づけです。
論文情報: "WeLM-Image: A Unified Image Generation Model towards Visual Intelligence"(Canmiao Fu et al., 2026) arXiv:2611.07392, CC BY 4.0
本記事の図(図1、図4、図14)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


