 AI-Papers
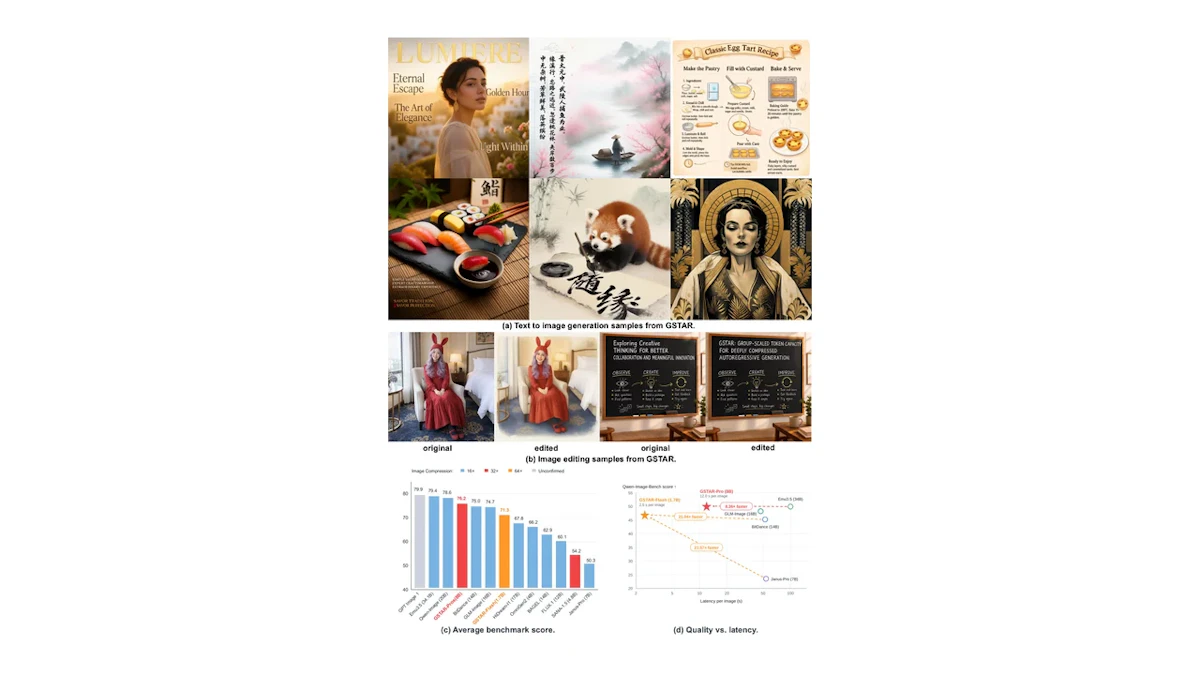
- Product Quantization の解析から「空間圧縮率を軸ごとにα倍するならグループサイズはα²倍に拡張すべき」という設計原理を導出
- 32倍圧縮と可逆な2×2パッキングで実効64倍圧縮を実現し、自己回帰のステップ数を大幅に削減
- GSTAR-Flash-1.7B は H200 1枚で1024×1024画像を約2.5秒で生成し、主要5ベンチマークで上位モデルと競合
研究の背景
離散自己回帰(Autoregressive、AR)型の画像生成は、画像をいったん離散トークンの列に変換し、言語モデルと同じように次のトークンを順番に予測していく方式です。言語モデルの学習基盤やスケーリング則をそのまま流用できる利点があり、画像理解と生成を1つのモデルに統合しやすいという特徴もあります。
ただし速度面の制約が大きく残っていました。トークナイザの空間圧縮率が16倍であれば、1024×1024の画像は64×64=4096個の位置になり、そのぶん逐次予測を4096回繰り返す必要があります。拡散モデルが数十ステップで済むのに対し、生成に数十秒かかるのが実情でした。
素朴な解決策は空間圧縮をさらに強めることですが、位置の数を減らすとトークン列が保持できる情報量そのものが落ち、再構成品質が崩れます。この論文「G-STAR: Group-Scaled Token Capacity for Deeply Compressed Autoregressive Generation」は、圧縮率と情報量のトレードオフを「グループサイズ」という別の軸で解消するという立場をとっています。
グループサイズの設計原理
G-STAR の出発点は Product Quantization(積量子化、1つの特徴ベクトルを複数の部分に分けてそれぞれ別のコードブックで量子化する手法)です。各空間位置を1個のコードではなく G 個のコードの組で表すと、その位置が担える情報量は G に比例して増えます。
ここから導かれるのが本研究の中心的な主張です。1枚の画像あたりの名目情報量は「位置の数 × G × コードブックサイズの対数」で決まるため、軸ごとの空間圧縮率をα倍すると位置の数は1/α²になります。つまり情報量予算を保ったまま列を短くするには、G をα²倍に拡張する必要があるという二次スケーリングの関係が成立します。
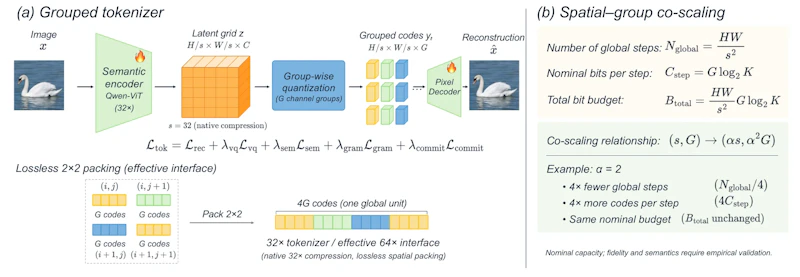
図1の通り、G-STAR は意味エンコーダで画像を圧縮した潜在格子に変換し、各位置を G 個の離散コードで表現します。さらに32倍格子の隣接2×2領域をまとめる可逆パッキングを適用することで、グローバルな自己回帰ステップ数を4分の1に減らし、1ステップあたりのコード数を G から 4G へ引き上げます。この操作は再量子化を伴わないため情報の損失がありません。
実際に用意された構成は2種類です。この設計は離散トークンで理解と生成を統一しようとする dNaViTとは?離散視覚トークンで理解・生成・編集を統一する新手法 と同じ系譜にあり、トークナイザ側の圧縮設計を突き詰めた形になっています。
- GSTAR-Pro-8B: 32倍圧縮、G=16、Qwen3-8B から初期化
- GSTAR-Flash-1.7B: 32倍・G=8 を2×2パッキングして実効64倍・G=32、Qwen3-1.7B から初期化
ImageNet でのアブレーションでは、32倍圧縮・コードブックサイズ16,384の条件で rFID(再構成品質の指標、低いほど良い)が G=1 の2.0624から G=16 で0.5357、G=32 で0.4325まで改善しました。グループサイズの拡張が深い圧縮下の品質を支えていることが数値で確認できます。
半自己回帰ヘッド
グループサイズを大きくすると、今度はグループ内のコード同士の依存関係が問題になります。16個や32個のコードを互いに無関係に出力すると、組み合わせとして成立しない不整合なコード列が生まれてしまうためです。
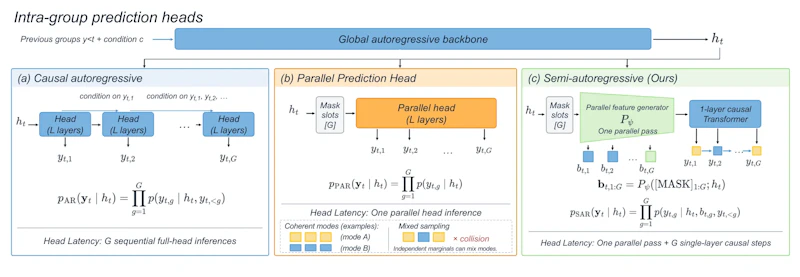
図2は3つの選択肢を並べたものです。因果AR方式はグループ内も逐次予測するため依存関係を捉えられますが、重いヘッド計算を何度も繰り返します。並列方式は高速な反面、依存関係を無視します。
提案手法の半自己回帰ヘッドは、重い特徴生成を並列に1回だけ実行し、その上に載せた1層の因果Transformer(KVキャッシュ付き)が逐次サンプリング時の依存関係だけを担当します。512px・G=16 の比較では、因果AR が GenEval 0.8386 でヘッド遅延6.44秒、並列方式が0.7800で1.77秒に対し、半自己回帰は0.8253を3.41秒で達成しました。品質をほぼ保ったまま計算量を半減できた形です。
実験結果
テキストからの画像生成では5種のベンチマークで評価されています。GenEval と DPG-Bench は指示追従性、PRISM は総合品質、LongText-Bench は画像内の長い文字列の描画精度を測るものです。
モデル | GenEval | DPG | PRISM | LongText | Qwen-Image-Bench |
|---|---|---|---|---|---|
GSTAR-Pro-8B | 0.84 | 83.38 | 6.98 | 0.935 | 50.07 |
GSTAR-Flash-1.7B | 0.76 | 80.18 | 6.81 | 0.853 | 46.88 |
Qwen-Image | 0.87 | 88.32 | 7.41 | 0.943 | 49.23 |
Emu3.5 | 0.86 | 88.26 | 7.52 | 0.976 | 49.89 |
Qwen-Image-Bench では Pro-8B が最も高いスコアを示しましたが、DPG-Bench と PRISM では Qwen-Image と Emu3.5 に届いていません。画像編集の GEdit-Bench でも Pro-8B の総合7.45は Emu3.5 の7.59、Qwen-Image-Edit の7.56をわずかに下回ります。深い圧縮と引き換えに品質上限がやや下がっている状況です。
速度面では、1024×1024の生成が H200 1枚あたり約2.5秒という値が報告されています。この数字は因果AR をベースラインとした22.23秒から、半自己回帰ヘッドで14.93秒、CUDA Graph で5.85秒、Triton のカーネル融合で3.37秒、SGLang で2.50秒へと段階的に短縮した結果で、合計8.9倍の高速化にあたります。アブストラクトにある「従来の離散自己回帰モデル比20倍」という表現は他モデルとの直接比較ではなく、自前ベースラインとの比較が根拠になっている点は読み分けが必要でしょう。
課題とまとめ
残る課題も結果から読み取れます。グループサイズを大きくすると学習初期の収束が遅くなり、ImageNet では G=16 が G=8 を上回るのは約25,000ステップ以降でした。また実効64倍へのパッキングは生成スコアを押し下げており、GenEval は0.8060から0.7885、DPG は82.49から80.44へ低下しています。圧縮の深さと品質の交換は完全に解消されたわけではありません。
とはいえ、空間圧縮率とグループサイズを同時に設計するという指針は明快で、トークナイザの設計に定量的な基準を与えた点に価値があります。離散自己回帰モデルの生成速度が拡散モデルと競合できる水準に近づいたことは、理解と生成を1つの系列モデルで扱う方向の実用性を押し上げる材料になります。
論文情報: "G-STAR: Group-Scaled Token Capacity for Deeply Compressed Autoregressive Generation"(Xu Huang et al., 2026) arXiv:2611.13004, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


