 AI-Papers
- Googleが2026年11月11日にGemini Decisions APIを公開し、文章を生成せず選択肢をスコアリングする新モデル gemini-decision-1 を提供開始
- エンドツーエンド150〜250msで応答し、1リクエストで最大1000問を評価。入力100万トークン$0.10で出力課金はなし
- 共通ベンチマーク群でGemini 3.5 Flash-Lite+Interactions APIの構成と比べ約5分の1のコストとGoogleは説明
生成せずに選ぶモデル
Googleは2026年11月11日、クローズドセット(選択肢があらかじめ決まっている)の判断に特化した Gemini Decisions API を公開しました。モデル名は gemini-decision-1 で、Gemini API と Google AI Studio から利用できます。
通常の Large Language Model(LLM)は答えをテキストとして書き出しますが、このモデルは候補となる選択肢を1回のパスでスコアリングします。文章生成を省くため、エンドツーエンドのレイテンシは150〜250ms、モデル計算部分の中央値は50〜100msに収まります。質問数を1問から100問に増やしてもレイテンシはほぼ横ばいだとしています。
想定用途として挙がっているのは、エージェントのツール選択、ポリシー判定、モデルルーティング、コンテキストの採点です。いずれも従来は生成モデルに短い答えを書かせて正規表現などで取り出していた処理で、エージェント基盤では定番の中間処理にあたります。
3種類の質問形式
質問は3つの型で記述します。Yes/No を扱う noul は条件が成り立つ確率を返し、真と偽それぞれの判定基準を文章で添えられます。choice は2〜255個の選択肢から勝者と各選択肢の正規化済み確率を返し、score は0から始まる順序付きルーブリックに対する重み付きスコアと各段階の確率を返します。
各回答には0〜1の信頼度が付きます。アプリ側のコードは、値が低いケースだけをフォールバック処理や人間のレビューに回せるため、LLM-as-a-Judge(LLMによる採点)やガードレールの実装で「曖昧なものは人に戻す」設計を素直に書けます。
入力はテキスト、画像、音声、動画、PDFに対応し、合計256Kトークンまで1つの共通入力にまとめられます。通話録音とアカウント情報、あるいはスキャンした保険請求PDFと損傷写真といった組み合わせを、1回のリクエストで突き合わせる使い方が示されています。画像と動画は解像度を調整して、視覚的な細かさとトークン量を釣り合わせられます。
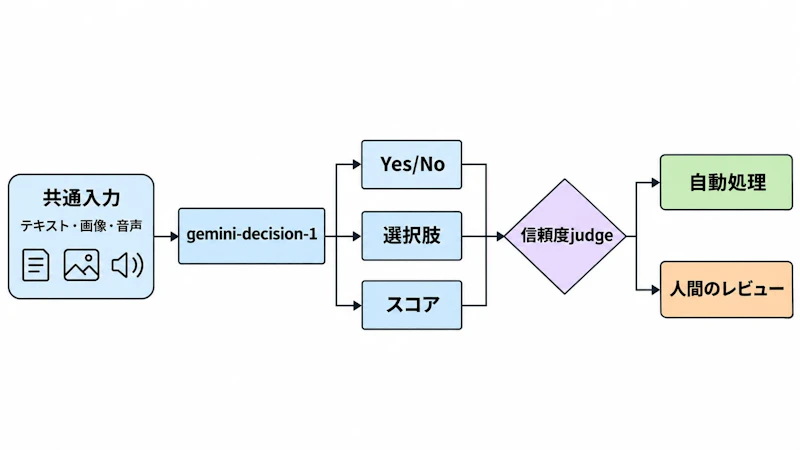
図1のように、共通入力の処理は1回で済み、質問ごとに加算されるのは各質問の指示と基準のトークンだけです。共通入力の課金もリクエストあたり1回のみで、思考トークンや音声の文字起こし、OCRに別料金はかかりません。
料金とレイテンシ
主な仕様と料金は次の通りです。プロトタイピング向けに Google AI Studio の無償枠も用意されています。
項目 | gemini-decision-1 |
|---|---|
入力料金 | 100万トークンあたり$0.10 |
出力料金 | 課金なし |
レイテンシ | 150〜250ms(計算部分の中央値50〜100ms) |
1リクエストの質問数 | 最大1000問 |
入力上限 | 256Kトークン(マルチモーダル混在可) |
Googleは、エージェントのルーティング、推論、ランキング、マルチモーダル理解を含むベンチマーク群で同モデルが最も優れ、キャリブレーション誤差(確率の確かさのずれ)が最小だったと述べています。同じベンチマーク群での比較では、Gemini 3.5 Flash-Lite を Interactions API で使う構成に対して約5分の1のコストになるとしています。小型モデルでエージェントの運用費を下げる流れは、Metaが最小モデルMuse Emberを発表、コストを約17分の1にでも同じ方向で進んでいます。
Google社内での適用例
公開時点で、Google自身の製品にも組み込まれています。
- Gemini Notebook — 問い合わせを適切なモデル階層に振り分けるリアルタイムルーターとして使い、日常的な質問で最大40%のレイテンシ削減
- Stitch — 操作可能なワイヤーフレームを生成し、音声やタップによる編集を反映
- CC(Google Labs) — 200種類以上の候補から絵文字リアクションを選択
- Google Search — MCPツールの安全層として、敵対的な挙動を検知
いずれも「短い判断を大量かつ低遅延で回す」という共通点があります。モデルルーティングや安全層のように、ユーザーの待ち時間に直接乗る処理での採用が目立ちます。
提供範囲と周辺対応
入力は Interactions API と同じ Content ブロック形式を使うため、既存の呼び出しコードからの移行は比較的容易です。ドキュメントは Python、JavaScript、REST の各ガイドが用意され、Doorstep Parcels、Speed Sketch、Find the Zoo Keeper というデモアプリも公開されています。Gemini in Google Cloud での対応は近日提供とされています。
周辺エコシステムの対応も順次進んでおり、google-genai SDK に加えて次のツールやフレームワークとの統合が案内されています。
- OpenRouter
- LangChain
- Vercel
- LiteLLM
- Pydantic AI
- Pipecat
- LiveKit
- OpenCode
既存のエージェント実装では、ツール選択や入力チェックのために汎用モデルを呼ぶコストと待ち時間が積み上がりがちです。判断だけを切り出す専用エンドポイントが標準の選択肢になれば、ガードレールや採点処理の設計を見直す余地は広がります。


