 AI-Papers
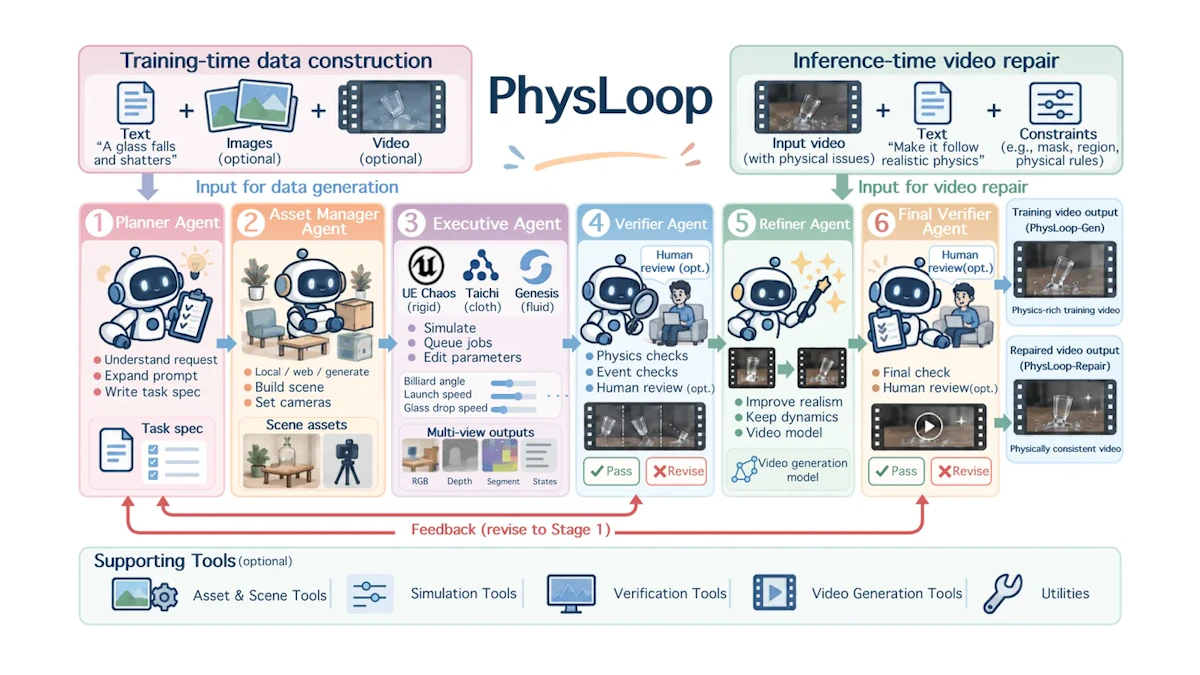
- LLMをコードエージェントとして物理シミュレータや検証器と組み合わせ、物理的に整合した動画を作るループ型フレームワーク PhysLoop が提案されました
- 生成タスクの成功率は85%(Seedance 2.5 単体は73%)、動画中の物理破綻の局所修復では86.00%対19.33%と大きな差が出ています
- 約10万本の動画データ PhysLoop-100K と2種の評価セットが整備され、コードも公開されている一方、視覚的な見栄えは単体モデルに劣ります
研究の背景
動画生成モデルの出力は、1コマだけ見れば写真と見分けがつかないほど自然になりました。しかし動きを追うと、物が落ちる速さが不自然だったり、衝突したのに跳ね返らなかったり、原因と結果の順序が入れ替わっていたりという破綻が頻繁に残ります。
こうした物理の誤りを学習で直すには、細かい物理的教師信号が必要です。ところが「この動画の物理は正しいか」という信頼できる判定、誤った動画と直した動画の対、条件だけを変えた比較用の動画といった素材は、人手で集めるのが極めて難しいという事情があります。
PhysLoop を提案した論文(Yuxuan Chen らによる PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models)は、この素材不足を Large Language Model(LLM)の物理知識とシミュレータで埋めようとしました。モデルを再学習するのではなく、推論時に外部ツールを回すという発想は、3Dシーンのコード生成で物理整合性を高めたVideo-Coderと近い系譜にあります。
PhysLoopの仕組み
PhysLoop の中心にいるのはコードエージェントで、既定の構成では GPT-6 Astra が担います。エージェントは自由に振る舞うのではなく、ハーネスと呼ばれる道具立てによって手順と判定基準を制約されます。
ハーネスが提供する機能は次のとおりです。
- タスク管理(目標イベントと前提条件、検証条件の記録)
- アセット取得とシーン生成(適切な3Dモデルがなければ Meshy で生成)
- シミュレータ実行(主に Unreal Engine、補助に Taichi と Genesis)
- 検証器(目標イベントが満たされたかの判定)
- 動画リファイナー(既定は Seedance 2.5)
処理はおおむね次の順に進みます。エージェントはまず「どんな現象を起こすか」「落下高さなど何を仮定したか」を明文化し、物体を配置するシーンプログラムを書きます。低解像度のプレビューで配置と見え方を確かめた上で本番のシミュレーションを行い、RGB画像に加えて深度、インスタンス分割、物体の状態、接触イベントを出力します。
シミュレーション結果が検証を通ったら、その映像を動きの参照として Seedance 2.5 が見た目を作り直します。図1に示すように、検証で失敗した場合は検証器が根拠を返し、エージェントは問題のある段階だけをやり直します。目標と判定基準は途中で変えないため、基準を甘くして通すという抜け道が封じられています。
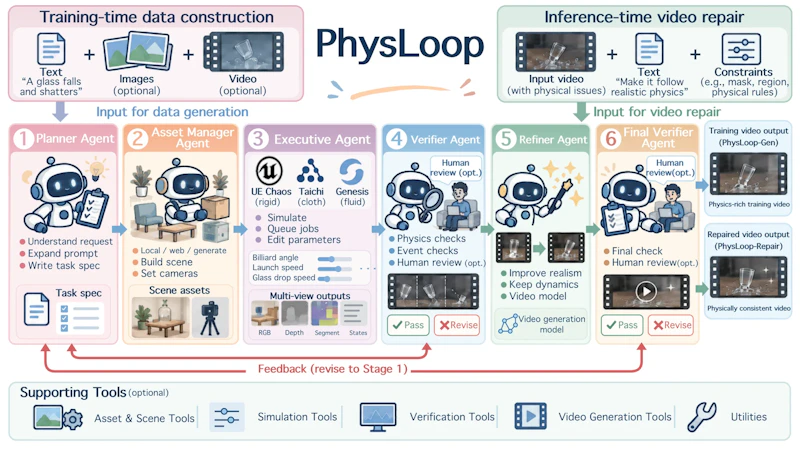
動画生成の呼び出しは1タスクあたり最大5回で、予算を使い切っても解決しない失敗は記録として残されます。修復モードでは、エージェントが誤りとその発生区間を特定し、その区間だけを作り直して元の動画に差し戻し、最後に全体を再検証します。
公開データと評価セット
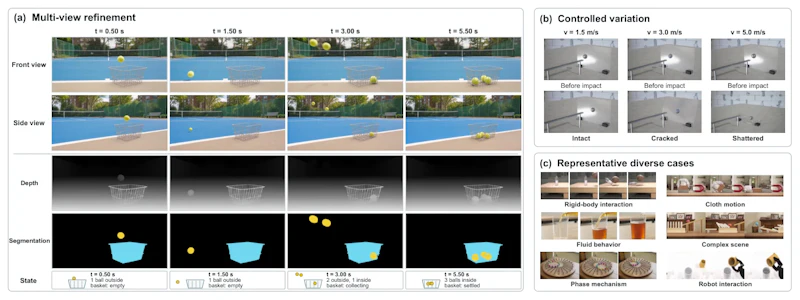
このループを約2500件の物理イベントに適用して作られたのが PhysLoop-100K です。1イベントあたり約40本、3〜5視点の映像が含まれ、剛体、磁性、流体、弾性体、破壊といった現象をカバーします。
図2のように、多視点・深度・分割・物体状態が揃っているほか、条件を少しずつ変えた変化版も用意されています。同じ現象で初期条件だけが違う組を持てることは、物理の因果を学ばせる上で扱いやすい性質です。
評価用には、生成能力を測る PhysLoop-Gen(100タスク。剛体68、布12、流体9、画像条件付き11)と、修復能力を測る PhysLoop-Repair(50タスク。Seedance、MiniMax H3、Gemini Omni が生成した動画を素材とする)が作られました。外部ベンチマークの Physics-IQ Verified では、単一視点の66ケースを診断用に使っています。
実験結果
主要な比較結果は次の表のとおりです。人手評価は1〜5の5段階です。
評価項目 | PhysLoop | Seedance 2.5 単体 |
|---|---|---|
PhysLoop-Gen 成功率 | 85% | 73% |
PhysLoop-Repair 成功率 | 86.00% | 19.33% |
物理的妥当性(人手) | 4.06 | 3.80 |
因果の一貫性(人手) | 4.12 | 3.80 |
視覚的リアリズム(人手) | 3.72 | 4.29 |
Physics-IQ Verified | 52.06 | 48.07 |
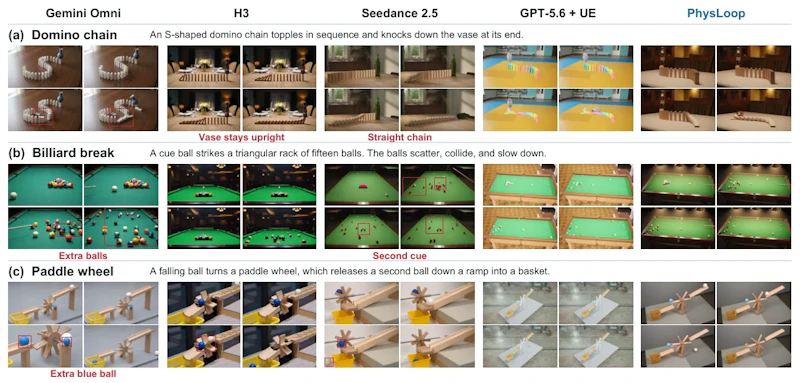
差が最も大きいのは修復で、単体のモデルはいずれも20%を下回りました(Gemini Omni 14.67%、MiniMax H3 18.00%)。テキストで「ここが物理的に間違っているので直して」と伝えるだけでは、生成モデルが誤りを捉え直せないことを示す結果です。図3では、ベースラインとの違いが実際のフレームで比較されています。
一方で、見栄えは犠牲になっています。視覚的リアリズムでは Seedance 2.5 単体が上回り、VideoPhy の PC/SA や VBench の AQ といった自動指標でも単体が優勢でした。著者はこれらの自動指標を補助的な参考値と位置づけています。
構成要素の寄与も検証されました。リファイナーを外して GPT-6 Astra とシミュレータだけで動かすと生成80%、修復60.67%、リアリズム2.59にとどまり、Seedance 2.5 による仕上げを加えることで85%と86%に伸びています。リファイナーを MiniMax H3 に替えると生成73%・修復72.67%、Gemini Omni では67%・62%でした。バックボーンを替えた場合は Claude Opus 5 が71%・78.67%、Physics-IQ Verified では53.75で比較中最高を記録し、Kimi K3 は69%・68.67%でした。
限界と今後
成果はシミュレータ、3Dアセット、検証項目の網羅性に依存します。現象の再構成は幾何形状や材質、初期状態の仮定に支えられているため、仮定が現実とずれれば結果もずれます。
修復にも限界があります。仕上げの工程で新たな誤りが入ることがあり、誤りがすでに後続のイベントを変えてしまっている場合は、区間を差し替えるだけでは足りません。判断が曖昧な事例では人の確認が必要になります。
タイトルが掲げる自己改善についても、生成したデータでモデルを学習し直して継続的に伸びるというループ全体は、まだ実証されていません。未見の現象で効果が持続するか、計算コストを抑えられるか、品質判定を誤ったときにどう扱うかは今後の課題として残されています。人手評価も回答19件、対比較301件を著者1人が非ブラインドで行ったパイロット規模であり、結果の読み方には幅を持たせる必要があります。
とはいえ、物理整合性という動画生成の難所に対し、再学習ではなく推論時のツール利用と検証ループで迫る設計は、手元の環境に組み込みやすい現実的な方向です。コードとデータが公開されていることもあり、どの工程がどれだけ効くかを他の構成で検証しやすい研究だと言えます。
論文情報: "PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models"(Yuxuan Chen et al., 2026) arXiv:2611.16748, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


