 AI-Papers
- タスク報酬の低周波成分をスキル選択の、高周波変動成分を蒸留の信用割り当てに使い分ける独自設計
- ALFWorldで97.5%の成功率(先行最高比+2.6pt)、WebShopでも89.7スコア・82.9%成功率を達成
- 選択・実行・蒸留の3能力が単一ポリシーで同期して向上する「共進化」ダイナミクスを実験で確認
研究の背景
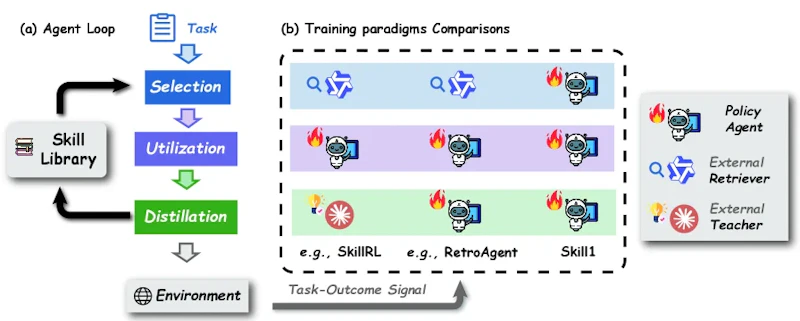
LLM(大規模言語モデル)を搭載したAIエージェントが複雑なタスクをこなすうえで、スキルライブラリの活用が注目されています。スキルライブラリとは、過去の成功経験から抽出した再利用可能な行動パターンの集合です。エージェントはライブラリから適切なスキルを選んで(選択)、それを参照しながらタスクを実行し(実行)、新たな経験から有用なスキルを抽出してライブラリに追加する(蒸留)という3段階のサイクルで能力を拡張していきます。
しかし従来の手法では、この3段階がそれぞれ別々のモジュールや目的関数で最適化されていました。たとえば選択は外部の検索システムに任せ、蒸留は教師ありの外部モデルで行うといった設計が一般的です。この分離した最適化は、各段階が異なる目標を追いかけることで生じる「目標のずれ」という根本的な課題を抱えていました。
Skill1の提案手法
北京大学らの研究チームが提案するSkill1は、選択・実行・蒸留の3能力を単一の強化学習ポリシーで同時に学習するフレームワークです。学習に使うシグナルはタスクの成否を示す1つの報酬 r(τ) のみで、これを巧みに分解して3段階それぞれの信用割り当てに活用します。
具体的には、各スキルに対する過去の報酬の指数移動平均(EMA)を「低周波トレンド」として計算し、スキル選択の品質評価に用います。エージェントが生成した選択順序と、このトレンド値に基づく理想的な順序との乖離をNDCG(正規化割引累積利得)で測り、選択の精度を直接鍛えます。一方、現在の経験がライブラリ内の最良スキルを上回ったかどうかを示す「高周波変動」は蒸留の信号として使います。既存スキルより優れた経験のみを蒸留の対象とすることで、ライブラリへの質の低いスキルの混入を防ぎます。
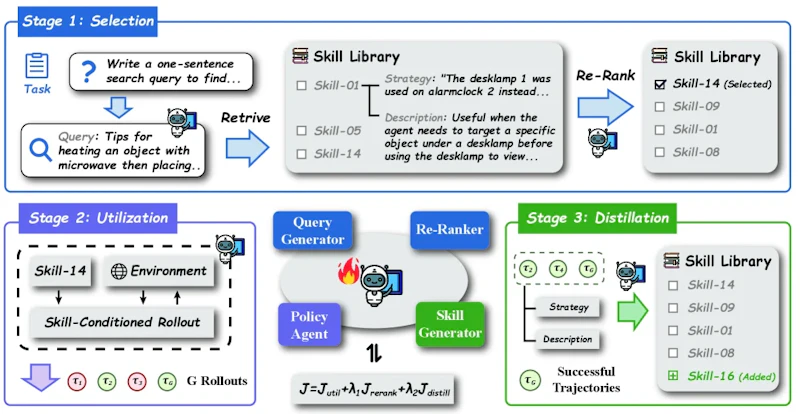
3つの損失関数は加重和で最終的な学習目標を構成します。利用(実行)は直接タスク報酬を受け取り、選択はNDCGベースの損失、蒸留は高周波変動シグナルを受け取ります。この設計により、3つの能力が共通の目的関数のもとで互いに強化し合う「共進化」が実現します。なお強化学習アルゴリズムにはGRPO(グループ相対方策最適化)を採用しており、スキル選択・蒸留の損失をGRPOの目的関数に統合する形で実装されています。
実験結果
Skill1の性能は、家庭内作業シミュレーターALFWorldとオンラインショッピングエージェントベンチマークWebShopの2つで検証されました。ALFWorldでは6種類のタスク(物の把持、熱処理、冷却など)にわたり平均97.5%の成功率を達成し、先行スキルベース手法のRetroAgent(94.9%)を2.6ポイント上回りました。WebShopでも89.7のスコアと82.9%の成功率を記録し、比較した手法の中で最高の結果を示しています。
アブレーション(要素削除)実験からは、各コンポーネントの重要性が明確に示されました。スキルライブラリを完全に取り除くと成功率が80.9%まで落ち込み(-16.6pt)、蒸留なしでは92.4%(-5.1pt)、選択なしでは91.8%(-5.7pt)となりました。選択と蒸留の損失を両方ゼロにすると90.2%まで低下し、2つの信号が互いに補強し合っていることが裏付けられています。
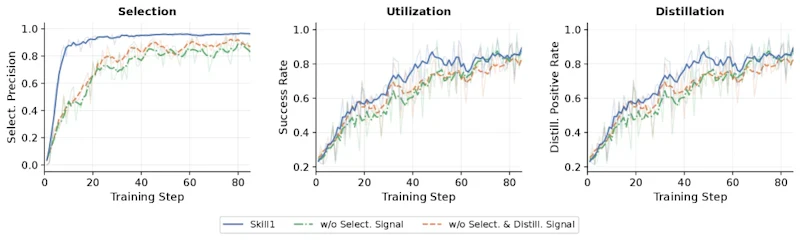
学習の過程でスキルライブラリ自体も質的に向上しました。タスクとスキルの類似度スコアは学習を通じて0.51から0.60に上昇し、ライブラリ内の上位スキル活用率も0.91まで達しました。T-SNE可視化では、Skill1のスキルライブラリは利用頻度の高いスキルがより広い戦略空間に分散しており、多様な状況に対応できる質の高いスキルが蓄積されていることが確認されています。
まとめと今後の展望
Skill1は、スキルを活用するエージェントの選択・実行・蒸留という3つの能力を、単一の報酬シグナルを周波数で分解することで同時に最適化する手法です。外部の教師モデルや固定モジュールに頼らず、単一ポリシーがすべてを担うシンプルな設計でありながら、複数のベンチマークで既存手法を超える結果を出している点が評価されています。
一方で、計算コストは素のGRPOと比べて1.3〜1.7倍程度増加します。また現状のスキルライブラリ管理では、古いスキルの退避(eviction)にヒューリスティックな規則を用いており、ライブラリの規模が大きくなった場合のスケーラビリティは今後の課題として残されています。エージェントが自律的にスキルを獲得・洗練・再利用するサイクルを単一ポリシーで実現するこのアプローチは、マルチタスクエージェントの設計原則として広く応用が期待されます。
論文情報: "Skill1: Unified Evolution of Skill-Augmented Agents via Reinforcement Learning"(Yaorui Shi et al., 2026) arXiv:2605.06130
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


