 AI-Papers
- 複数のAIモデルをリクエストの難易度に応じて動的に選択・連携させるマルチエージェントシステムで、外部にはシングルAPIとして見える設計
- 上位版Fugu UltraはTerminal-Bench 2.1でFable 5、Charxiv ReasoningでClaude Mythos Previewを上回るベンチマーク結果をSakana AIが公表
- 個人向け月額20ドルから提供。規制変化に伴うモデル停止リスクに備えた内部切替機能も主要な設計上の特徴
Sakana Fuguとは何か
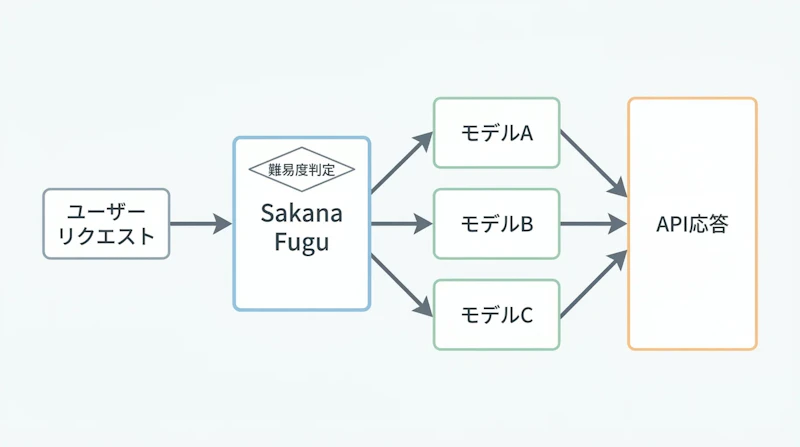
Sakana AIは2026年6月22日、複数のAIモデルを動的に組み合わせるマルチエージェントシステム「Sakana Fugu」を発表しました。単一の大規模モデルに依存する従来の手法とは異なり、ユーザーのリクエストの内容や難易度に応じて最適なモデルを自動選択します。
簡単なタスクなら軽量モデルで処理し、複雑な問題には複数のエージェントを協調動作させる仕組みです。外部から見るとシングルAPIとして振る舞うため、内部でどれだけ多くのエージェントが稼働していても、ユーザー側の実装に変更は不要で、既存のAPIインテグレーションをそのまま流用できます。
この「集合知」アーキテクチャは、個々のモデルが持つ得意領域を組み合わせることで、単一モデルでは難しいタスクへの対応を目指しています。
2つの製品と価格体系
製品は「Fugu」と上位版「Fugu Ultra」の2バージョンで提供されます。個人向けサブスクリプションは次の3段階で、いずれのプランでも両バージョンを利用できます。
プラン | 月額料金 |
|---|---|
Standard | 20ドル |
Pro | 100ドル |
Max | 200ドル |
法人向けには従量課金制が用意されており、複数エージェントが稼働した場合は最上位モデルのレート料金が適用されます。ユーザーが意識しなくても内部コストは動的に変化するため、実際の利用費用の見積もりには注意が必要です。
評価指標の結果と主張
Sakana AIはFugu Ultraの性能について、複数の評価指標でフロンティアモデルを上回ると主張しています。コーディングとエージェント評価の「Terminal-Bench 2.1」、数学的推論を問う「Charxiv Reasoning」、広範な知識と推論を問う「Humanity's Last Exam」の3指標について、同社は次の結果を公表しました。
評価指標 | 比較対象モデル | Fugu Ultraの結果 |
|---|---|---|
Terminal-Bench 2.1 | Fable 5 | 上回る |
Charxiv Reasoning | Claude Mythos Preview | 上回る |
Humanity's Last Exam | Fable 5 | 及ばない |
Humanity's Last Examで及ばない点も同社が公表しており、すべての指標で優位なわけではありません。エージェントとしてのモデル評価は多角的な検証が求められる領域であり、得意・不得意のある性能プロファイルを正確に把握した上で導入を検討する必要があります。
規制リスクへの対応
Sakana AIがこのアーキテクチャを採用した背景には、AIをとりまく規制環境の急速な変化があります。Anthropicが2026年6月10日に提供を開始した「Mythos 5」は、わずか3日後に米政府の命令で提供停止となりました。特定のモデルへの依存度が高いシステムでは、このような事態がそのままサービス停止につながりかねません。
Sakana Fuguは内部で使用するモデルを柔軟に入れ替えられる構造を持ちます。あるモデルが規制や契約上の問題で利用できなくなっても、別のモデルで補完できるため、サービス継続性を保ちやすくなっています。地政学的リスクや輸出規制が現実の問題となる中で、Sakana AIはこのモデル切替機能を主要な設計上の特徴として位置づけました。
単一モデル依存からの脱却
Sakana Fuguのアプローチは、AI開発の一つの方向性を示しています。「より大きなモデルを一つ作る」路線の代わりに、「複数の専門モデルを組み合わせて実効性能を高める」手法は、コスト効率の観点からも注目を集めています。
単純なリクエストには軽量モデルを使い、複雑なタスクにのみ大型モデルを起動すれば、全体の計算コストを抑えられる可能性があります。東京を拠点とするスタートアップであるSakana AIは、今回のSakana Fuguでも単一の大規模モデルを新たに開発するのではなく、既存の複数モデルを組み合わせて運用する構成を選んでいます。


