 AI-Papers
- 解説動画から実際の作業手順を復元し、コンピュータ操作エージェントの学習データを作る枠組み CUA-Master が提案されました
- 外側ループでモデルの弱点をデータ生成に還流させ、内側ループで操作部品から検証可能なタスクを増やす二重構造が特徴です
- 27B モデルで OSWorld Verified 80.2、OSWorld 2.0 36.9、Agents' Last Exam 25.0 を記録し、同規模の既存モデルを上回りました
研究の背景
画面を見てマウスやキーボードを操作し、人間の代わりにパソコン作業をこなす仕組みを Computer-use Agent(CUA、コンピュータ操作エージェント)と呼びます。文章生成と違い、こちらは実際のアプリを動かして結果を出す必要があるため、学習に使える「操作の軌跡」データが決定的に不足しています。
人手で軌跡を集めると高価でカバー範囲も狭く、モデル自身に試行させて集めると、すでにできることばかりが増えて伸びが鈍る(収穫逓減)という問題が起こります。さらに、合成したタスクは「本当に成功したのか」を自動判定できなければ学習信号になりません。
著者らは、この行き詰まりを次の3点に整理しています。
- データが狭い(限られたアプリと定型的な操作に偏る)
- データを制御しにくい(難易度や対象を狙って作れない)
- 成否の検証ができず、学習信号として信頼できない
CUA-Master はこの3つに同時に手を入れる設計です。鍵になるのは、人間がすでに大量に公開している操作の記録、つまりソフトウェアの解説動画を学習資源として使い直す発想にあります。
提案手法
CUA-Master は入れ子になった二重のループで回ります。外側は「世界・データ・モデル」のフライホイールで、学習したモデルの弱点を観測し、その弱点を埋めるように次のデータ構築と学習を方向づけます。内側はデータ生成そのもののループで、2つの仕掛けから成ります。
1つ目はオープンワールド種付けです。チュートリアル動画に対し、画面の映像と字幕という2経路から意味を突き合わせ、どの画面で何を操作したかという軌跡を復元します。これにより、人間が実務で踏む自然な手順が種タスクになります。
2つ目は自己触媒的増殖です。復元した軌跡を「ファイルを開く」「書式を変える」といった再利用可能な操作プリミティブ(部品)に分解し、部品を組み替えて新しいタスクを合成します。部品単位なら達成条件も書けるため、自動検証がしやすくなります。図1がこの二重ループとデータ生成の流れを示しています。
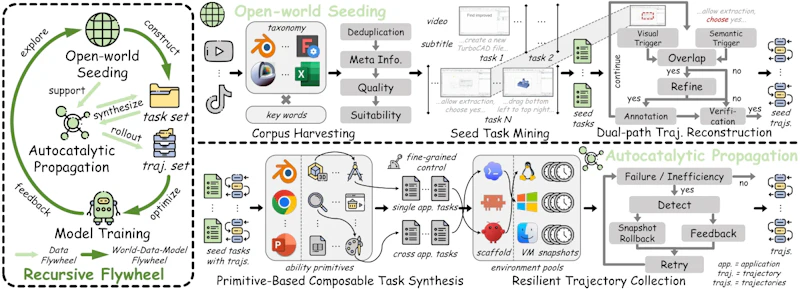
実環境で軌跡を集める段では、失敗したらやり直しという素朴な方法を取りません。検証器のフィードバックをもとに、失敗の直前状態のスナップショットまで巻き戻して再開する仕組みを使います。長い手順の途中で一度つまずいただけで全体を捨てずに済むため、収集効率が大きく変わります。
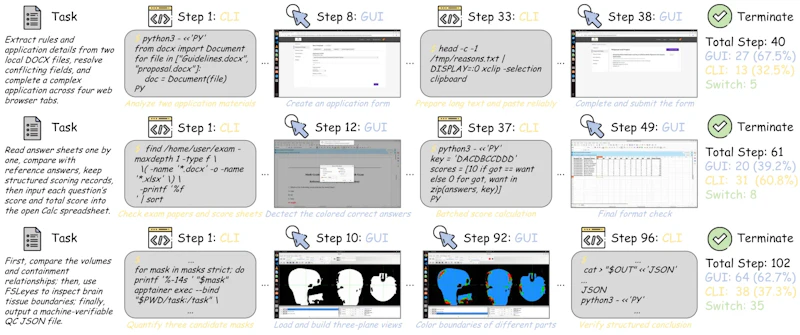
操作の仕方も GUI だけに限らず、コマンドライン(CLI)を混ぜた混成の行動空間を採用しています。図2は GUI と CLI を組み合わせた実行例で、画面操作が苦手な処理をコマンドで片付ける様子がわかります。
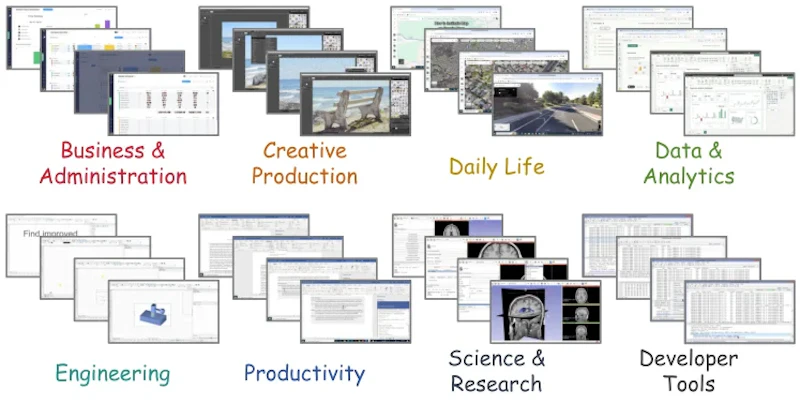
データ全体は 8 ドメイン、36 サブドメイン、650 以上のアプリケーションを対象とし、最終的に 127K サンプル(教師ありファインチューニング用 115K、強化学習用 12K)になりました。ドメインは業務・事務が 18.4%、クリエイティブ制作が 16.5%、日常生活が 13.4% と、業務寄りのタスクが中心です。図3は選ばれた 8 ドメインの代表的なアプリを示したものです。学習可能なタスクを大量に作る発想は、職業タスクの合成を扱ったWorkFactoryとも共通します。
学習のベースモデルは Qwen-3.5-27B です。各反復では同じ初期チェックポイントから、累積したデータ(63K、38K、14K タスクを足していく)で教師ありファインチューニングをやり直し、最後に検証器の成否を報酬とする GRPO 系の強化学習を行います。
実験結果
完成した CUA-Master-27B は、GUI のみのベンチマークと GUI と CLI の混成ベンチマークの両方で評価されました。主要な数値を既存モデルと並べます。
モデル | OSWorld Verified | OSWorld 2.0 | WeaveBench | Agents' Last Exam |
|---|---|---|---|---|
CUA-Master-27B | 80.2 | 36.9 | 43.9 | 25.0 |
Qwen-3.8-27B | 81.2 | 36.5 | 52.6 | - |
UI-Mate-27B | 77.6 | 24.0 | 18.3 | 13.2 |
Qwen-CUA-397B | 84.0 | 43.6 | 35.1 | 21.1 |
Claude-Opus-5(クローズド) | 86.3 | 64.2 | 55.7 | 28.3 |
同じ 27B 規模の UI-Mate-27B に対しては、4 つのベンチマークでそれぞれ 2.6、12.9、25.6、11.8 ポイントの上積みがあります。10 倍以上大きい Qwen-CUA-397B に対しても WeaveBench と Agents' Last Exam では上回りました。一方で、WeaveBench では Qwen-3.8-27B の 52.6 には届いていません。
外側ループの効果もはっきり出ています。反復を重ねるごとに 4 ベンチマークすべてが改善し、OSWorld Verified と WeaveBench はいずれも 25 ポイント以上伸びました。最後の強化学習段では OSWorld 2.0 と Agents' Last Exam がさらに約 15 ポイント上がっています。
混成行動空間の寄与も大きく、WeaveBench では GUI のみの 6.6、CLI のみの 11.5 に対し、混成が 43.9 でした。しかも GUI のみより手数が 23.8% 少なく、OSWorld 2.0 では 43.8% 少ない手数で同等の成績に達しています。スナップショット巻き戻しについては、50 個のプリミティブと 8 アプリを跨ぐ難しい設定で、やり直し方式の成功率 0.0% に対し 18.7% を確保しました。
まとめと今後の展望
CUA-Master の要点は、操作データの「量」だけを追わず、動画からの実手順の採掘、部品化による制御可能な合成、そして検証器に基づく巻き戻し再開という形で「検証できる量」を増やしたところにあります。コードと CUAMaster-27B の重みが公開されており、27B という手元で扱える規模で上位モデルに迫った点も実用上の意味を持ちます。
ただし著者ら自身が、大規模な仮想マシン操作と軌跡収集、反復学習にかかる計算・インフラコストの高さを限界として挙げています。合成データの質が強力なアノテータモデルに依存する点も、そのまま再現しようとする側には推論コストという壁になります。トップのクローズドモデルとの差、とくに OSWorld 2.0 での開きも残っており、データ生成の効率化が次の論点になるでしょう。
論文情報: "CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements"(Xinlei Yu et al., 2026) arXiv:2611.03126
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


