 AI-Papers
- 統合マルチモーダルモデルが思考の連鎖を活かせない原因を、離散トークンでの推論と連続空間での画像生成のズレと特定した研究です
- LARCは隠れ状態をそのまま次の入力に戻す潜在推論を導入し、GenEvalで0.88(BAGELは0.81)を達成しました
- 正解の推論過程を用意せずに学習できる情報利得報酬を使い、best-of-Nより約10分の1の時間でテスト時スケーリングを実現しています
研究の背景
画像の理解と生成を1つのモデルでこなす統合マルチモーダルモデル(Unified Multimodal Model、以下UMM)は、ここ1年で性能を大きく伸ばしてきました。一方で、大規模言語モデル(Large Language Model、LLM)の世界で成果を上げた思考の連鎖(Chain-of-Thought、答えを出す前に途中の考えを言語で書き出す手法)を画像生成に持ち込んでも、期待したほど効かないことが知られています。
NeurIPS 2026に採択されたこの論文(arXiv:2610.42149、Byungwoo Jeonら、KAIST・POSTECH)は、その原因をモダリティのミスマッチに求めています。推論は離散的なテキストトークンの空間で進むのに、画像生成はフローマッチングによる連続空間で進みます。言葉で「赤い帽子をかぶった犬を左に置く」と書き出したところで、その情報は生成側が扱う連続的な表現にうまく渡りません。
そこで提案されたのがLARC(Latent Reasoning in Continuous space)です。テキストトークンを経由せず、モデル自身の連続的な隠れ状態の上で推論を進めることで、生成側とフォーマットを揃えるという発想になっています。統合モデルの設計をめぐる別のアプローチとしては、動画モデルの時間知識を画像生成に流用するFrameForgeのような研究も登場しており、UMMの構成要素をどう組み替えるかは活発な論点です。
提案手法
LARCはBAGEL(理解担当と生成担当のエキスパートを分けたUMM)をベースに構築されています。推論の軌跡は、テキストの断片と潜在ステップが交互に並ぶ形を取ります。<latent>トークンが現れると潜在モードに切り替わり、最終層の隠れ状態がそのまま次の入力埋め込みとして戻される仕組みです。
生成側の画像モジュールは、この隠れ状態の列をクロスアテンション(別の系列の情報を参照する仕組み)で読み取ります。言語に落とさずに推論結果を渡せるため、思考の内容が途中で失われにくくなります。構成要素を整理すると次のようになります。
- 交互軌跡 — テキスト断片と潜在ステップを交互に並べ、言語の足場を残す
- 隠れ状態の自己入力 — 最終層の出力を次の入力埋め込みに再投入する
- クロスアテンション接続 — 潜在軌跡を画像生成モジュールへ直接渡す
- 多様性報酬 — 潜在ステップ同士が似通って潰れるのを防ぐ
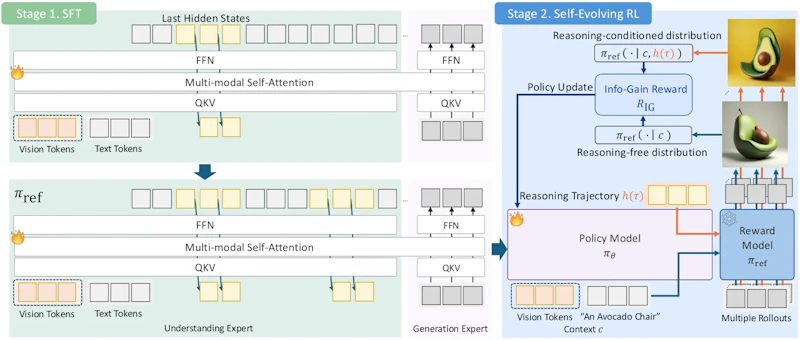
図2が全体像です。第1段階で教師ありファインチューニング(SFT)を行い、第2段階で強化学習(RL)によって潜在推論を磨き上げる二段構成になっています。
二段階の学習手順
第1段階はカリキュラム方式のSFTです。約100万件の交互型思考連鎖データを用意し、ステップの境界に<latent>を挿入します。フェーズ0ではテキストのみで学習し、フェーズkでは先頭からk個の潜在ステップを有効化するという具合に、言語による推論を少しずつ潜在状態へ移していきます。フェーズが切り替わるたびに学習率を下げる設計です。損失はテキストの次トークン予測と目標画像のフローマッチング損失の組み合わせで、潜在ステップ自体には直接の教師信号を与えません。
第2段階の鍵は情報利得報酬です。潜在軌跡を与えたときの画像の対数尤度と、与えないときの対数尤度の差を報酬とします。尤度そのものは直接計算できないため、同じノイズを共有した条件下でフローマッチング損失の差として近似しています。この設計なら「正解の推論チェーン」を人間が用意する必要がありません。隠れ状態は人間が読める空間に存在しないため、そもそも注釈を付けられないという事情もあります。
ただし報酬がこれだけだと、潜在ステップがほぼ同一のベクトルに収束する崩壊が起きます。論文のアブレーションでは、多様性報酬を外した場合に潜在ステップ間の平均コサイン類似度が0.97まで上がり、MIRAスコアが11.7から9.8へ落ちました。最適化はGRPO(グループ単位で相対的に優劣を比較する強化学習手法)で、グループサイズ8、約1000ステップという規模です。
実験結果
テキストからの画像生成、画像編集、マルチモーダル理解の3領域で評価されています。主要な数値をベースラインのBAGELと並べると次のとおりです。
ベンチマーク | LARC | BAGEL |
|---|---|---|
GenEval(全体) | 0.88 | 0.81 |
GenEval(属性結合) | 0.78 | 0.63 |
DPG-Bench | 90.04 | 85.07 |
OneIG-Bench | 0.866 | 0.764 |
MIRA(視覚推論) | 11.7 | 7.5 |
MMBench | 88.1 | 85.0 |
GenEvalの0.88はGPT-4oの0.84やUni-CoTの0.83を上回る水準で、特に属性結合(どの色がどの物体に付くかを正しく描く能力)が0.63から0.78へと大きく伸びました。画像編集のCompBenchでもPSNRが24.370から25.710に、LPIPSが0.069から0.049へ改善しています。
推論空間を比べたアブレーションの結果は、この論文の主張を裏付けるものになっています。トークン単位の推論を入れてもベースラインからほとんど改善せず、MIRAはむしろ7.5から7.1へ下がりました。潜在推論に切り替えるとGenEvalは0.83に上がり、さらに第2段階のRLを加えて0.88に到達します。推論の置き場所そのものが効いているという読み方ができます。
テスト時スケーリングの効率
図1は潜在ステップ数を増やしたときの挙動です。画像生成・画像編集・視覚推論のいずれでも性能が単調に伸び、同等の計算量でのbest-of-Nサンプリング(複数候補を生成して最良を選ぶ手法)を上回りました。
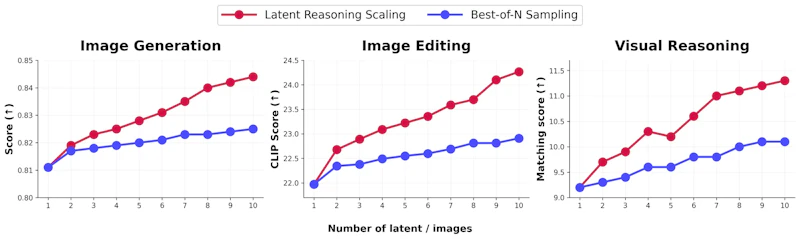
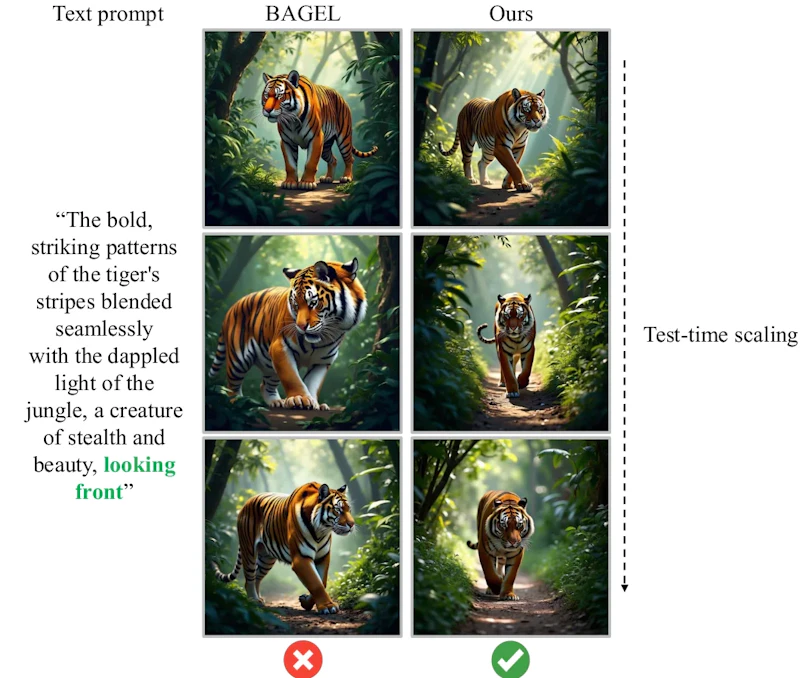
効率の差も大きく開いています。A100 1枚でのサンプルあたり処理時間は、BAGELのbest-of-NがN=1の46.5秒からN=10で469.0秒へ膨らむのに対し、LARCはL=1の46.8秒からL=10でも48.0秒にとどまります。潜在推論が理解エキスパート側の一部の順伝播だけで済み、重い生成エキスパートを繰り返し動かさないためです。図3や図4では、潜在ステップを増やすにつれて指示への忠実度が上がる様子が実例で示されています。
課題と今後の展望
論文自身が挙げる制約は2点あります。1つはフローマッチング型の画像ヘッドを持つUMMにしか適用できていないことで、離散空間で生成するモデルや他の生成ヘッドへの拡張は今後の課題とされています。もう1つは推論時のオーバーヘッドで、増分は小さいとはいえベースモデルより遅くなります。効率的なデコードや蒸留、潜在ステップ数の適応的な割り当てが解決策として示唆されています。
加えて、潜在軌跡は人間が解釈できる空間にないため、モデルが何を考えているのかを検証する手段が乏しいという性質を抱えます。生成結果の品質では確かに改善が出ている一方、推論過程の妥当性を人が確認できない点は、安全性や説明責任を求められる用途では扱いにくさにつながるでしょう。学習コストは8枚のA100で第1段階が約300 GPU時間、第2段階が約96 GPU時間と報告されており、研究室規模でも再現を試みられる水準です。
論文情報: "Latent Reasoning in Continuous Space for Unified Multimodal Models"(Byungwoo Jeon et al., 2026) arXiv:2610.42149, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


