 AI-Papers
- NVIDIA らの研究チームが、点・ボックス・軌跡といった視覚プリミティブを1回の順伝播でまとめて予測する復号手法 VFlash を提案しました
- トークン列の完全一致ではなく構造的な妥当性で予測を受容する設計により、密な点運動予測で約25倍の生成高速化を報告しています
- MolmoSpaces の4つの操作タスク群では平均成功率が62.6%から70.2%へ向上し、速度と精度の両立を示しました
研究の背景
ロボットや自動運転のような物理世界で動くAI(Physical AI)では、Vision-Language Model(VLM、画像と言葉を同時に扱うモデル)が計画の出力として言葉だけでなく座標を返すようになってきました。「どこを掴むか」を示す点、対象物を囲むバウンディングボックス、腕やアームの通り道を表す2D/3D軌跡などです。こうした出力をまとめて視覚プリミティブと呼びます。
問題は生成の速さにあります。従来のVLMは文章と同じ自己回帰(直前の出力を見て次の1トークンを決める方式)で座標を吐き出すため、1つの軌跡を出すだけでも座標トークンを数十回ぶん順番に生成しなければなりません。密な点運動のように出力が豊かになるほど、この逐次生成が制御周期を圧迫します。
論文では、Jetson Thor のような組み込み向けプラットフォームで自己回帰復号を動かすと、1ステップの処理時間のうち75〜87%が復号そのものに費やされていたと報告されています。つまり、モデルの推論本体ではなく「座標を1つずつ書き出す工程」がボトルネックになっているわけです。
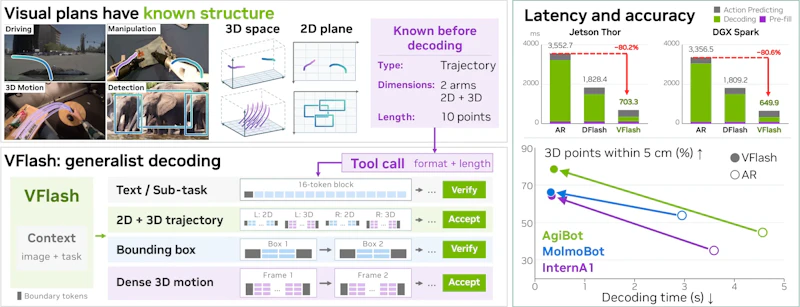
図1に示すように、VFlash は構造化された視覚出力を並列に復号する一方で、言語的な出力には従来どおり検証を伴う方式を併用します。この使い分けが設計の中心にあります。
提案手法 Flash Primitive Decoding
中核となるのが Flash Primitive Decoding(FPD) です。視覚プリミティブは、文章と違って形があらかじめ決まっています。バウンディングボックスなら4つの値、3D軌跡なら各点が3つの値、といった具合です。FPD はこの既知の構造を利用し、プリミティブ全体の座標を1回の順伝播で同時に予測します。
構成としては、凍結した対象VLM(MoonViT エンコーダを組み合わせた Qwen3-4B ベースの改変版)が文脈特徴を供給し、5層の軽量な非因果ドラフターがプリミティブを一括で出力します。プリミティブの開始を示すトークンが引き金となり、直前のツール呼び出しが予測ブロックの長さを、プリミティブの型が座標の並び方を決めます。これにより、空間形式や長さが異なる出力を同じ枠組みで扱えます。
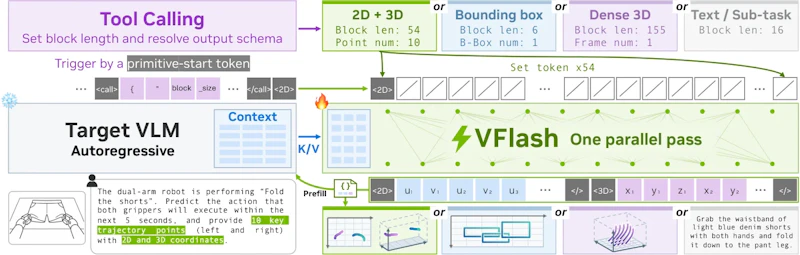
図2の通り、予測ブロックの配置はプリミティブごとに適応的に決まります。座標は1,001個の専用トークン、あるいはテキストとして扱う場合は固定幅の数字グリッドで表現されます。
もう1つの要点が受容の判定方法です。一般的な投機的デコーディング(軽量モデルの下書きを本体モデルが検証する高速化手法)は、下書きが本体の出力トークン列と一致した部分だけを採用します。VFlash のドラフターは対象モデルの続きではなく注釈された座標そのものを学習しており、構造的に妥当であれば対象モデルとのトークン一致を求めずに受容します。座標の並びには正解が1つに決まらない自由度があるため、完全一致を求めない方が受容率が高くなるという発想です。
ただし無条件に信用するわけではありません。推論時にはレイアウトごとの制約でトークンを限定し、ボックス予測には空間的な信頼度のガードを設けて、却下された場合は制約付きの自己回帰復号にフォールバックします。文章やサブタスク計画については、検証を伴う従来の投機的復号を維持しています。
実験結果
ロボット操作では、MolmoSpaces の4つのタスク群で VFlash の計画を条件とした world action model を評価しています。平均成功率は62.6%から70.2%へ上がり、特に Pick & Place と Close で差が大きく出ました。
手法 | 平均 | Pick | P&P | Open | Close |
|---|---|---|---|---|---|
ベースライン | 62.6 | 81.1 | 55.7 | 49.3 | 64.2 |
VFlash | 70.2 | 83.6 | 67.3 | 52.8 | 77.0 |
軌跡予測の精度も自己回帰復号を下回りませんでした。2D軌跡では ShareRobot-Bench の HD が0.175から0.162へ改善し、3D軌跡では AgiBot の平均変位誤差(ADE)が0.083mから0.042mへ、5cm以内に収まる経由点の割合が50%から73%へ上がっています。密な点運動では DAVIS の ADE が MolmoMotion-AR 比で27%、FDE が19%減少しました。高速化が精度の犠牲によるものではない点は、単に下書きを早く出す手法との違いとして重要です。
速度面では、復号時間そのものが Jetson Thor 上で12〜42倍短縮されました。ステップ全体で見ると、MolmoSpaces では Thor と DGX Spark で5.1〜5.2倍、H100 で3.6倍の短縮です。選定理由に挙がっている約25倍という数字は密な点運動の生成速度についてのもので、論文自身が単一ロールアウト計測に基づく暫定値と注記しています。自動運転でも、凍結VLMと小さな行動ヘッドの構成で NAVSIM 90.7 PDMS、Waymo 7.86 RFS を報告しています。視覚エンコーダの扱いから性能を伸ばすNEO-VLAのようなアプローチとは異なり、VFlash は出力の書き出し方を変えることで同種の課題に取り組んでいると言えます。
課題と今後の展望
残る制約もはっきりしています。ボックス予測は IoU 0.95 のような厳しい閾値で F1 が落ち、自己回帰フォールバックを外すと混雑した場面(Dense200)で精度が大きく低下しました。COCO の平均 F1 は47.79で自己回帰の48.68にわずかに届かず、速度は約2.6〜2.8倍という結果です。
密な点運動についても、並列化はフレーム内に留まり、フレーム間は依然として逐次処理です。また受容の判定がスキーマの妥当性とボックスの信頼度ガードに依存するため、空間的な品質はドラフター自身の精度に委ねられます。対象モデルによる検証を省いた分、学習データの質や分布外の場面への耐性が性能を左右する構造になっています。
とはいえ、投機的デコーディングという言語モデル向けの高速化技法を視覚的な行動出力へ拡張し、「構造が既知なら一括で出せる」という単純な観察を枠組みに落とし込んだ点は応用範囲が広そうです。制御周期が厳しい実機ロボットや車載環境で、VLM ベースの計画をどこまで実用的な遅延に収められるかが次の焦点になります。
論文情報: "VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding"(Yu-Cheng Chou et al., 2026) arXiv:2611.08449
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


