 AI-Papers
- OpenAI、Google、Microsoftが2026年10月30日、AI学習利用の意向を示す共通トークン「__usage_ai-training」への対応を表明した
- robots.txtのUser-Agent行にトークンを書き、DisallowとAllowで学習利用の可否を示す。新しい文法は追加しないため既存パーサーに影響しない
- 対応時期はOpenAIが数カ月内、Microsoftが2027年2月1日、Googleが2027年とずれがあり、IETFドラフトは正式な標準ではない
3社が共通シグナルに対応
OpenAI、Google、Microsoftは2026年10月30日(現地時間)、Webサイト運営者がAI学習へのコンテンツ利用に関する意向を複数のAI企業へまとめて伝えられる共通の仕組みに対応すると発表しました。Anthropicも実装を進めています。
この仕組みは、Anthropicで標準化を担当するKevin Kelly氏が同日、標準化団体IETFに提出したInternet-Draft「Machine-Readable Training Preference Signal」に基づくものです。IETFのAI Preferences(AIPREF)ワーキンググループでの議論が土台になっています。
これまでサイト運営者は、AI企業ごとにクローラー名を調べ、個別にルールを書き分ける必要がありました。共通シグナルが普及すれば、その手間が軽くなります。
robots.txtへの書き方
指定方法は、robots.txtのUser-Agent行にポリシートークン__usage_ai-trainingを記述し、その下でDisallowなら学習利用の拒否、Allowなら許可を示すというものです。たとえばDisallow: /とAllow: /press-kit/を並べれば、/press-kit/ 以下を除く全パスで学習利用を拒否する意思表示になります。
トークンを書かない場合は、AI学習について特に意向を表明していないと解釈されます。新しいディレクティブや文法を導入しないため、既存のrobots.txtパーサーの動作には影響しません。
注意したいのは、この指定がクロールの禁止ではないという点です。クロール自体の制限は従来どおり各クローラー向けのルールで行います。対象となる「AI学習」は、生成AIモデルの学習済みパラメータを変更するためのコンテンツ利用を指し、生成以外の用途だけに使うモデルの学習は含まれません。
対応時期は2027年前後
各社の対応予定は次のとおりで、適用が始まる時期には開きがあります。
企業 | 対応時期 | 補足 |
|---|---|---|
OpenAI | 今後数カ月以内 | 実装時に詳細を公表予定 |
Microsoft | 2027年2月1日 | クロール時に新設定を読み取り適用 |
2027年 | 他社と歩調を合わせる方針 | |
Anthropic | 実装着手済み | 全サービスへの展開には時間を要する |
OpenAIは既存のクローラー制御を引き続き適用するとし、他のAI企業にも共通シグナルの尊重を呼びかけています。
各社独自の制御との関係
共通シグナルは各社独自の制御手段を置き換えるものではありません。企業が独自の制御を共通シグナルより優先させることや、個別契約に基づいて異なる扱いをすることも認められています。
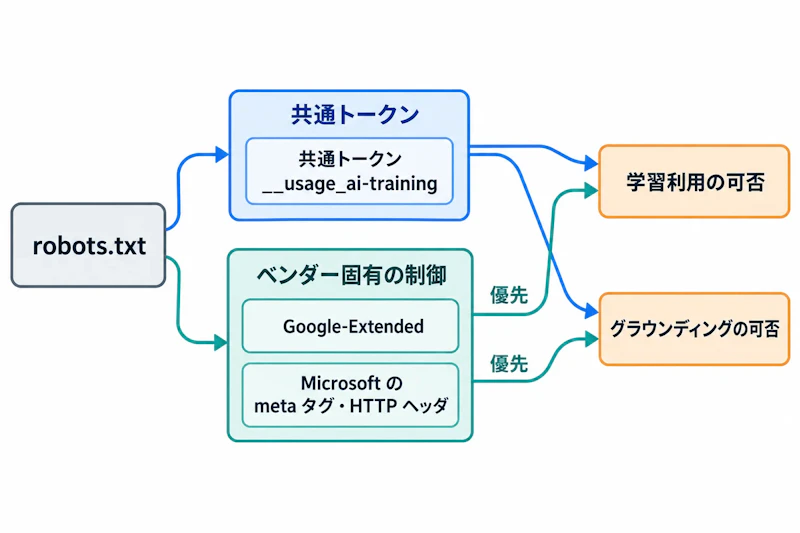
図1のように、Googleは2023年から提供する「Google-Extended」を今後も使えるようにしたうえで、共通シグナルで学習を拒否しかつGoogle-Extendedを明示指定していないサイトは、Google-Extendedによる利用も拒否したものとして扱います。逆にGoogle-Extendedを許可したサイトは、GeminiアプリでWebコンテンツを参照して回答を作る「グラウンディング」の対象となり、回答内で紹介されてクリックを得る可能性があります。
Microsoftは共通シグナルに加え、metaタグとHTTPヘッダによるページ単位の指定を用意し、robots.txtより優先させます。グラウンディングでは、利用を拒否するDisallowのほか、CopilotやMicrosoft 365といった自社サービスでの利用は認めつつWeb IQやMicrosoft FoundryのAPI経由の利用を拒否するDisallowExtendedを導入します。これらはBing検索結果への掲載には影響せず、従来の「NoArchive」「NoCache」を使うサイトは2027年3月1日までの移行を求められています。
運営者が確認すべき点
背景には、AI企業によるWebコンテンツ利用をめぐるパブリッシャーの訴訟の増加があります。Cloudflareは2026年7月にAI関連クローラーを「検索」「エージェント」「学習」の用途別に管理する機能を全顧客へ開放し、Googleも同年6月にAI検索機能へのコンテンツ利用をオプトアウトできるトグルをSearch Consoleで提供すると発表していました。Googleは今回の提案がパブリッシャーや市民団体、規制当局の要望を反映したもので、EU AI法の汎用AIモデル提供者向け行動規範とも整合すると説明しています。
一方で、ドラフトは個人名義の提出でありIETFの標準化プロセス上の正式な地位はなく、今後仕様が変わる余地があります。Webを巡回するAIの振る舞いが問題になる事例はAIブラウザ7種を検証、ChatGPT Atlasなど4種が同一オリジンポリシーを回避でも報じられており、意思表示の手段が整うことと実際に尊重されることは別の問題です。サイト運営者としては、共通トークンの記述を準備しつつ、MicrosoftとGoogleのグラウンディング制御や独自手段との優先関係を個別に確認しておくことになります。


