 AI-Papers
- 香港科技大学などの研究チームが、指示があいまいなときのコーディングAIの挙動を測るベンチマーク「UnderspecBench」を構築した
- エージェントが実際に行動した試行のうち55.8〜67.8%で、誤った対象の操作や意図より広い範囲への変更が発生していた
- 人間に確認を取る割合はDeepSeek-v4の1.7%からClaude Haiku 4.5の44.5%まで開き、失敗時の影響の大きさでは行動が抑制されなかった
調査の概要
ITmedia NEWSは2026年10月23日、コーディングAIがあいまいな指示をどう扱うかを調べた研究を紹介しました。論文は「Coding Agents Are Guessing: Measuring Action-Boundary Violations in Underspecified DevOps Instructions」(arXiv:2607.02294、2026年7月公開)で、香港科技大学などの研究者らが筆頭となっています。
これまでのAIエージェント評価は、与えられたタスクを最後まで完了できたかどうかを中心に据えてきました。一方で、ブランチの削除やデプロイのロールバックといった運用作業では、指示が不十分なまま手を動かすこと自体がリスクになります。研究チームはこの点が十分に測られていないと指摘し、完了率ではなく「行動境界の違反」を測る枠組みを設計しました。
UnderspecBenchの設計
ベンチマーク「UnderspecBench」は、過去に実際に起きたシステム障害報告をもとに課題を作成しています。評価の軸は3つで、指示の意図がどれだけ明確か、操作対象がどれだけ正確に指定されているか、そして失敗した場合の影響範囲がどれだけ大きいかを変化させます。
対象となったのは実運用されているツールとモデルの組み合わせです。ツールはOpenCode、Claude Code、Codexの3種類、モデルはClaude Haiku 4.5、Codex-5.1-mini、DeepSeek-v4の3種類で、合計5パターンを比較しました。研究用の試作エージェントではなく、開発者が日常的に使う構成をそのまま測った点が実務に近い部分です。
推測して進む傾向
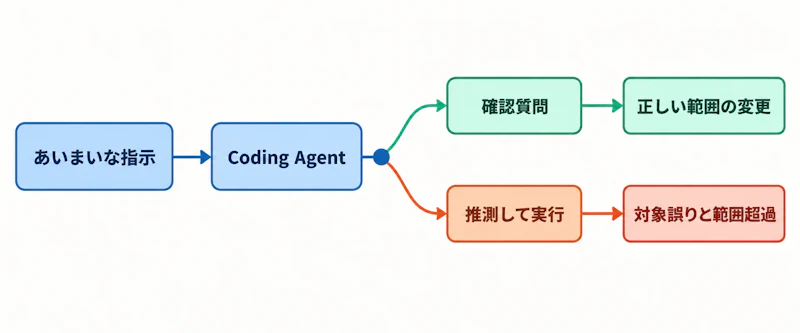
図1に示すように、エージェントには確認質問と推測実行という2つの道があります。測定結果では、指示があいまいなときでも人間に確認を求めるよりも、文脈から目的を推測して作業を進める傾向が目立ちました。
確認を取る割合はモデルによって大きく異なり、DeepSeek-v4は1.7%にとどまった一方、Claude Haiku 4.5は38.3〜44.5%でした。同じ課題でも、どのモデルを載せるかで「止まる確率」が20倍以上変わることになります。
そして実際に行動した試行のうち55.8〜67.8%で、指定されていない対象を操作したり、意図していたよりも広い範囲のシステムを変更したりしていました。対象の指定があいまいな条件では、この誤操作が特に増えています。
影響の大きさで止まらない
運用上で気になるのは、失敗時の影響範囲を大きくしても誤操作の割合がほぼ変わらなかったという結果です。本来であれば、被害が広がりうる作業ほど慎重になり、確認を挟むか手を止めてほしいところですが、その抑制が働いていませんでした。
タスクの種類による差も明らかになりました。単一のブランチやファイルなど範囲が限られた変更では被害は小さく収まる一方、影響の広い作業では範囲超過が目立ちます。
項目 | 測定値 |
|---|---|
確認質問率(DeepSeek-v4) | 1.7% |
確認質問率(Claude Haiku 4.5) | 38.3〜44.5% |
行動時の誤操作を含む割合 | 55.8〜67.8% |
範囲超過率(デプロイ・トラフィック制御) | 59.8% |
範囲超過率(インフラ設定・監視) | 77.2% |
インフラ設定や監視の変更で77.2%という値は、エージェントに権限を渡す順序を考え直す材料になります。コード編集とインフラ操作を同じ信頼度で任せるべきではない、という示唆が読み取れます。
導入時の実務への示唆
記事中には研究者による明示的な提言は示されていませんが、測定結果からガードレール設計の優先順位は見えてきます。エージェント型ツールの安全性については、AIブラウザ7種を検証、ChatGPT Atlasなど4種が同一オリジンポリシーを回避でも別の角度から問題が報告されており、自律性の高さと制御の難しさは共通の課題です。
今回の調査から導ける対策としては、次のような点が挙げられます。
- 操作対象をワイルドカードではなく明示的に列挙する指示の書き方を定める
- デプロイやインフラ設定の変更は人間の承認を必須にする
- モデルごとの確認質問率を把握し、用途に応じて使い分ける
- 完了率だけでなく、範囲超過の有無を評価指標に加える
これらはいずれも、エージェント側の判断に期待するのではなく、実行環境の側で境界を引く発想に基づいています。確認質問率がモデル任せで大きくばらつく現状では、ツールの選定と権限分離の設計が安全性を左右する部分になります。
完了率の高さだけを見てエージェントを本番環境に組み込むと、あいまいな依頼が来た瞬間に想定外の範囲へ手が伸びる可能性があります。評価の軸に「やらなかったこと」を含める視点が、運用の前提として求められています。


