 AI-Papers
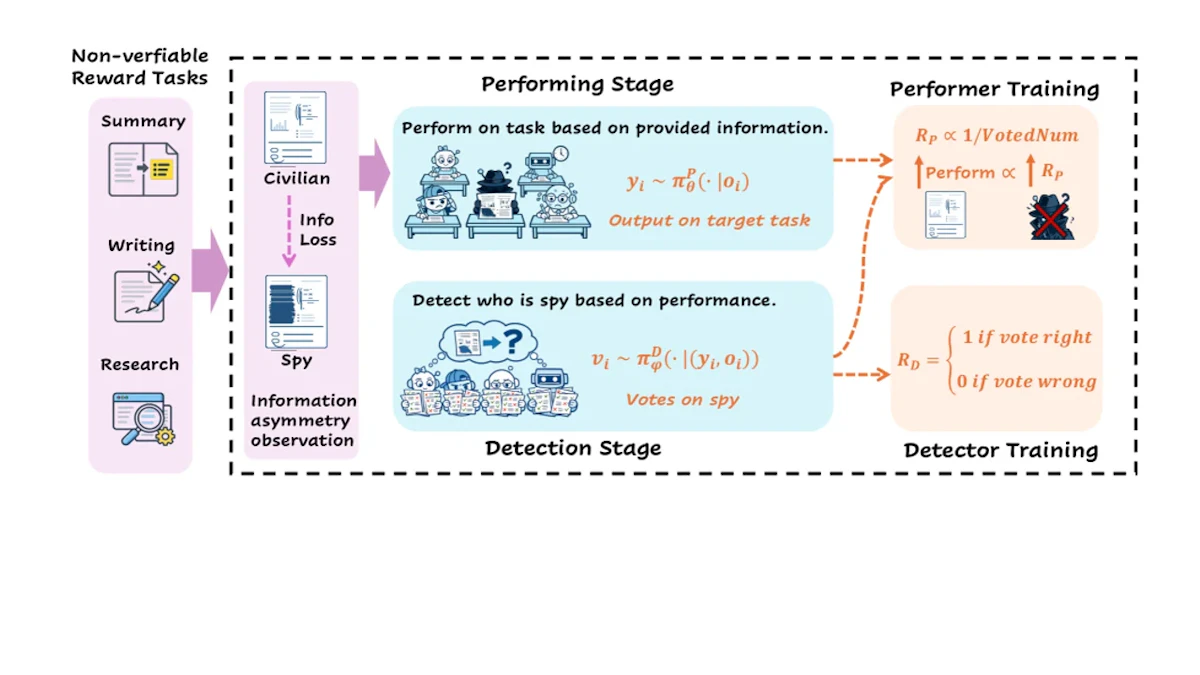
- 要約や創作など正解のないタスクを「スパイを探せ」型のゲームに変換し、検証可能な報酬を自動生成する新手法RLSVRを提案
- 情報の非対称性と投票を利用し、外部の採点役なしでルールベースの決定的な報酬を作り出す点が独創的
- Qwen3-8Bで要約75.4%、創作77.3%の勝率を達成し、数学推論も改善してR-Zeroなど既存手法を一貫して上回る
研究の背景
近年、大規模言語モデル(Large Language Model、以下LLM)を鍛える強力な手法として、検証可能報酬による強化学習(Reinforcement Learning with Verifiable Rewards、以下RLVR)が注目されています。これは数学の計算やプログラムのように、答えが正しいか機械的に判定できるタスクでモデルの出力を採点し、正解へ導く仕組みです。
ところがRLVRには大きな制約があります。要約や創作、調査レポートといった「唯一の正解が存在しないタスク」には使えないのです。文章の良し悪しは主観的で、機械的なルールで丸をつけることができません。従来はこうした開放型タスクに対して、別のLLMを審査役(報酬モデル)として使う方法が主流でしたが、審査役の癖に付け込む「報酬ハッキング」が起きやすく、学習が不安定になる課題を抱えていました。
今回紹介する論文「From RLVR to RLSVR」は、この問題に自己教師あり学習の発想を持ち込みます。データそのものから疑似的な正解を作り出すことで、正解のないタスクにも検証可能な報酬を与えられるようにした点が核心です。
スパイ探しゲームの発想
RLSVRを具体化した枠組みがSpyRLです。名前が示すとおり、パーティーゲームとして知られる「ワードウルフ(Who Is the Spy?)」から着想を得ています。このゲームでは、大多数の市民プレイヤーと少数のスパイが同じお題について話し合い、発言のわずかなズレからスパイを見つけ出します。
SpyRLの巧みな点は、スパイの正体があらかじめ決められていることにあります。つまり「誰がスパイか」という答えは環境側が記録として持っているため、投票結果が正しいかどうかを機械的に検証できます。正解のないタスクを、正解のある「犯人当て」問題へすり替えたわけです。
ここで鍵になるのが情報の非対称性です。市民プレイヤーには完全な入力が与えられますが、スパイには一部を隠した劣化版の入力しか渡されません。要約や創作では文章の20%を連続して伏せ字にし、数学推論では40%の文脈を取り除きます。情報が欠けたスパイは、うまく取り繕おうとしても市民より質の低い出力になりがちで、そこに投票の手がかりが生まれます。
2段階ゲームの仕組み
SpyRLは「実演」と「検出」という2つの段階を交互に繰り返します。実演段階では、市民とスパイの全員が同じお題に取り組み、要約や物語、数学の問題と解答といった出力を作成します。情報を欠いたスパイだけが不利な条件で答えを組み立てる形です。
続く検出段階では、各プレイヤーが互いの出力を見比べ、誰がスパイかを投票で当てます。ここで2種類の報酬が発生します。実演の報酬は、自分が受けた疑いの票が少ないほど高くなります。つまり質の高い出力ほど疑われにくく、報酬も大きくなる仕組みです。一方、検出の報酬は、正しくスパイを言い当てたかどうかを既知の正体と照合して決定的に与えられます。
この設計により、外部の審査役を一切使わずに、出力の品質向上(実演)と見抜く力(検出)の両方を同時に鍛えられます。市民とスパイの報酬はゼロサムの関係に保たれ、双方が競い合う中で自己改善が進みます。
このアプローチは、外部の正解に頼らずモデルが自らを鍛える自己改善AIの潮流に位置づけられます。同じくAI自身が能力を高めていく研究として、Frontis-MA1とは?ML開発を自己改善する35B AIエージェントの仕組みも参考になります。
投票と品質の関係
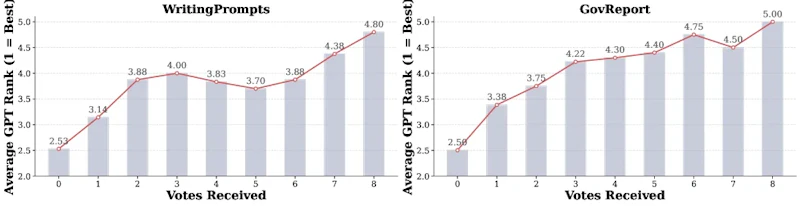
SpyRLが成り立つ前提は、「疑いの票を集めるプレイヤーほど実際に出力の質が低い」という関係が成立していることです。研究チームはこれを確かめるため、創作データセットのWritingPromptsと政府報告書要約のGovReportで100回のゲームを実施しました。
その結果、GPT-4oが1位から5位までランク付けした出力の品質と、受け取った疑いの票数がきれいに対応していることが分かりました。票を多く集めた出力ほど品質評価が低く、外部の検証器を使わなくても投票ベースの報酬が実際の性能とよく一致することが裏付けられています。
実験結果
SpyRLは要約、創作、数学推論の3領域で評価されました。正解のないタスクでは、GPT-4oによるA/Bテスト形式で他手法との勝率を測定しています。Qwen3-8Bを使った場合、要約で75.4%、創作で77.3%という高い勝率を記録しました。人手による評価でも創作で80%の勝率を示し、機械評価の妥当性が確認されています。
正解のある数学推論でも効果が現れました。GSM8K、Math500、AIME24、AIME25、Minerva、MMLU-Pro、GPQA-Dの7つのベンチマークにおいて、Qwen3-4Bで平均8.97%、Qwen3-8Bで6.16%の改善が得られています。開放型タスク向けに作られた手法が、検証可能な推論タスクでも底上げをもたらす点は見逃せません。
比較対象としたR-ZeroやAbsolute Zeroといった既存の自己改善手法を、3領域すべてで一貫して上回りました。特に既存手法がほとんど改善を示せなかった開放型タスクでの伸びが顕著です。
領域 | 指標 | SpyRL(Qwen3-8B) |
|---|---|---|
要約(GovReport) | 勝率 | 75.4% |
創作(WritingPrompts) | 勝率 | 77.3% |
数学推論(7ベンチ平均) | 改善幅 | +6.16% |
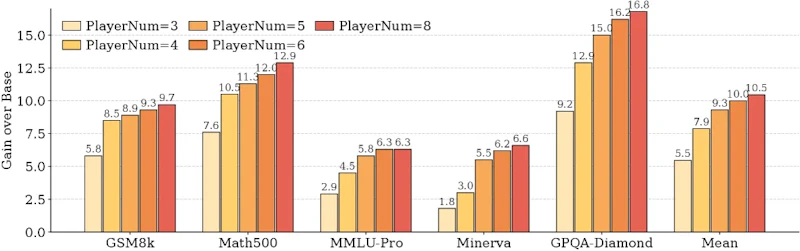
プレイヤー数の影響を調べた実験も興味深い結果でした。3人から5人へ増やすと改善幅が最も大きく伸び(平均5.5から9.3へ)、6人や8人まで増やすと効果が頭打ちになります。ゲームの複雑さとしては5人が十分で、それ以上は計算コストに見合わないことを示しています。
まとめと今後の展望
RLSVRとその実装SpyRLは、正解を定義できないタスクを「スパイ探し」ゲームへ変換することで、検証可能な報酬を自動的に生み出す発想を提示しました。情報の非対称性と投票という単純な仕組みだけで、外部の審査役に頼らずモデルを自己改善させられる点が最大の貢献です。コードはGitHubで公開されており、本研究はCOLM 2026に採択されています。
一方で課題も残ります。ゲーム化のために入力を劣化させる方法は領域ごとに人手で設計する必要があり、新しいタスクへ広げるにはひと工夫が要ります。また投票ベースの報酬が品質と一致するのは、市民とスパイの間に明確な情報差がある場合に限られるため、微妙な違いを競うタスクでどこまで機能するかは今後の検証が待たれます。それでも、正解のない領域へ強化学習を持ち込む道筋を具体的に示した意義は小さくありません。
論文情報: "From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement"(Qinsi Wang et al., 2026) arXiv:2607.23802, CC BY 4.0
本記事の図(図1、図2、図4、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


