 AI-Papers
- Draft/Improve/Debug/Crossoverの4操作を実行結果で学習し、進化的探索と統合した35BのAI4AIエージェント
- MLE-Bench Liteでメダル獲得率を39.39%から71.21%へ引き上げ、GPT-5.5とCodexの組み合わせを上回る成績を達成
- 単一のRTX 4090で動作し、コードと重みをOpenRSIとして公開した再現性の高い自己改善AIの実例
研究の背景
AIが自らAIを設計し、その過程を自分自身で改良していく「再帰的自己改善」は、長らく将来の可能性として語られてきました。実現の難しさの一つは、改善が本当に前進しているかを客観的に測る手段がない点にあります。文章生成の良し悪しは主観に左右されますが、機械学習エンジニアリング(MLE)は違います。書いたコードが動くか、精度が上がるかを実行して数値で確かめられるため、自己改善の検証に向いた領域だといえます。
この論文が提案するFrontis-MA1は、機械学習の開発作業そのものを対象に据え、AIがAIを作る「AI4AI」の考え方を再帰的自己改善へと結びつけた35Bパラメータのエージェントです。従来この種のエージェントは、外部の巨大な商用モデルをAPI経由で呼び出す構成が主流でした。呼び出しコストが高く、モデルの中身に手を入れられないため、エージェント自身を鍛え直すことが難しいという課題を抱えていました。
提案手法
研究チームはFrontis-MA1を支える基盤として、OpenMLEと呼ぶ一連のスタックを構築しました。これは大きく3つの要素で成り立ちます。1つ目は実行して結果を検証できるタスク環境、2つ目はエージェントに具体的な操作を身につけさせるオペレータ学習、3つ目は良い解を長い時間をかけて探し続ける長期探索です。
中心となるのが、プログラムを進化させる4つの原子的な操作です。それぞれが役割を持ち、組み合わせることで解を段階的に磨き上げていきます。
- Draft: 課題に対する最初の解法コードをゼロから起草する
- Improve: 既存の解を土台に精度や効率を高める改良を加える
- Debug: 実行時のエラーや不具合を特定して修正する
- Crossover: 複数の有望な解を掛け合わせて長所を統合する
これら4操作は「実行接地型(execution-grounded)」の教師あり微調整(SFT)と強化学習(RL)で鍛えられます。生成したコードを実際に走らせ、動いたか、成績が上がったかという実行結果を報酬として学習に反映させる仕組みです。机上での正しさではなく、動く現実に基づいて操作の質を高める点が特徴といえます。
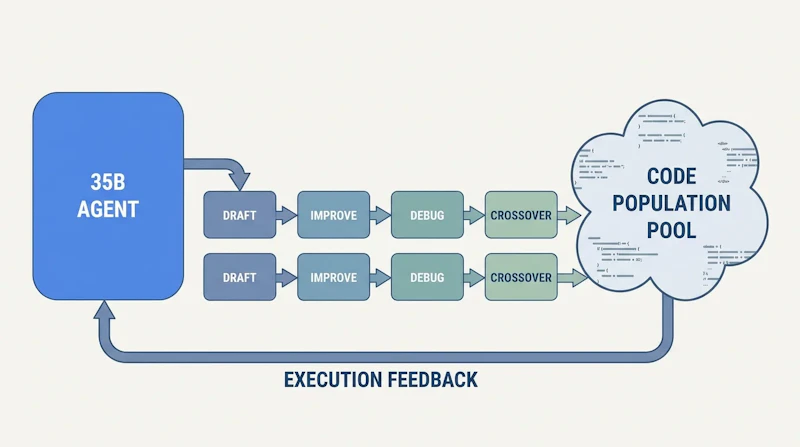
学習した4操作は、さらに進化的探索と統合されます。多数の解候補を集団として保持し、有望なものを選んで改良や交叉を繰り返すことで、単発の生成では届かない解へ到達します。数多く試して良いものを残す探索の発想は、反省より繰り返しサンプリングが有効だとする研究とも通じる方向性です。この進化的探索を最大限に働かせた構成がOpenMLE-Evo-Maxで、後述する最高成績を生み出しました。
実験結果
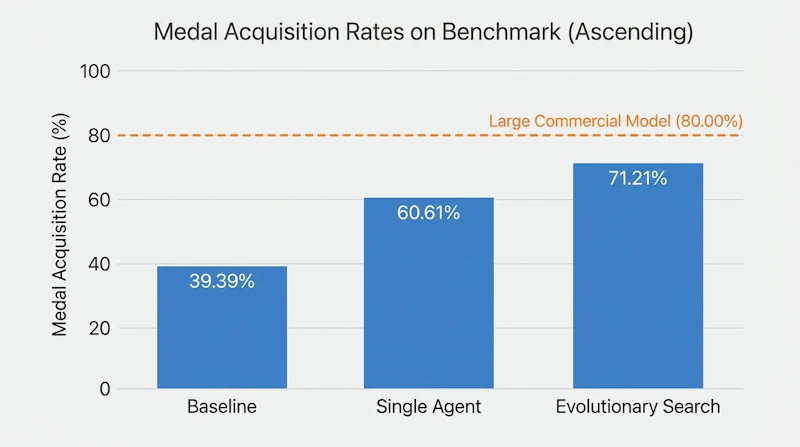
評価には、機械学習コンペを模したベンチマークMLE-Bench Liteが使われました。ここでの「メダル獲得率」は、エージェントの解がコンペで入賞相当の順位に入った割合を示します。単一のRTX 4090(VRAM 12GB相当)で12時間という限られた計算予算のもと、Frontis-MA1は着実な向上を見せました。
手法 | メダル獲得率 |
|---|---|
ベースライン | 39.39% |
Frontis-MA1(単一エージェント) | 60.61% |
Frontis-MA1 + 進化的探索(Evo-Max) | 71.21% |
単一エージェントでもメダル獲得率は39.39%から60.61%へ大きく伸び、進化的探索を加えたOpenMLE-Evo-Maxでは71.21%に達しました。この水準は、外部の強力なモデルを組み合わせたGPT-5.5+Codexを上回り、さらに上位のGPT-5.6 SolやKimi K3にも迫るものです。巨大な商用モデルに頼らず、35Bという扱いやすい規模で同等以上に競える点が実用面で重要な意味を持ちます。
学習時に見ていない課題への対応力も確認されています。別のベンチマークであるNatureBench Liteでも性能の転移が見られ、特定のタスクに過度に最適化されたのではなく、機械学習開発の一般的な手続きを身につけていることを示しました。
まとめと今後の展望
Frontis-MA1は、再帰的自己改善という抽象的なテーマを、検証可能な機械学習エンジニアリングという土俵で具体的な成果として示しました。実行結果に基づいて4操作を鍛え、進化的探索と組み合わせる設計により、単一の家庭用GPUでも大規模商用モデルに匹敵する開発力を引き出せることが確かめられています。コードと重みがOpenRSIとして公開されており、誰でも追試や拡張に取り組める再現性の高さも見逃せません。
一方で課題も残ります。メダル獲得率は71.21%であり、すべての課題を解けるわけではありません。この成果が有効なのは、実行して数値で検証できる領域に限られる点にも留意が必要です。検証が難しい課題へ自己改善の枠組みをどこまで広げられるかは、今後の研究に委ねられています。それでも、AIが自らの開発能力を高めていく道筋を、公開されたモデルと再現可能な手続きで示した意義は大きいといえるでしょう。


