 AI-Papers
- 凍結したQwen3.5-4Bに軽量アダプタを足し、512px画像を1回の順伝播で生成するJeverationが提案されました
- 全位置を共有の乱数状態で条件付けすることで、並列に予測しても破綻しない大域的な整合性を確保しています
- H200で1枚77.8ms、Janus-Pro-7B比で約122倍の速さながらGenEval 0.74、DPG-Bench 78.24を記録しました
研究の背景
画像生成モデルの主流は、拡散モデルと自己回帰モデルです。どちらも少しずつ結果を作り上げる反復処理を前提にしており、ノイズ除去を何十回も繰り返すか、トークンを1個ずつ順番に予測します。品質は高い一方で、1枚の生成に数秒かかることも珍しくありません。
この反復コストを削る研究は数多くあり、サンプリング回数を減らす蒸留や、VAEデコーダを省いてピクセルを直接出力する手法など、各段階の無駄を取り除くアプローチが続いています。シンガポール国立大学などの研究チームが発表した「Jeveration」は、反復そのものをやめるという方向に踏み込みました。
System Oneとは
論文は人間の思考の二分法を借りて、モデルを2種類に分けています。段階的に考えを進めるのがSystem Two、入力を受けて即座に答えを返すのがSystem Oneです。分類器や物体検出器は後者に当たり、1回の順伝播(入力から出力まで1度だけ計算を通すこと)で結果が確定します。
著者らの狙いは、画像生成をSystem One側に移すことです。画像全体を1組の離散コード(画像を表す記号列)として扱い、それを「1つの型付き決定」として一括で出力します。ここで問題になるのが整合性です。1つのプロンプトに対して正解となる画像は無数にあるため、各位置が独立に「正しい」コードを選んでも、全体としてはつながらない絵になってしまいます。
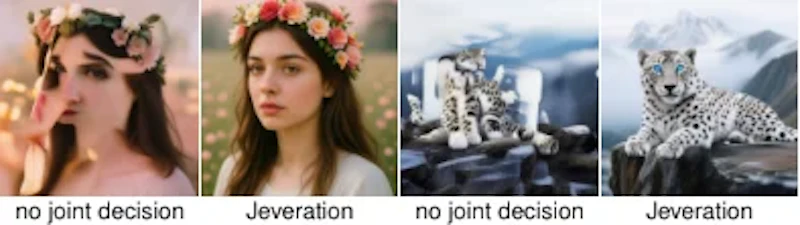
図2の左側は、学習したコード分布から各位置を独立にサンプリングした結果です。局所的には妥当なパーツが並んでいても、互いにかみ合わず像を結びません。
共有乱数状態と構成
Jeverationの中心的な工夫は、1枚の画像に対して1つの乱数状態を引き、すべてのコード位置をその同じ状態で条件付けする点にあります。全位置が共通の「くじ」を参照するため、並列に予測しながらも同じ1枚の画像に向かって足並みがそろいます。引き直せば別の画像になるので、多様性も保たれる仕組みです。
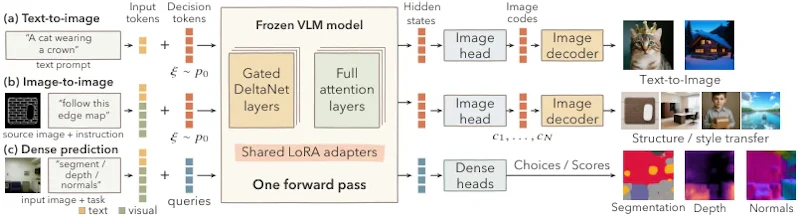
図3が全体構成です。基盤には凍結したQwen3.5-4Bという視覚言語モデルを使い、学習するのはランク256の共有LoRAアダプタとタスク別の出力ヘッドのみで、学習対象は約1.0Bパラメータに抑えられています。生成時は128個の決定トークンを乱数状態から初期化し、密予測では同じトークンが空間クエリとして働きます。
出力ヘッドはコードブック分岐と広い分岐の2系統を足し合わせる設計で、片方だけに比べてGenEvalが0.59〜0.60から0.64へ改善したと報告されています。画像のトークナイザには凍結したTA-TiTokを用い、デコーダのみ512px向けに微調整しています。
2段階で学習する
単一順伝播のモデルを画像で直接教えると、モデルは乱数状態を無視して平均的な出力に寄ってしまいます。そこで学習を2段階に分けました。第1段階ではマスク付きモデルに画像コードの分布を学ばせ、第2段階でその凍結モデルに分布を合わせる形で決定モデルを訓練します。さらに確信度に応じた補正の損失を加えています。
この決定モデルの学習を省くと、マスク付きモデルを1回動かしただけではGenEvalが0.32にとどまります。乱数状態を固定した場合もGenEvalは0.73から0.70、HPSv2.1は28.27から26.63へ下がり、共有乱数状態が効いていることが確かめられています。推論は1回で済む代わりに、学習側の手数は増える構成です。
実験結果
512pxでの文章からの画像生成を、H200・バッチサイズ1で比較した主な結果が下の表です。
モデル | ステップ数 | GenEval | DPG | HPSv2.1 | 遅延(ms) |
|---|---|---|---|---|---|
Jeveration | 1 | 0.74 | 78.24 | 28.06 | 77.8 |
Janus-Pro-7B | 576 | 0.80 | 83.91 | 28.47 | 9508.4 |
Janus-Pro-1B | 576 | 0.73 | 82.63 | 27.73 | 7593.2 |
Show-o Turbo-512 | 4 | 0.63 | 83.35 | 27.35 | 94.1 |
SANA-Sprint 0.6B | 1 | 0.72 | 78.63 | 28.74 | 121.2 |
FLUX.1-schnell | 1 | 0.69 | 85.97 | 29.63 | 345.6 |
遅延はJanus-Pro-7Bの約122分の1で、表のなかで最速です。プロンプトの指示通りに要素を配置できるかを測るGenEvalでは、同じ系列の小型モデルであるJanus-Pro-1Bを上回りました。一方でJanus-Pro-7Bには及ばず、DPG-Benchでも差が残っています。SANA-Sprintやの1024px系モデルと比べると、人間の好みを近似するHPSv2.1は下回りました。
画像から画像への変換も同じチェックポイントで扱えます。入力側に専用の分岐を設けたことで、HEDエッジのF1は0.880、深度のδ1は0.802と、入力をそのまま複製する基準や分岐なしの構成を上回りました。遅延は91.7msで、文章からの生成より14msほど増える程度です。
密予測も同じ重みで
密予測(画素ごとに意味や距離を推定する処理)も、重みを切り替えずに同じモデルで解けます。NYUv2では13クラスの領域分割で67.7 mIoU、深度の絶対誤差0.267m、法線の平均角度誤差24.2度を記録し、1枚あたりの処理は約78msでした。
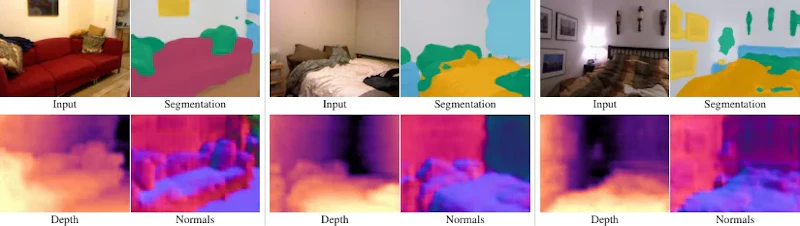
図6は同一チェックポイントの出力例です。分割精度はDeepLabV3+(53.5 mIoU)を大きく上回り、密予測だけを学習した専用モデルとほぼ同等でした。ただし法線は専用モデルの21.2〜23.0度に対して24.2度と劣り、著者らはタスク間で容量を分け合った影響と見ています。
課題と展望
生成品質そのものは最先端の反復型モデルに届いておらず、評価は512pxに限られます。密予測の検証もNICYuv2単独で、屋外や多様なドメインでの挙動は未確認です。学習パイプラインがマスク付きモデルと補正損失を必要とする点も、再現のハードルになりそうです。
それでも、凍結した視覚言語モデルの知識を使い回しながら、生成と認識を1つの重みで100ms未満にまとめた点は実用面で意味があります。対話型の編集やロボットの知覚のように応答時間が制約になる用途では、品質を少し譲っても単一順伝播という選択肢が現実味を帯びてきました。
論文情報: "Jeveration: System One Models Now Generate"(Yuhe Liu et al., 2026) arXiv:2611.24738
本記事の図(図2、図3、図6)は解説のため上記論文より引用しています。


