 AI-Papers
- 潜在拡散モデルに必須だったVAEデコーダを取り除き、拡散Transformerの最終層から線形ヘッドで直接ピクセルを出力するDWDを提案
- サンプリングを担う元のデノイズヘッドは事前学習モデルに固定し、ピクセル出力用のヘッドだけを別に学習する分離設計が性能の鍵
- ImageNet 256×256でAnisoFlow-H/16のFIDが1.55から1.43へ改善し、Wan2.1 14Bの動画ではワーピング誤差を23%削減
研究の背景
現在の画像生成・動画生成の主流は潜在拡散モデル(Latent Diffusion Model)です。画像を直接扱う代わりに、VAE(Variational Autoencoder、変分オートエンコーダ)で圧縮した低次元の「潜在表現」の上でノイズ除去を行い、最後にVAEのデコーダでピクセルへ復元します。
この構成は計算量を大幅に減らせる一方、デコーダ自体のコストと品質上の制約を抱えています。デコーダは拡散モデルとは別に学習されており、与えられた潜在表現しか見ません。そのため肌や髪、布の織り目といった細部が平滑化されたり、動画では細い線がフレームごとに揺れるちらつきが生じたりします。実際、Wan2.1 14Bのデコーダは0.28 PFLOPs、FLUX.2 klein では10.47 TFLOPsもの計算を占めており、生成そのものとは別に無視できない負荷になっています。
Stanford大学、Caltech、Luma AIらの研究チームが発表した「Decoding Without a Decoder(DWD)」は、このデコーダを完全に取り除くアプローチです。デコード処理の軽量化という方向はFastFramesのようにデコーダ自体を高速化する研究もありますが、DWDはそもそもデコーダを持たない構成を目指します。
提案手法
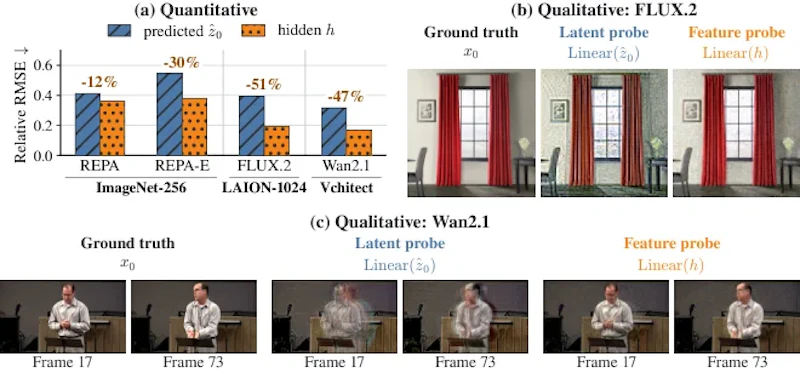
着想の出発点は、拡散Transformer(Diffusion Transformer、DiT)の最終層が持つ情報量です。研究チームは事前学習済みモデルを凍結したまま、デノイズ後の潜在表現からピクセルへの線形回帰と、最終層トークンからピクセルへの線形回帰を比較しました。その結果、最終層トークンのほうが明らかに低い誤差で元画像を復元できることが分かりました。
図3がこの検証結果です。潜在表現は情報が絞られた「出力用の要約」である一方、最終層トークンは生成過程で蓄えた文脈をより多く保持しており、追加学習なしでも細部やフレーム間の一貫性を再現できています。つまりデコーダに渡す前の段階に、ピクセルを直接描くための材料がすでに揃っているということです。
DWDの構成は図2の通りです。元のデノイズヘッドはそのまま残してサンプリング軌道を担当させ、それと並列に線形のDWDヘッドを追加します。DWDヘッドは各トークンを対応するピクセルパッチへ写すだけの単純な線形変換で、サンプリングの最終ステップでのみ動作します。途中のステップは従来どおり潜在空間で進み、最後の1回でピクセルが直接出てくる形です。
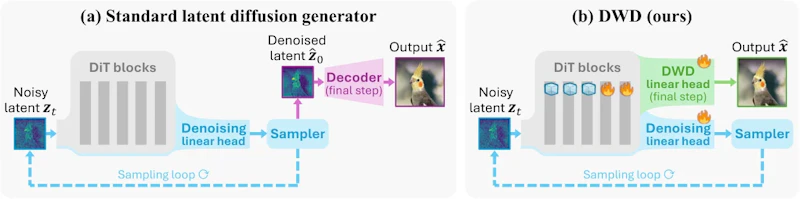
学習は全体ではなく末尾のみに限定されます。主な設定は次のとおりです。
- 微調整するのは最後のK個のTransformerブロック(大規模モデルでは4〜8)と両ヘッド、最終変調層、複製したタイムステップ埋め込みMLP
- ピクセル品質損失としてL1、LPIPS、学習後半で有効化する敵対的損失を併用
- デノイズヘッドは凍結した参照モデルの速度予測とのMSEで固定し、サンプリング軌道のずれを防ぐ
- DWDヘッドは1万枚の画像を用いた最小二乗回帰で初期化
前段のブロックを凍結するため、全体を逆伝播する場合に比べて学習が最大3倍速くなります。この「軌道はいじらず、出力だけ付け替える」分離設計が重要で、2つのヘッドを1つに統合するとAnisoFlowのFIDは1.43から1.71へ悪化しました。
もう1つの要点が、ピクセルを出力する最終タイムステップの扱いです。完全にノイズを除去しきった時点(t=0)でDWDヘッドを動かすと改善が消え、ベースラインと同等以下になります。わずかにノイズが残る小さな正の時刻を選ぶと細部が戻るため、最終ステップにはあえて情報を残しておく必要があります。
実験結果
ImageNet 256×256のクラス条件付き生成では、潜在モデルとピクセルモデルの双方で一貫した改善が得られました。とくにピクセル空間のフローモデルであるAnisoFlow-H/16で、この条件での既存最高水準を更新しています。
モデル | ベースラインFID | DWDのFID |
|---|---|---|
SiT-XL/2-REPA(SD-VAE) | 1.38 | 1.36 |
SiT-XL/2-REPA-E | 1.12 | 1.06 |
JiT-H/16(ピクセル) | 1.90 | 1.85 |
AnisoFlow-H/16(ピクセル) | 1.55 | 1.43 |
潜在モデルではSD-VAEのデコーダ分622.2 GFLOPs、E2E-VA-VAE版で252.2 GFLOPsの計算がそのまま削減されます。品質を維持したままデコーダを丸ごと外せる点が実用上の利点です。
1024×1024のテキスト画像生成では、FLUX.2 klein BaseのFIDが15.13から15.05とほぼ同等で、OneIGやLongTextの指標も横並びでした。10.47 TFLOPsのデコーダを削った上で品質を保てたという位置づけです。一方ピクセル空間のAnisoFlow-L/16-T2IではCOCO FIDが28.86から27.54、pFIDが36.59から32.26へと明確に改善し、樹皮や雲、羽毛の質感がベースラインより保たれました。
効果が最も大きかったのは動画です。Wan2.1 14Bの832×480生成で、フレーム間の整合性を測るワーピング誤差が1.52から1.18へ23%下がりました。同じデータでデコーダ自体を微調整した場合は1.39までで、DWDのほうが上回っています。8ビット推論でも1.69から1.20へ改善し、4ステップのWan2.1 1.3Bでは2.84から2.07(27%削減)となりました。
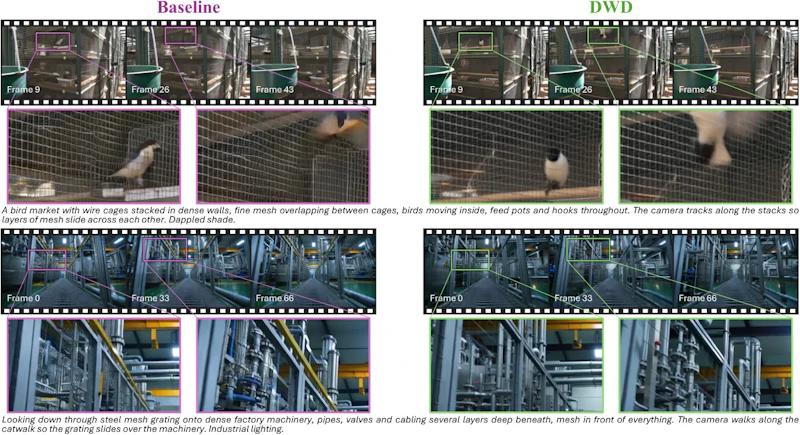
図6では、ベースラインのデコーダが金網を波打つ線に歪ませ、密集した配管を斑点状に崩す様子が確認できます。これらの崩れはフレームごとに位置が変わるため、ちらつきとして目につきます。DWDは構造を保ったまま、カメラが動いても安定させています。
まとめと今後の展望
DWDは、潜在拡散の標準構成だったVAEデコーダを取り除き、拡散Transformerの最終層から直接ピクセルを出力する手法です。追加するのは線形ヘッド1つで、学習も末尾数ブロックに限られるため、既存の事前学習モデルへ後付けしやすい設計になっています。
課題も残ります。著者自身が指摘するとおり、FLUX.2のように潜在チャネルが広くデコーダがすでに強いモデルでは改善幅が小さくなり、4ステップ設定ではFIDがわずかに悪化しました。線形ヘッドで足りるかは16×16より大きいパッチサイズでは未検証で、より表現力のあるヘッドが必要になる可能性があります。動画では動きの多様性を示すDynamic Degreeがやや低下しており、ピクセル損失の重み付けも各モデル向けに調整されていません。
それでも、デコーダという独立した部品を前提としない生成パイプラインが成立しうることを示した点には意味があります。推論コストの削減と細部品質の向上が同時に得られるケースは多くないため、画像と動画の両方で再現性を検証する価値のある方向と言えるでしょう。
論文情報: "Decoding Without a Decoder: Direct Pixel Prediction from Diffusion Transformers"(Hansheng Chen et al., 2026) arXiv:2611.22287
本記事の図(図2、図3、図6)は解説のため上記論文より引用しています。


