 AI-Papers
- RATs(Robotics Agent Teams)はタスク指示の前の「遊び」フェーズで自律的にコードスキルライブラリを構築し、後続タスクで再利用するロボット学習フレームワーク
- LIBERO(ロボット操作学習の標準ベンチマーク群)のPROサブセットで+20.6ポイント、視覚言語対応の操作ベンチマークMolmoSpacesで+17.0ポイントの精度向上を達成
- 習得スキルはコードとして保存されるため、ベースモデルを再学習せずに他の環境や別エージェントへ転移でき、実機ロボットへの応用でも有効性を確認
研究の背景
人間の子どもは、特定の課題を与えられる前から積み木で遊び、物の重さを感じ、バランスを学びます。この「遊び」による事前スキル獲得が後のより複雑な課題解決を容易にすることは、教育学でも広く知られています。
一方、従来のロボット学習では「このタスクを実行せよ」という指示を受けてから学習を開始するのが一般的でした。タスクごとにゼロから学び直すため、似た動作パターンを何度も繰り返し習得する非効率さが課題となっていました。
UC Berkeleyらが提案したRATs(Robotics Agent Teams)は、この課題に正面から取り組みます。明示的なタスク指示を受ける前の「遊び」フェーズで、ロボットエージェントが自律的にスキルを積み上げる仕組みを提案しました。
RATsの学習プロセス
RATsの核心は、「遊び時間(play time)」と「評価時間(evaluation time)」の2段階構成にあります。
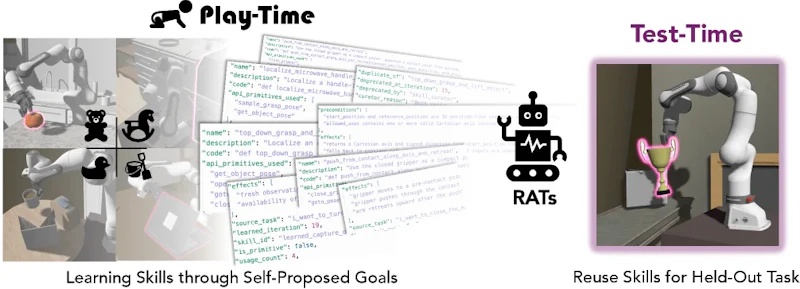
遊び時間には、エージェントチームが次の4つのステップを繰り返します。まず「どんな操作を練習すべきか」という目標を自ら提案し、Code-as-Policy(コードとしての方針)と呼ばれる手法でロボット操作コードを生成・実行します。Code-as-Policyとは、大規模言語モデルがロボット制御のプログラムコードを直接書き出す手法で、自然言語の指示を実行可能なコードに変換します。
実行後は別のエージェントが結果を検証し、失敗した場合は原因を診断してリトライします。成功した動作パターンは「コードスキルライブラリ」に蒸留・保存され、評価時に取り出して再利用されます。
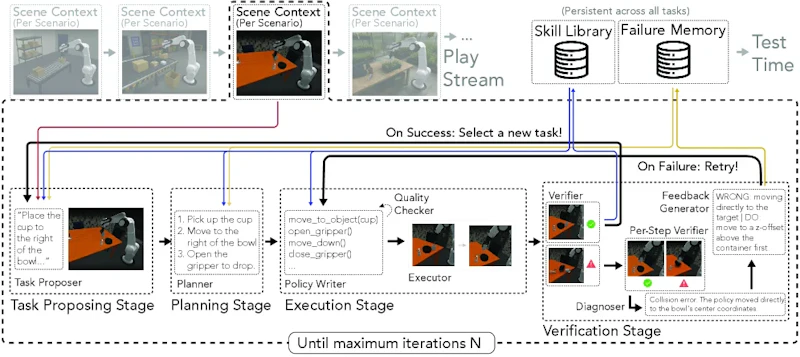
この仕組みの要点は、スキルライブラリが「ベースモデルを変えずに」機能することです。スキルはコードとして保存されるため、異なるエージェントや環境でも呼び出して使えます。またHumanScaleのような身体的AI事前学習アプローチと組み合わせることで、さらなる性能向上も期待できます。
実験結果
研究チームは複数のベンチマークでRATsを評価しました。比較対象は、スキルライブラリを持たずコードを直接生成するベースライン「CaP-Agent0」です。主な結果は次の表のとおりです。
評価した環境 | 精度の向上幅 |
|---|---|
LIBERO PROサブセット | +20.6ポイント |
MolmoSpaces | +17.0ポイント |
RoboSuiteへのスキル転移 | +8.9ポイント |
実機ロボットへの転移(シム-to-リアル) | +8.8ポイント |
上の2つはシミュレーション上での評価です。LIBERO(ロボット操作学習の標準ベンチマーク群)のPROサブセットと、視覚言語対応の操作ベンチマークMolmoSpacesのいずれでも、二桁の改善幅となりました。
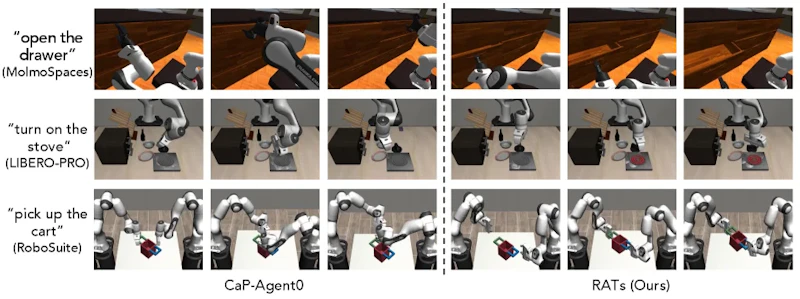
下の2つはスキル転移の実験です。LIBEROで遊びながら習得したスキルを、物体操作シミュレータRoboSuiteの別タスクに転移しても改善が確認されました。ベースモデルの再学習なしに既存スキルを別環境で活用できることを示しており、実用面での使い勝手のよさがうかがえます。
シミュレーション環境から実機ロボットへの転移(シム-to-リアル転移)でも同程度の向上が得られました。研究室のシミュレーションにとどまらない、実世界での有用性も裏づけられたことになります。
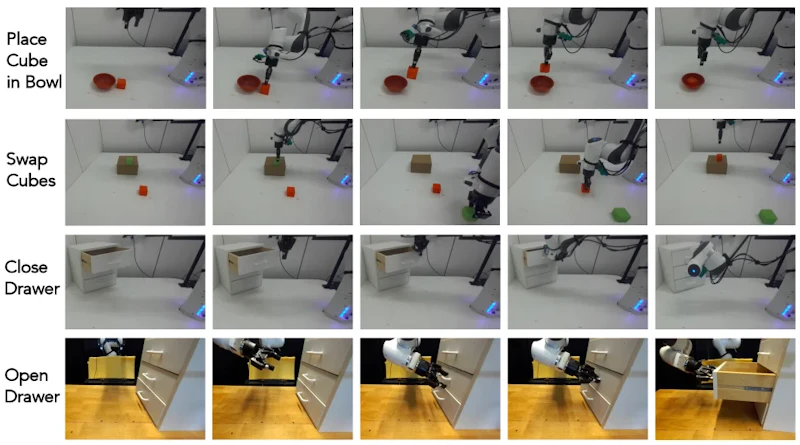
なぜスキルライブラリが有効なのかは、コード比較からも読み取れます。コードを直接生成する場合、知覚処理・座標計算・経路計画などの低水準処理を毎回ゼロから書き直す必要があります。RATsでは検証済みのスキルを呼び出すだけで済むため、壊れやすいコードの再生成を大幅に削減できます。
まとめと今後の展望
RATsは「タスク指示を受けてから学ぶ」という従来の枠組みを見直し、遊びによる事前スキル獲得をロボット学習に取り入れた手法です。スキルがコードとして保存されるため解釈しやすく、別エージェントへの転移も容易という実用的な利点があります。
今後の課題としては、遊び時間の長さや提案する目標の質が最終性能に与える影響の精緻化が挙げられます。スキルライブラリが大規模になったときの検索効率や、相互に干渉するスキルの管理も研究テーマになるでしょう。人間の子どもが遊びを通じて世界を理解していくように、ロボットも遊びながらスキルを積み上げられる、という方向性を示した研究といえます。
論文情報: "Playful Agentic Robot Learning"(Junyi Zhang et al., 2026) arXiv:2606.19419
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


