 AI-Papers
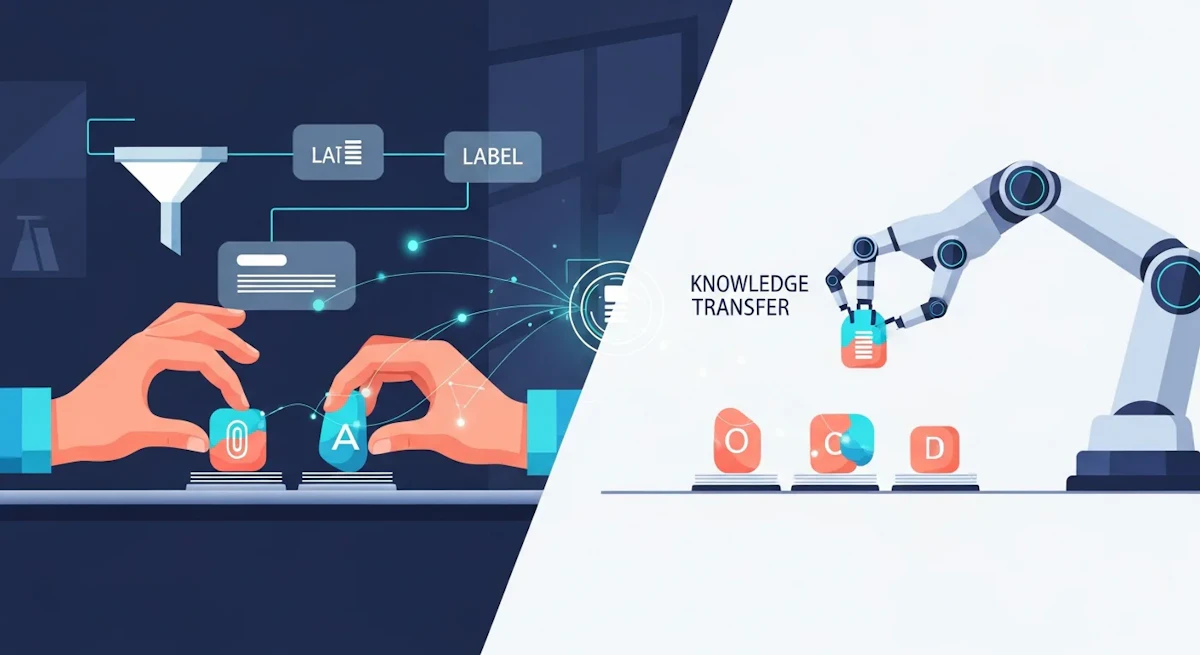
- 人間の一人称視点映像(エゴセントリック映像)を適切に処理すると、実ロボット遠隔操作データよりも優れた事前学習データになることを実証
- 分布内タスクで52.5%、分布外タスクで90%の成功率向上を達成し、検証損失も24%削減
- フィルタリングとラベリングパイプラインにより、安価で大量のデータ確保が可能になり、身体的AIのデータスケーリング戦略を刷新
研究の背景
ロボットに多様な作業を習得させるには大量の学習データが必要ですが、実機ロボットを使った遠隔操作データの収集は時間もコストも膨大です。高品質な遠隔操作データを1時間分集めるだけでも専門機材と人手が欠かせません。
一方、人間が日常生活を送る様子を頭部装着カメラで撮影した「エゴセントリック映像」は、インターネット上に大量に存在します。調理、掃除、物を手に取る動作など、ロボットが学ぶべき手作業が豊富に含まれています。
ただし、こうした映像をロボット学習に活かすには、次のような課題を乗り越える必要がありました。
- カメラワークのブレによる映像の不安定さ
- 作業と関係のないシーンの混入
- 動作ラベルが付与されていないこと
北京大学のチームが提案したHumanScaleは、この人間映像の潜在力を引き出すフィルタリングとラベリングのパイプラインを構築し、実ロボットデータを凌駕する事前学習を実現しました。
提案手法:フィルタリングとラベリングの2段構成
HumanScaleの核心は、生の人間映像を高品質な事前学習データへと変換する処理パイプラインにあります。まずフィルタリング段階で、手が写っていない映像、極端なカメラ振動、移動中の映像などの非作業シーンを除去します。
手の動きと物体の操作が明確に捉えられたクリップだけを残すことで、データ品質を高める仕組みです。
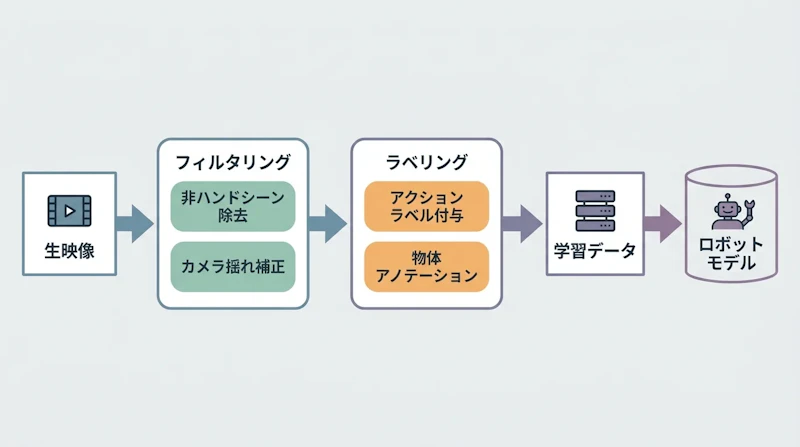
続くラベリング段階では、残ったクリップに対して動作カテゴリと操作対象のアノテーションを自動付与します。画像と言語を結びつけて解釈する既存の視覚言語モデルを活用することで、人手を最小限に抑えながら大規模なラベル付きデータセットを構築できます。
事前学習後は、少量のロボット遠隔操作データでドメイン適応(ファインチューニング)を行います。人間映像で得た「手で物を掴む」「道具を操る」という汎用的な知識を、ロボットの動作空間へ効率的に転移させる設計です。
実験結果
同量の事前学習データで比較したところ、HumanScaleは実ロボット遠隔操作データのみで学習したモデルを大きく上回りました。指標ごとの改善幅は次の通りです。
評価指標 | 実ロボットデータのみとの比較 |
|---|---|
ロボット動作予測の検証損失 | 24%低下 |
分布内タスク(学習と同条件の作業)の成功率 | 52.5%向上 |
分布外タスク(未見の状況での作業)の成功率 | 90%向上 |
分布外タスクで特に大きな差が出た点が、この結果の要点です。実ロボットデータで学習したモデルは既知の状況に過学習しやすいのに対し、多様な人間映像で学習したモデルは汎化性能が高いことを示しています。
身体的AIが実世界で活躍するには未知の状況への対応が欠かせず、この知見はロボット学習の設計思想を問い直すものといえます。
なお、物理AIの基盤モデル研究においてはKairosのような世界モデルアプローチも注目を集めており、HumanScaleのデータ戦略とこうした基盤モデルを組み合わせることで、さらなる性能向上が期待されます。
まとめと今後の展望
HumanScaleは「高品質なロボットデータが必要」という従来の常識を覆し、人間の日常映像がより優れた学習源になり得ることを定量的に示しました。フィルタリングとラベリングの工夫次第で、安価かつ大規模なデータ収集が可能になる点は、身体的AIの実用化を加速させる可能性があります。
コードはGitHubで公開されており、研究コミュニティによる検証と拡張が進むとみられます。今後は映像の種類(調理、製造現場、医療など)によるデータ品質の違いや、より大規模なエゴセントリックデータセットへのスケールアップが研究の焦点になるでしょう。


