 AI-Papers
- 人間の一人称視点映像を構造化された物理常識QAペアへ変換し、高価なロボット軌跡データなしにVLAモデルを訓練する新手法を提案
- シーン要素・空間ダイナミクス・行動実行・奥行き情報の4軸から24種類の能力カテゴリに対応するQAを自動生成
- Franka実機での単一物体操作成功率が47.1%から63.3%に向上し、ERQA・PhysBench・SimplerEnvなど複数ベンチマークで最高性能を達成
研究の背景
ロボットが物体を掴む・積む・移動させるといった操作を行うには、物理世界への深い理解が欠かせません。近年、画像・言語・行動を一体で扱うVision-Language-Action(VLA)モデルが急速に発展し、ロボット制御の精度が上がってきました。ただし既存の手法の多くは、ロボット動作の軌跡データを大量に必要とするという問題を抱えています。
ロボット軌跡データの収集にはコストと時間がかかり、多様な物理状況をカバーするには限界があります。
一方で、人間が日常生活で撮影した一人称視点(エゴセントリック)映像はすでに大規模なデータセットとして公開されており、物体の動きや空間配置、手の使い方といった豊富な物理常識を含んでいます。PhysBrain 1.0は、この人間映像の資源を活用してVLAモデルを強化する研究です。
「理解してから行動」設計
PhysBrain 1.0が掲げるのは「理解してから行動する(Understanding first, action next)」という原則です。従来の模倣学習がロボットの動作をそのまま真似ることに頼っていたのに対し、PhysBrain 1.0はまず物理世界の理解を深め、その知識をロボット制御に転移する2段階の構成を採用しました。
具体的には、大規模なエゴセントリック映像を「構造化された物理教師信号」へ変換するデータエンジンを構築し、そのデータでVLM(Vision-Language Model、画像と言語を扱う基盤モデル)を訓練した後、VLAポリシーへと適応させます。
3段階のデータエンジン
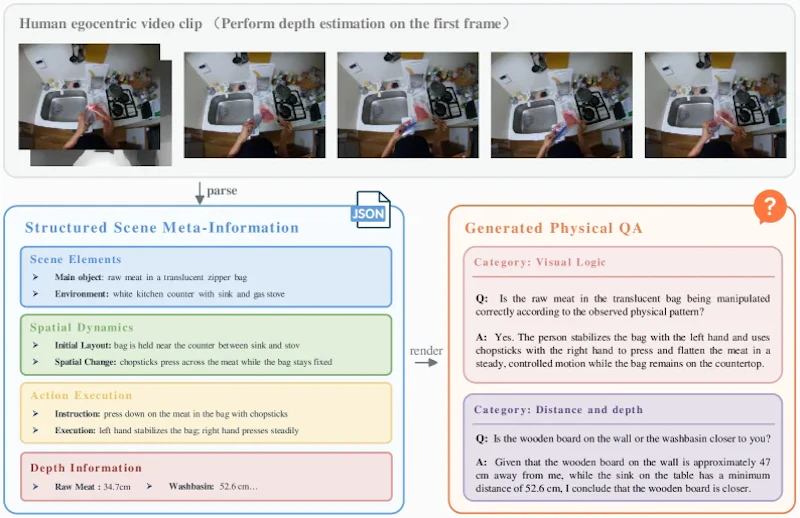
PhysBrain 1.0のデータエンジンは3つのステップで動作します。
第1段階は構造化メタ情報の抽出です。エゴセントリック映像のクリップをJSON形式の記録に変換します。記録に含まれるのは次の3つの情報です。
- シーン要素: 物体の種類・素材・物理状態
- 空間ダイナミクス: レイアウトの初期配置と時間変化
- 行動実行: 指示の概要と詳細な軌跡記述
この記録をもとに、続く2つの段階が動きます。
第2段階は深度対応の空間拡張です。Depth Anything v3というモデルを使い、映像に奥行き情報を付加します。物体の前後関係から実際の距離まで、ロボットの位置制御に必要な空間理解が得られるようになります。
第3段階はQAペアの生成です。抽出されたメタ情報を自然言語の質問・回答ペアへ変換し、空間関係、物体の状態変化、アフォーダンス(物体の操作可能性)、長期計画など24種類の能力カテゴリに対応したQAを作ります。訓練データにはEgo4D、EgoDex、EPICなどの公開エゴセントリックデータセットが活用されています。
VLAへの物理常識転移
物理常識QAで訓練されたVLMをロボット制御に活用するには、VLAへの適切な「転移」が必要です。単純に追加学習を行うと、元々持っていた言語理解や画像認識の能力が損なわれる「破滅的忘却」が起こりえます。
PhysBrain 1.0では「能力保持型・言語感度保持型の適応」という設計を採用し、VLMが学んだ物理常識を維持しながらロボット制御の具体的な行動出力を学習できるようにしました。この適応ステップにより、言語指示に基づいた行動生成がシミュレーション環境と実世界の両方で機能します。
マルチモーダル評価の観点では、MemLensのような長期記憶を問うベンチマークと同様に、PhysBrainのVLMも短期的な視覚認識にとどまらず、シーンの変化や物体の状態を継続的に追跡する能力が求められます。
実験結果
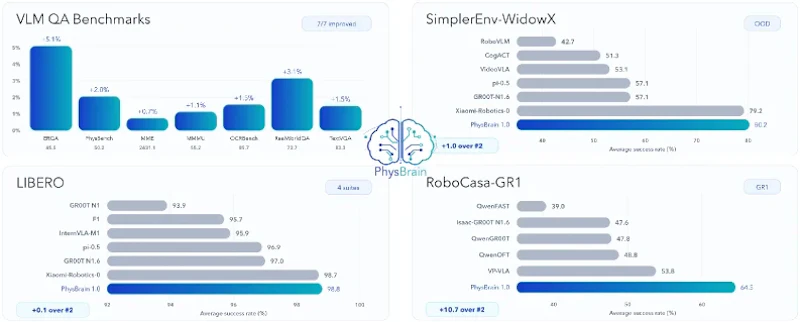
PhysBrain 1.0は複数の評価軸で最高性能を達成しています。マルチモーダルQAの評価指標であるERQA(Embodied Reasoning QA)とPhysBenchでは、いずれも既存手法を上回るスコアを記録しました。
ロボット制御のシミュレーション評価では、SimplerEnv-WidowX、LIBERO、RoboCasaの3つのベンチマークすべてで最高性能となり、特にドメイン外(学習環境と異なる場面)での汎化性能の高さが示されています。
実世界のFrankaロボットを使った実験の結果は次の表のとおりです。
タスク | 導入前 | PhysBrain 1.0 |
|---|---|---|
単一物体の操作 | 47.1% | 63.3% |
長期タスク(複数の操作ステップを連続実行) | 31.0% | 45.0% |
単一物体の操作成功率は約16ポイントの向上となりました。これらの成果は、ロボット軌跡データを一切使わずに達成されたものです。
まとめと今後の展望
PhysBrain 1.0は、人間のエゴセントリック映像という既存の大規模データを活用することで、ロボット訓練のコストを大きく削減しながら物理常識の学習を実現しました。「高価なロボットデータがなければスケールできない」という従来の制約に対して、現実的な代替アプローチを示した研究といえます。
今後はより多様な環境での検証や、さらに複雑な物体操作タスクへの拡張が期待されます。エゴセントリックデータの規模が増えるほど性能が向上する可能性もあり、公開ビデオデータの活用がロボティクス研究を前に進める有力な手段になりそうです。
論文情報: "PhysBrain 1.0 Technical Report"(Shijie Lian et al., 2026) arXiv:2605.15298
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


