 AI-Papers
- 正答しながら誤った箇所を引用する「帰属ハルシネーション」を定量化する、711本PDF・1,897問・7ドメイン・2言語の文書VQAベンチマーク
- 回答と引用領域の両方が正確な場合のみ正解とするSAA(Strict Attributed Accuracy)で評価し、最強モデルGemini-3.1-Pro-Previewでも76.0%にとどまる
- 法務・金融など高信頼性が求められる実用領域で、現行の文書AIが抱える引用精度の深刻なギャップを体系的に実証
研究の背景
文書を読んで質問に答える文書VQA(Visual Question Answering)は、企業の契約書分析や学術論文の検索など、実務への応用が広がっています。しかし従来の評価手法には大きな盲点がありました。モデルが「正しい答え」を返したとしても、その根拠を文書のどの箇所から引いたかは問われないのです。
この問題が深刻な理由は、モデルが偶発的に正解を出力しながら、全く関係ない段落や表を証拠として引用するケースが実際に起きているからです。法務契約書や財務報告書では、根拠箇所の正確な特定が回答そのものと同じくらい重要な意味を持ちます。
帰属ハルシネーションとは
研究チームはこの現象を「帰属ハルシネーション(Attribution Hallucination)」と定義しています。従来のハルシネーション(幻覚)が「存在しない情報を生成する」問題であるのに対し、帰属ハルシネーションは「正しい答えを返しながら、誤った箇所を証拠として示す」という、より発見しにくい失敗モードです。
MemLensのようなマルチモーダル評価研究でも最先端モデルが実用水準を大きく下回ることが示されていましたが、引用の正確性という観点からの定量評価はこれまでほとんど行われてきませんでした。CiteVQAはその空白を埋める存在です。
SAAメトリクスの仕組み
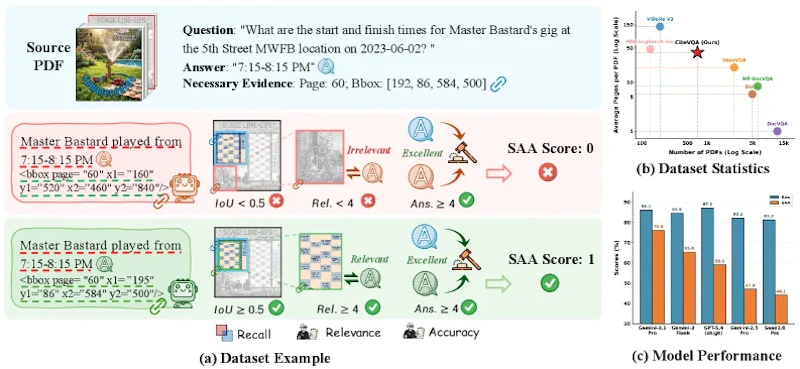
CiteVQAが導入する評価指標「SAA(Strict Attributed Accuracy)」は、2つの条件を同時に満たしたときだけ正解とカウントする厳格な基準です。1つ目は回答の正確さ、2つ目は文書内の根拠箇所(バウンディングボックス)が実際の証拠領域と一致していること。どちらか一方でも誤っていれば、スコアは0となります。
この設計により、「正答しているのに低スコア」というケースが浮き彫りになります。たとえばGPT-5.4は回答精度87.1%という高い水準を達成していながら、SAA換算では59.0%にとどまる結果でした。この約28ポイントのギャップが、帰属ハルシネーションの深刻さを端的に示しています。
ベンチマークの構成
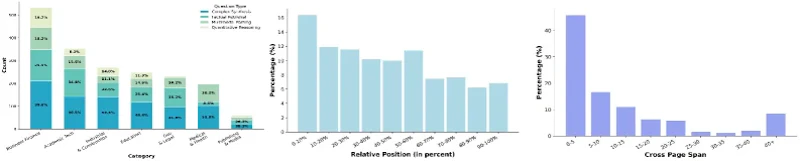
CiteVQAは711本のPDFと1,897問から成り立っており、1文書あたりの平均ページ数は40.6ページです。実業務で扱うような長文文書を対象としており、7つのドメイン(法務、金融、学術、技術、医療など)と2言語(英語・中国語)をカバーしています。単一ドメインや短文書に偏りがちな既存ベンチマークとは、一線を画す構成です。
データ収集には自動パイプラインが採用されています。複数文書のセマンティックリンキングから始まり、PDFパーサーの出力を証拠チェーンとして連結した後、実際のQ&Aペアをテンプレート化して新問題を合成する三段階の工程です。最終的にMLLMによる検証と証拠アブレーション(証拠の削除実験)で「決定的証拠」を特定する構成となっています。
主要な実験結果
20種類のMLLMを評価した結果、最高スコアを記録したGemini-3.1-Pro-PreviewのSAAは76.0%でした。一方でオープンソースモデルの最高値は22.5%にとどまり、クローズドモデルとの差は50ポイント以上に達します。
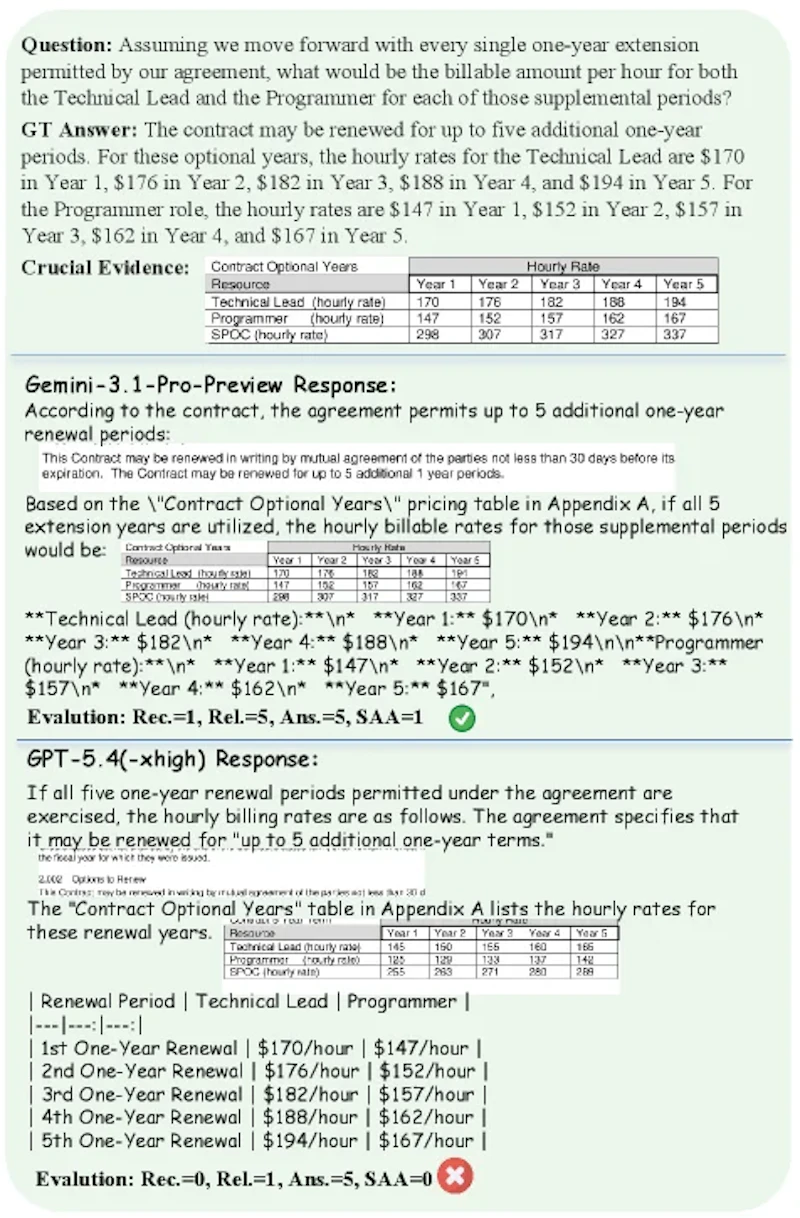
図9のケーススタディが示すとおり、2つのモデルがともに「5」という正答を出力しても、根拠として参照したテーブルが異なれば評価結果は大きく変わります。このような失敗は、モデルが文書の構造的な文脈を十分に把握できていないことを示唆する結果です。
ドメイン別では法務や金融でSAAが低く、質問タイプ別では数値計算や複数段落にまたがる推論で特に精度が落ちることも明らかになりました。証拠が複数ページに散在するケースほど引用の正確性が下がる傾向にあり、長文文書への対応が引き続き課題といえます。
まとめと今後の展望
CiteVQAは、文書AIにおける「帰属ハルシネーション」という問題を初めて体系的に定量化したベンチマークです。回答精度とSAAの乖離は、単に「正しい答えを返すこと」だけでは実用的な信頼性に届かないことを明確に示しています。
コードとデータはGitHubで公開済みで再現性が確保されており、法務や金融など高い信頼性が求められる領域でのAI活用に向けた研究の土台として機能するでしょう。今後は引用精度を直接改善するファインチューニング手法や、RAG(検索拡張生成)との組み合わせによる証拠局在化の改善が主要な研究方向になると考えられます。
論文情報: "CiteVQA: Benchmarking Evidence Attribution for Trustworthy Document Intelligence"(Dongsheng Ma et al., 2026) arXiv:2605.12882
本記事の図(図1、図4、図9)は解説のため上記論文より引用しています。


