 AI-Papers
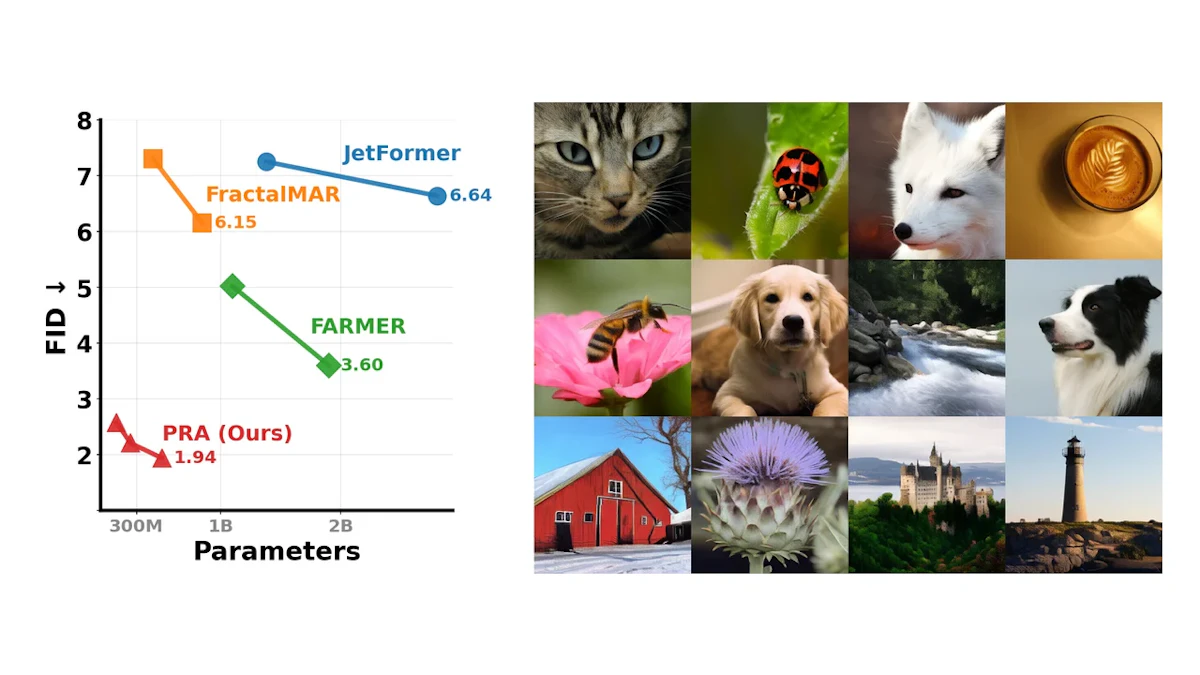
- ピクセルARの「高次元パッチ誤差」と「学習推論乖離」を並列ロールアウト近似(PRA)という1つのフレームワークで同時に解決
- PRA-L(511Mパラメータ)がImageNet 256×256でFID 1.94を達成し、10億超パラメータの従来最高性能(FID 3.60)を大幅に上回る
- 線形プローブ分類精度68.80%を記録し、高品質な生成と豊かな視覚表現の両立も示された
研究の背景
画像生成の主流は現在、潜在拡散モデルや潜在空間の自己回帰(AR)モデルが占めています。一方、ピクセル値をそのまま次のトークンとして予測する「ピクセル空間AR」は構造がシンプルで、テキスト生成と同じパイプラインで画像理解と生成を統合できる魅力を持ちます。
しかし長年にわたり、ピクセル空間ARは潜在拡散モデルや潜在ARモデルに生成品質で大きく劣ってきました。北京大学の研究チームはこの性能差の根本原因を2つの構造的な課題として特定し、それを同時に解決する手法「並列ロールアウト近似(PRA)」を提案しました。
ピクセルARが抱える2つの課題
課題は入力側と出力側の両面に存在します。
出力側(高次元パッチ誤差): 1つの16×16ピクセルパッチは768次元のベクトルです。この高次元空間を1ステップで直接予測すると誤差が積み重なりやすくなります。潜在ARモデルが低次元の潜在空間で予測するのと比べ、ピクセルARははるかに難しい問題を解いていることになります。
入力側(学習と推論の乖離): ARモデルの標準的な学習手法「教師強制(teacher forcing)」では、学習時に正解のピクセル値を前の入力として与えます。しかし推論(画像生成)時は、モデル自身が生成したピクセル値を次の入力として使います。この食い違いが学習と推論の動作を噛み合わなくさせ、生成品質を下げる原因になります。
PRAの仕組み
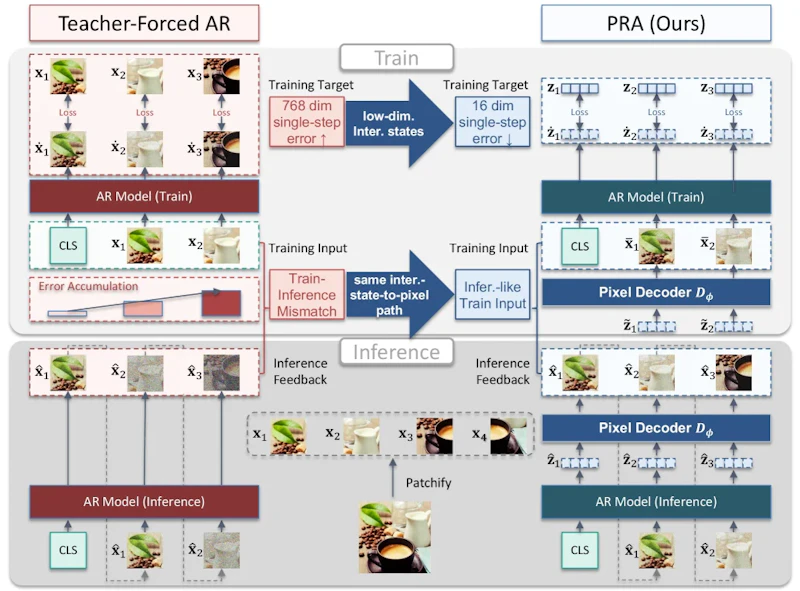
PRAは4つのコンポーネントで構成されます。中心となる因果ARトランスフォーマーは過去のピクセル入力から次位置の「中間状態」を予測します。この中間状態はわずか16次元であり、768次元の直接予測と比べて精度が大きく向上します。
予測した中間状態はピクセルデコーダで768次元のピクセルパッチへ変換されます。高次元予測という難しい問題を「低次元予測」と「次元変換」の2段階に分割することで、出力側の誤差を大幅に抑えます。また、拡散ヘッドが整流化フロー(rectified flow)目標で中間状態の分布をモデル化し、生成の多様性も確保します。
入力側の課題には「並列ロールアウト近似」の核心アイデアが対応します。学習時に、各位置で推論時と同じピクセルデコーダを並列に適用して「推論時に近いピクセル入力」を構築します。逐次ロールアウトと違い各位置を独立に処理するため計算コストは通常の学習とほぼ変わりません。これにより、モデルは推論時に近い条件を学習時から経験できます。
実験結果
ImageNet 1K(256×256解像度)のクラス条件付き画像生成での主要な結果を次の表に示します。
モデル | パラメータ | FID(↓) | IS(↑) |
|---|---|---|---|
FARMER | 1.9B | 3.60 | 269.2 |
JiT-L | 459M | 2.36 | 298.5 |
PRA-S | 135M | 2.58 | 273.9 |
PRA-B | 250M | 2.23 | 281.2 |
PRA-L | 511M | 1.94 | 287.3 |
135MパラメータのPRA-Sが10億パラメータ超のFARMER(FID 3.60)を上回っており、PRAの高いパラメータ効率が確認できます。511MパラメータのPRA-LはFID 1.94を達成し、ピクセル空間ARモデルとして初めてFID 2を下回りました。
生成品質だけでなく、表現学習能力でも優れた結果が出ています。学習済みバックボーンをそのまま使った線形プローブ分類では、PRA-LがImageNet top-1精度68.80%を記録。同規模の潜在ARモデルSphereAR-L(52.19%)やピクセル拡散モデルJiT-L(42.76%)を大きく超えます。ピクセル空間で直接学習することが、豊かな視覚表現の獲得に寄与していると考えられます。
まとめと今後の展望
PRAは、ピクセル空間ARという直感的な設計が適切な工夫によって拡散モデルに匹敵する生成品質を実現できることを示しました。2つの課題をそれぞれ独立に解決するモジュール設計が機能し、135Mという小型モデルが10億パラメータ超の従来手法を上回るパラメータ効率も実証されています。
生成モデルにおける学習と推論の乖離を縮める取り組みは、DanceOPDのようなオンポリシー蒸留フレームワークなど様々な方向から進んでいます。PRAはARモデルという異なるアプローチで同様の課題を解決した点で、画像生成モデルの設計に新たな視点をもたらす研究と言えます。
一方で、学習時に並列フォワードパスを2回実行するため計算コストは標準的なARモデルより増加します。また、実験はImageNet 256×256に限定されており、高解像度や他のデータセットでの検証はこれからです。著者たちは画像理解と生成を同一のピクセル空間モデルで統合する方向性を今後の研究課題として挙げており、マルチモーダルな統合モデルへの発展が期待されます。
論文情報: "Parallel Rollout Approximation for Pixel-Space Autoregressive Image Generation"(Jiayi Xu, Di He, Guolin Ke, 2026) arXiv:2606.27978, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


