 AI-Papers
- DiTの融合された重み行列にMuonをそのまま適用すると生じる「暗黙的な部分空間結合」を特定し、更新方向が歪む原因を突き止めました
- 重み行列を機能ごとに独立した成分へ分割してから直交化するChunked Muon(CMuon)を提案し、vanilla Muonの後期収束停滞を克服しています
- 675MパラメータのDiTでImageNet 256のFID 1.18を200エポックで達成し、AdamW比で2倍以上の訓練高速化を実現しました
研究の背景
拡散トランスフォーマー(Diffusion Transformer、以下DiT)は、画像生成や動画生成で高い品質を実現する基盤モデルとして広く使われています。一方でDiTの訓練には膨大な計算コストがかかり、より少ないエポック数で高い品質に到達させる訓練の高速化が、研究と実用の両面で重要な課題になっています。
この文脈で近年注目を集めているのがMuonという最適化手法です。Muonは重み行列に対する勾配の移動平均(モメンタム、過去の更新方向を平均して滑らかにしたもの)を直交化してから更新に使う仕組みで、更新方向のバランスを整えることで大規模言語モデルの訓練を大きく高速化できることが示されてきました。この成功を受けて、DiTの訓練にもMuonを応用したいという期待が高まっていました。
ところが本論文の著者らは、Muonを画像生成のDiTにそのまま適用すると、訓練の後半で収束が伸び悩み、期待したほどの効果が得られないことを発見しました。ECCV 2026に採択された本研究は、その原因を分析し、シンプルな改良で解決する手法を提案しています。
Muonが抱える落とし穴
問題の根っこは、DiTのアーキテクチャそのものにあります。DiTでは計算効率を高めるため、機能的に役割の異なる複数の重みを1つの大きなテンソル(多次元配列)に融合してまとめる設計が一般的です。代表的なのが、条件情報をブロックに注入するAdaLN(Adaptive Layer Normalization)の各パラメータや、Attention機構で使うQ(クエリ)、K(キー)、V(バリュー)を1つにまとめたQKV層です。
Muonの直交化は、こうした融合された重み行列を「1つのまとまり」として扱い、行列全体をまたいで方向を整えようとします。しかし本来は独立して働くべき成分どうしが、直交化の計算を通じて互いに干渉してしまいます。著者らはこれを暗黙的な部分空間結合(implicit subspace coupling)と名付けました。異なる機能を担う部分空間が意図せず結び付き、その結果として更新方向が歪められ、全体の最適化が劣化してしまうのです。
これがMuon本来の性能を引き出せない理由であり、DiTへの単純な適用が後期の収束停滞を招く直接の原因でした。
CMuonの仕組み
提案手法のCMuon(Chunked Muon)の発想は明快です。融合された重み行列を直交化する前に、機能ごとの独立した部分成分へ分割(chunk)し、そのchunkごとに個別に直交化を行います。1回の大きな直交化を、複数の小さな直交化へ置き換えるイメージです。
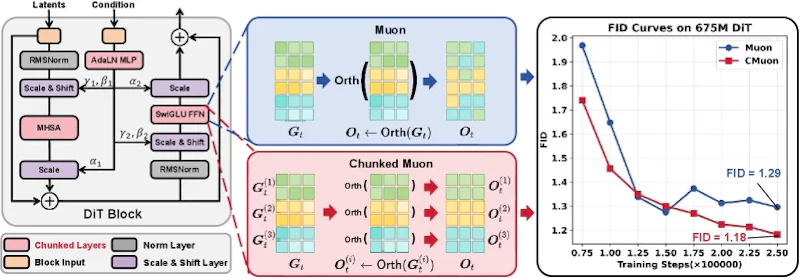
この分割によって、AdaLNやQKVのように役割の異なる成分が同じ直交化に巻き込まれることがなくなり、暗黙的な部分空間結合が解消されます。各成分は自分に適した方向へ更新されるため、更新方向の歪みが取り除かれ、最適化の安定性と効率が向上します。
重要なのは、CMuonがモデルの構造や損失関数を一切変えず、最適化の計算対象を「行列全体」から「機能ごとのchunk」へ切り替えるだけで済む点です。既存のDiT訓練へ組み込みやすく、追加の複雑さも小さいため、汎用的に使える改良になっています。DiTの訓練効率化という観点では、線形注意でDiTを高速化するChimeraのようなアーキテクチャ側の工夫とも補完的な関係にあります。
実験結果
著者らはImageNet 256の画像生成タスクで、675MパラメータのDiTを訓練して評価しました。生成品質の指標には、実画像の分布との近さを測るFID(Fréchet Inception Distance、値が小さいほど高品質)を用いています。
CMuonは200エポックの訓練でFID 1.18を達成しました。従来の標準的な最適化手法であるAdamWと比べて2倍以上の訓練高速化に相当し、同じ品質へより短い訓練で到達できることを示しています。さらに、素のMuon(vanilla Muon)で見られた後期段階の収束プラトー(性能が頭打ちになる停滞)も効果的に克服しました。
項目 | 内容 |
|---|---|
モデル | 675M パラメータの DiT |
データセット | ImageNet 256×256 |
FID | 1.18(200エポック) |
AdamW との比較 | 2倍以上の訓練高速化 |
vanilla Muon との比較 | 後期の収束停滞を解消 |
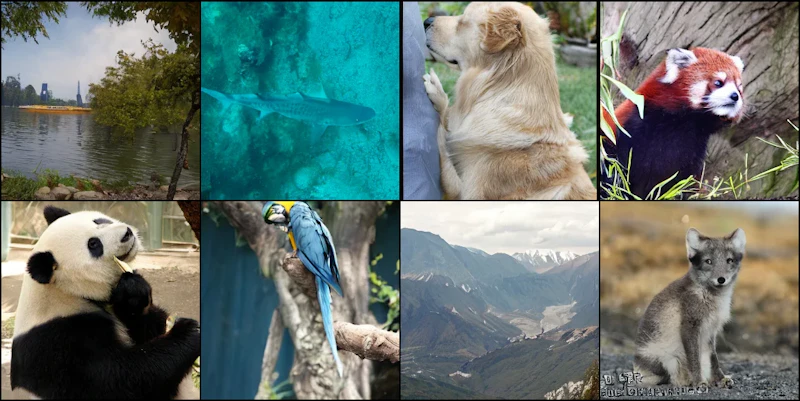
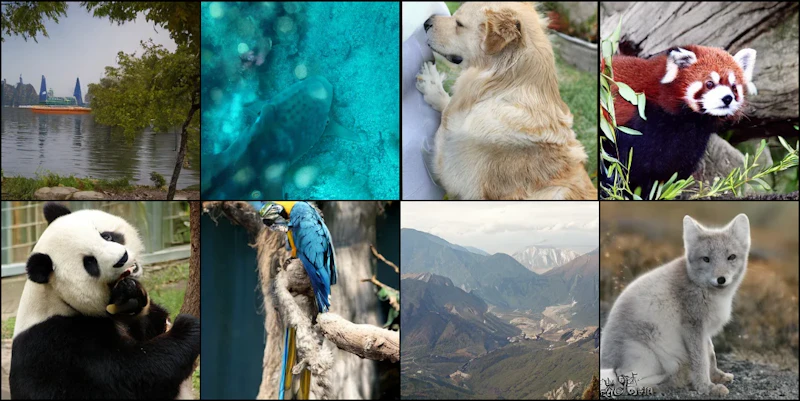
生成サンプルの比較でも、CMuonで訓練したモデルの方がより安定した品質の画像を生成できることが示されています。同じMuon系の手法でありながら、分割直交化の有無だけで結果に差が出る点が、暗黙的な部分空間結合の影響の大きさを裏付けています。
まとめと今後の展望
CMuonは、DiT特有のアーキテクチャとMuonの直交化が噛み合わない原因を「暗黙的な部分空間結合」として明確に言語化し、重み行列を機能ごとに分割してから直交化するという直感的な解決策で応えた研究です。モデル構造を変えずに導入でき、AdamW比2倍以上の高速化とvanilla Muonの収束停滞の克服を同時に達成した点は、実装者にとって実用的な価値が高いと言えます。
一方で、本論文の公開情報からは、追加の計算コストの詳細な内訳や、動画生成など256×256以外のより大規模なDiTへの効果は十分に読み取れません。chunkの分割単位をどう選ぶのが最適かという設計の余地も残されています。今後は他の生成タスクやさらに大きなモデルでの検証が進むことで、DiT訓練の標準的な最適化手法として定着していくかが焦点になりそうです。
論文情報: "CMuon: Accelerating and Stabilizing Diffusion Transformer Training via Chunked Momentum Orthogonalization"(Chuyan Chen, Peng Sun, Kun Yuan, 2026) arXiv:2608.02502
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


