 AI-Papers
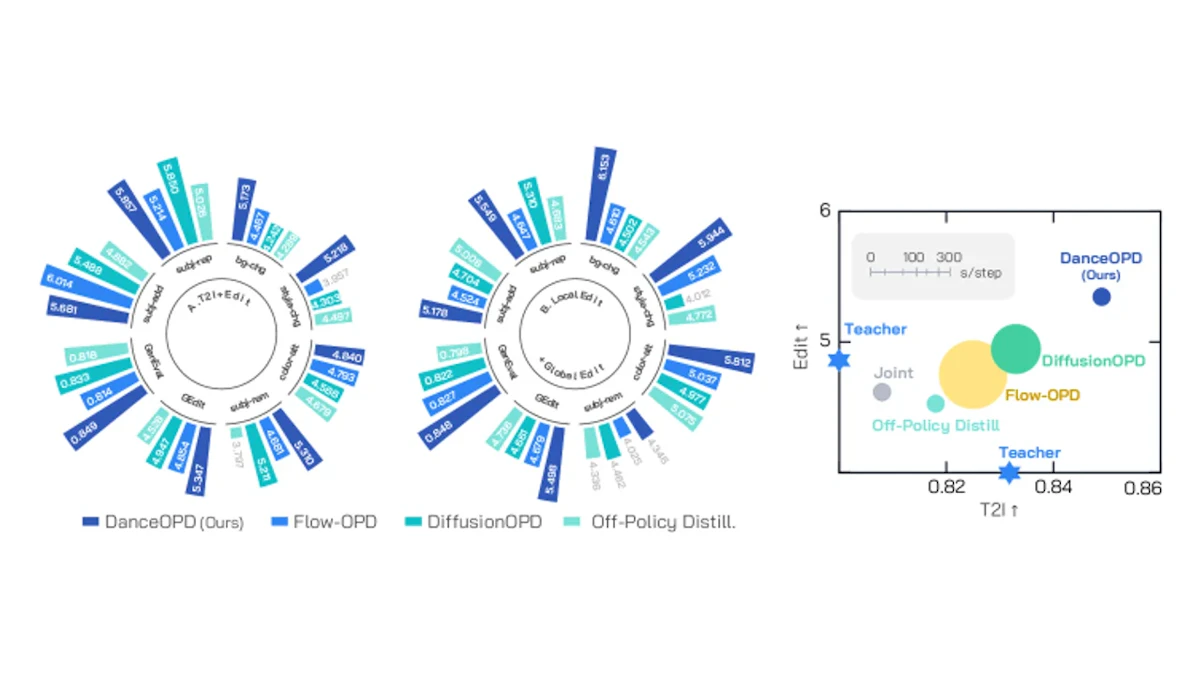
- 各能力を共有フロー空間上の独立した速度フィールドとして定義し、ハードルーティングで1サンプルに1フィールドだけ割り当てることで能力干渉を回避
- 学生モデル自身の現在のロールアウトステートでフィールドを照会するオンポリシー設計により、最良ベースライン比でGEditBenchスコアが最大16.1%向上
- T2I生成品質をほぼ維持(差分0.1%以内)しながら複数の編集能力を同時強化。リアリズムフィールド吸収でも報酬スコアが9.9%改善
研究の背景
テキストから画像を生成する機能(T2I)と、既存の画像を指示に沿って書き換えるローカル・グローバル編集を1つのモデルに統合する試みが増えています。しかし複数の能力を同じモデルへ同時に学習させると、「能力干渉」と呼ばれる問題が起きます。ある能力を強化すると別の能力の品質が下がり、両立が難しいのです。
近年注目を集めるFlow Matching(ノイズからデータへの変換経路を直線化した拡散モデルの改良版)ベースのモデルでは、複数の凍結した教師モデルから学生モデルへ知識を移す「オフポリシー蒸留」が用いられてきました。ただしこの手法では、教師モデルを照会する状態と学生モデルが実際に生成する状態の間にズレが生じ、性能が安定しないという課題があります。ByteDance Seedの研究チームが提案するDanceOPDは、このズレを根本から解消するフレームワークです。
DanceOPDの手法
DanceOPDの核心は、T2I生成・ローカル編集・グローバル編集などの各能力を「共有フロー空間上の速度フィールド」として統一的に扱う点にあります。それぞれの凍結済み教師モデルを独立した速度フィールドとして定義することで、異なるフィールドを1つの学生モデルへ同時に蒸留できる設計になっています。CFG(Classifier-Free Guidance)のようにモデルを組み合わせる操作で定義したフィールドも同じ枠組みで扱えます。
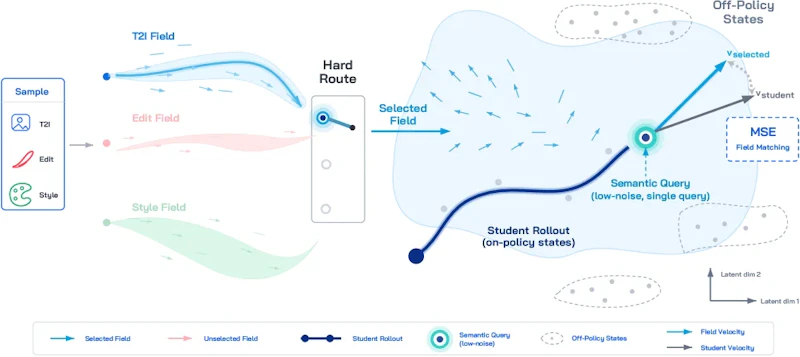
学習ではハードルーティングを採用します。各学習サンプルをちょうど1つの能力フィールドに割り当て、そのフィールドだけを監督信号として使います。複数フィールドを平均した曖昧な目標で学習する「ソフト混合」と比べ、ハードルーティングは平均スコアで約15.2%高い結果を示しています。
「オンポリシー」という設計がもう一つの重要な工夫です。従来のオフポリシー手法が固定データセットの状態で教師を照会するのに対し、DanceOPDは学生モデルが現在生成している状態(ロールアウトステート)で直接フィールドを照会します。これにより教師と学生の状態のズレが解消され、より正確な監督信号が得られます。照会するタイムステップには「低ノイズ側(意味論的情報が豊かな段階)」を選ぶことが有効で、中程度ノイズのタイムステップと比較して約23.7%の改善が確認されています。損失関数はシンプルな速度MSEのみで、学習コストも低く抑えられています。
実験結果と評価
DanceOPDはT2I生成と編集能力の統合、ローカル・グローバル編集の統合、リアリズムフィールドの吸収という複数の設定で評価されています。T2Iと編集能力の統合では、GEditBench(編集品質を測るベンチマーク)がオフポリシーベースラインから8.1%、GenEval(T2I品質のベンチマーク)がT2Iソースから2.0%向上しました。
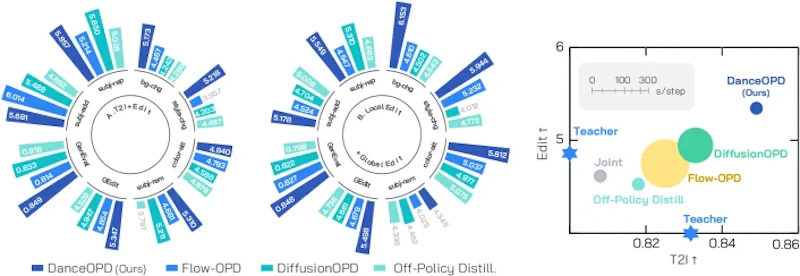
ローカルとグローバル編集を統合する設定ではさらに大きな改善が見られ、最良ベースラインと比べてGEditBenchが16.1%向上しています。特に背景変更のカテゴリでは33.5%という大幅な改善を達成しました。リアリズムフィールドを吸収する実験でも、オフポリシー蒸留に対して報酬スコアが9.9%向上し、T2I品質は0.1%以内の差に抑えられました。
消去実験では、ハードルーティングと低ノイズ側のタイムステップ照会がとくに効果的であることが確認されています。複数タイムステップを同時に照会する「密集クエリ」は単一クエリより7.9〜16.6%低い結果にとどまり、シンプルな設計の方が安定して機能することも示されました。
まとめ
DanceOPDは、Flow Matchingモデルにおける多能力統合の課題に対し、能力フィールドの分離・ハードルーティング・オンポリシー照会という3つの設計原則でシンプルかつ効果的に対処するフレームワークです。複数の能力を1つのモデルへ統合するアプローチは、Ask, Solve, Generateのような自律進化型マルチモーダル学習とも方向性が重なります。生成AIをより汎用的にしようとする流れの中で、DanceOPDが示す「フィールドとして能力を定義する」枠組みは、今後の統合モデル開発に参考になる視点を提供しています。
論文情報: "DanceOPD: On-Policy Generative Field Distillation"(Wei Zhou et al., 2026) arXiv:2606.27377, CC BY-SA 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


