 AI-Papers
- 12.5万時間の動画と1.6億件のイベント記述で学習し、テキスト・画像・ロボット行動の3モダリティを単一モデルで扱う「世界基盤モデル(World Foundation Model)」を提案
- 「無意識学習(動画)」と「意識学習(言語イベント記述)」の2段階学習で、ベースモデルQwen3.5-4Bと比べて状態遷移理解を12.27ポイント向上
- 実環境ロボット操作でも進捗スコア36.6%を達成し、比較手法π0.5(27.6%)を大きく上回る回復力のある行動生成を実現
研究の背景と問題意識
現在のAI研究では、テキスト生成・画像生成・ロボット制御といった異なるタスクを、それぞれ専用のモデルが担うのが一般的です。しかし人間は、言葉を話し、目で見た光景を理解し、体を動かすという能力を、脳という一つの器官で統合して実行しています。
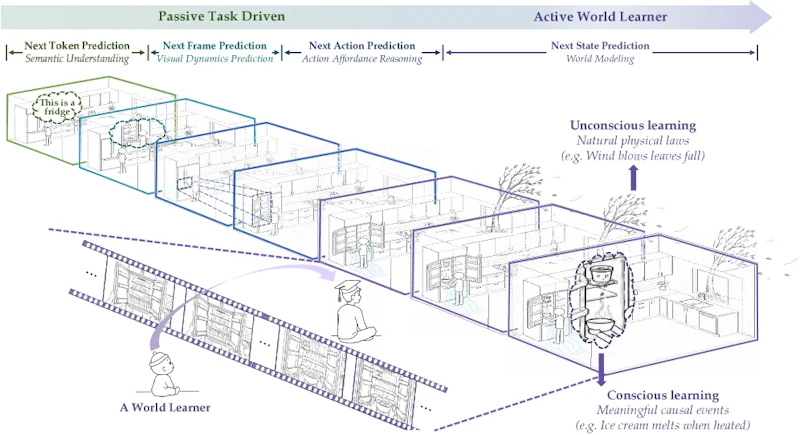
この分断を解消しようとするのが、57名の研究者チームが提案する世界基盤モデル「Orca」です。テキスト・画像・ロボット行動を単一のモデルに統合するにあたり、Orcaが採用したのは「次状態予測(Next-State-Prediction)」という新しいパラダイムです。従来モデルが「次のトークン(単語の断片)」や「次のフレーム(画像の1コマ)」という個別の対象を予測するのに対し、Orcaは「次の世界の状態」という抽象的な目標を全モダリティで共有します。
全体アーキテクチャの概要
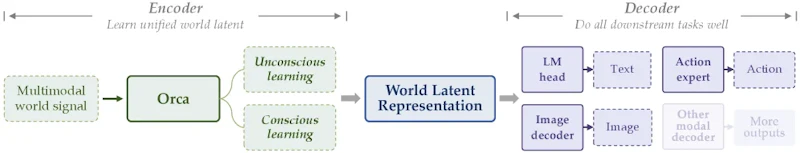
Orcaはエンコーダ・デコーダ構成を採用しています。エンコーダが動画・テキスト・行動記録などの多様な入力を受け取り、「世界潜在空間(world latent)」と呼ぶ共通の内部表現へ変換します。デコーダはその表現を読み取り、テキスト・画像・ロボット行動など各モダリティの出力を生成します。
ベースにはQwen3.5(0.8Bおよび4Bパラメータ版)を使用。エンコーダは事前学習で学習させ、その後は凍結します。各モダリティ専用の軽量デコーダのみを個別に学習させる設計により、事前学習で得た世界表現の汎用性を直接検証できます。
2段階の学習パラダイム
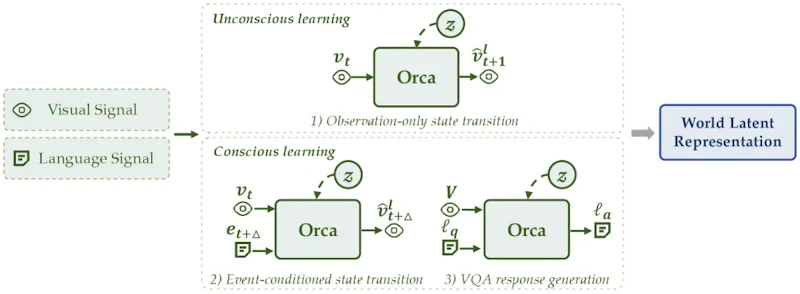
Orcaの学習設計で最も特徴的なのが、「無意識学習」と「意識学習」という2段階のアプローチです。
無意識学習は、12.5万時間分の動画データ(現行版では12,500時間を使用)から、場面が自然に変化していく「密な状態遷移」をとらえます。言語ラベルを必要とせず、映像の流れを見るだけで物理的な世界のダイナミクスを吸収します。人間が言葉を覚える前から世界の仕組みを体験的に学ぶ過程に相当します。
意識学習は、1.6億件のイベントアノテーション(「コップが倒れた」「ロボットがつかんだ」のような言語記述付き状態変化)と1,150万件のVQA(視覚的な質問と回答のペア)データを活用します。言語が明示的な条件として機能し、意味的に重要な「疎な状態遷移」を学習させます。
3つのモダリティへの展開
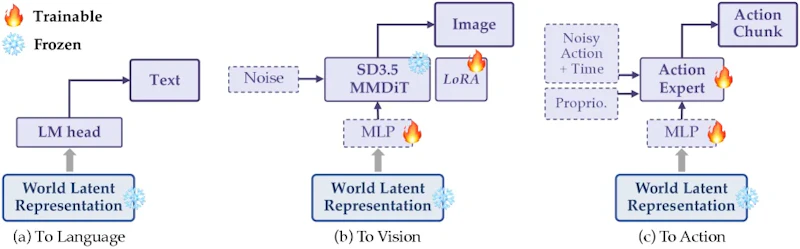
凍結されたエンコーダの上に、用途に応じた3種類の軽量デコーダを接続します。
- テキスト出力: 既存の言語モデルヘッドをそのまま再利用するため追加学習コストが小さい
- 画像出力: MLP変換層と、LoRA(一部のパラメータのみを効率的に再学習する手法)を凍結した画像生成モデルSD3.5に適用することで高品質な画像予測を実現
- ロボット行動出力: MLP変換層と、DiT(画像生成で使われる拡散変換器モデル)ベースのAction Expertをゼロから学習。Action Expertは世界潜在空間・関節角度や速度などロボット自身が把握する状態(固有感覚状態)・ノイズ付き行動を入力として受け取り、連続行動シーケンスを生成します
エンコーダを凍結したまま各デコーダを別々に学習させても性能が出ることで、事前学習で獲得した世界潜在空間が複数のモダリティにわたって有効であることが裏付けられています。
実験結果
テキスト理解の評価では、Orca-4Bが4つのビデオ理解ベンチマーク平均で51.8%を達成しました。ベースモデルのQwen3.5-4Bと比較すると、状態遷移の理解で+12.27ポイント(64.13%)、動的な物体の動き理解で+8.52ポイント(65.55%)、常識的推論で+5.19ポイント(62.95%)の改善が確認されています。
画像予測ベンチマークPRICE-V0.1では、Orca-4Bが59.8点(±10.9)を獲得し、FLUX.2(56.1点)、FLUX.1-Kontext(40.9点)、OmniGen2(39.6点)をすべて上回りました。特に不可逆的な物理変化を含む場面での改善が顕著でした。
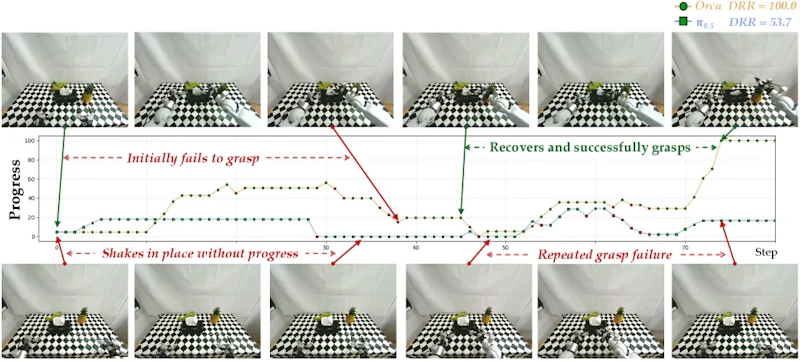
実環境でのロボット操作テスト(環境が未知なOOD設定)では、進捗スコアが36.6%に達し、比較手法π0.5の27.6%を9ポイント上回りました。またロボット操作向け世界モデルで重要とされる失敗からの回復能力(Drawdown Recovery Ratio)でも、Orcaが30.3%対π0.5の26.7%と優位でした。
スケーリングの特性
0.8Bと4Bの2つのモデルサイズで学習損失と下流性能を測定したところ、データ量とモデル規模の両方に対してスケーリング則が成立することが確認されました。動画データの使用量を0から12,500時間まで増やすにつれて損失が継続的に低下し、3つのモダリティすべてで下流性能が向上しています。なお現行版が使用しているのはデータ全体の10%にすぎず、残りの90%を活用した場合の伸び代は大きいとされています。
まとめと今後の展望
Orcaは「次状態予測」という統一パラダイムのもと、テキスト・画像・ロボット行動という3つのモダリティを一つのエンコーダで統合することに成功しました。2段階の学習設計と軽量デコーダへの展開により、同規模の特化型モデルを複数のベンチマークで上回ることが実証されています。
課題も残ります。未知の物体に対するロボット操作(Object OOD設定)ではOrcaが28.2%に対しπ0.5が31.2%と逆転されており、物体の汎化にはまだ改善の余地があります。また現在使用しているのは学習データ全体の10%のみであるため、フルスケールでの学習が性能に与える影響は未検証の状態です。
今後の展開としては、長時間ビデオの理解・自律ロボットへの実用応用・音声や触覚などさらなるモダリティの統合が焦点になると考えられます。「世界を理解し、どのモダリティにも展開できる汎用表現」という方向性は、AIが真の意味で世界モデルを内部に持つことへの重要な前進です。
論文情報: "Orca: The World is in Your Mind"(Yihao Wang et al., 2026) arXiv:2606.30534
本記事の図(図1〜図5)は解説のため上記論文より引用しています。


