 AI-Papers
- ピクセルレベルの軌跡アライメントとセマンティックな関係アライメントの2段階損失でロボット映像の物理的整合性を大幅に向上させる
- R-Benchで最大22.3%改善、WorldArenaのクローズドループ成功率を16.0%から24.0%に引き上げることを実証
- 補助モデルを推論時に除外するため追加コストなし、14Bから16Bまで複数の大規模バックボーンへの適用で一貫した改善を確認
研究の背景と課題
ロボットが実際の場面で操作を学ぶには、大量の試行錯誤が必要です。物理シミュレータを使えばリスクなく繰り返せますが、従来のシミュレータはリアルな映像を生成できず、現実との乖離(ドメインギャップ)が常に問題でした。
近年、大規模なビデオ生成モデルを「ワールドシミュレータ」として活用する研究が進んでいます。しかし既存のモデルは見た目の自然さを優先して学習するため、ロボットアームが物体を押したときの変形や、把持時の位置一貫性といった物理的に正確な挙動の再現が苦手です。
均一な再構成目標で学習すると、物理的に重要な接触領域と単純な背景を区別できないことが根本原因として挙げられます。この課題に対して、NVIDIA らのグループが提案したのが PhysisForcing です。
PhysisForcing の設計思想
PhysisForcing は既存のビデオ生成モデルを微調整する際に、2種類の物理的整合性損失を追加する学習フレームワークです。補助モデルは学習時にのみ使用し、推論時には除外する設計のため、デプロイ後のコスト増加は生じません。
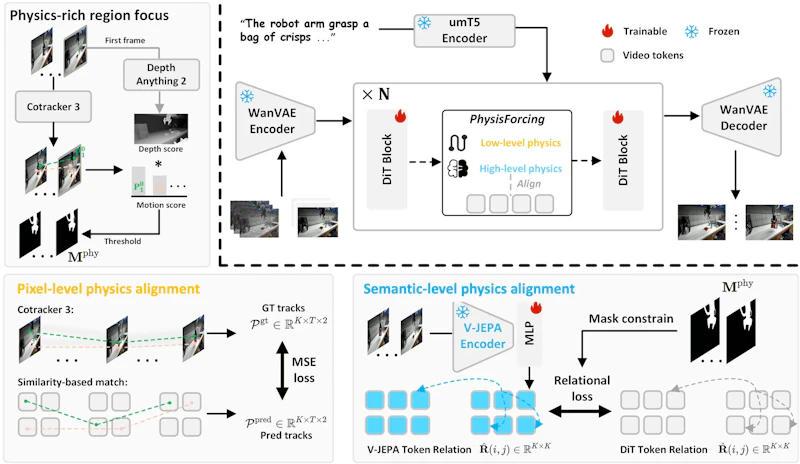
手法の出発点は「物理的整合性には階層がある」という観察です。まず点追跡モデル CoTracker3 を使って各フレームの密な軌跡を取得し、動き量と前景の深度情報を組み合わせた物理情報スコアを計算します。
このスコアが高い領域、つまり接触や動きが生じている重要な領域だけに損失を集中させることで、背景ノイズに引きずられない学習を実現しています。
2段階の損失関数
追加される損失は次の2つです。
- ピクセルレベル軌跡アライメント損失: 拡散変換器(DiT)の中間層特徴から点の軌跡を直接予測し、実際の軌跡と照合する
- セマンティックレベル関係アライメント損失: 凍結された動画理解エンコーダ V-JEPA 2 を教師として、領域間の関係を揃える
前者では、クエリフレームの特徴とキーフレームの特徴を比較して位置を推定し、マスクされた相互作用領域のみに MSE 損失を適用します。接触時の変形や位置の連続性を映像生成モデルが学習する仕組みです。
後者では、ロボット・物体・背景という領域間のペアワイズ類似度行列を DiT とエンコーダの両方で計算し、その差を最小化します。「押された物体は移動する」「把持された物体はグリッパーに追従する」といった意味的な関係を映像生成に組み込む狙いです。
アブレーション実験によると、2つの損失は相補的で、どちらか一方だけより両方を組み合わせた場合に最も高い性能が得られます。また DiT の中間ブロック(第15層)で損失を適用することが最適と判明しており、浅すぎても深すぎても精度が低下しました。
実験結果
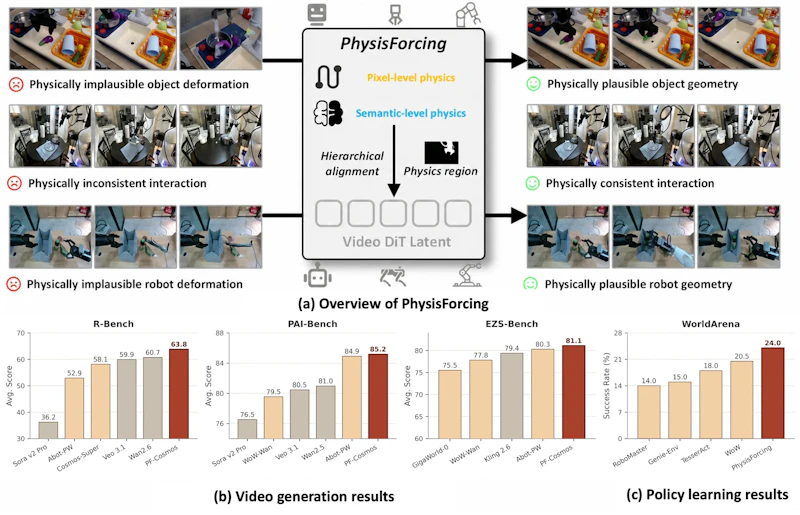
評価には3つのベンチマークが使われています。ロボット操作映像の物理的妥当性を測る R-Bench では、Wan2.2-I2V-A14B をバックボーンにした PF-Wan が62.0点を記録し、バニラ微調整より22.3%の向上を達成しました。Cosmos3-Nano ベースの PF-Cosmos は63.8点で同9.2%の改善です。
映像の品質と専門性を総合評価する PAI-Bench では、PF-Cosmos が85.2点を記録し、商用モデルの Wan2.6 や Abot-PhysWorld(84.9)を上回りました。さらに学習データに含まれない196のロボット・タスク・場面の組み合わせを対象としたゼロショットベンチマーク EZS-Bench でも81.1点を達成しています。
ベンチマーク | PF-Wan | PF-Cosmos |
|---|---|---|
R-Bench | 62.0点(+22.3%) | 63.8点(+9.2%) |
PAI-Bench | - | 85.2点 |
EZS-Bench(ゼロショット) | - | 81.1点 |
いずれのベンチマークでも、バックボーンの違いによらず改善が確認できています。
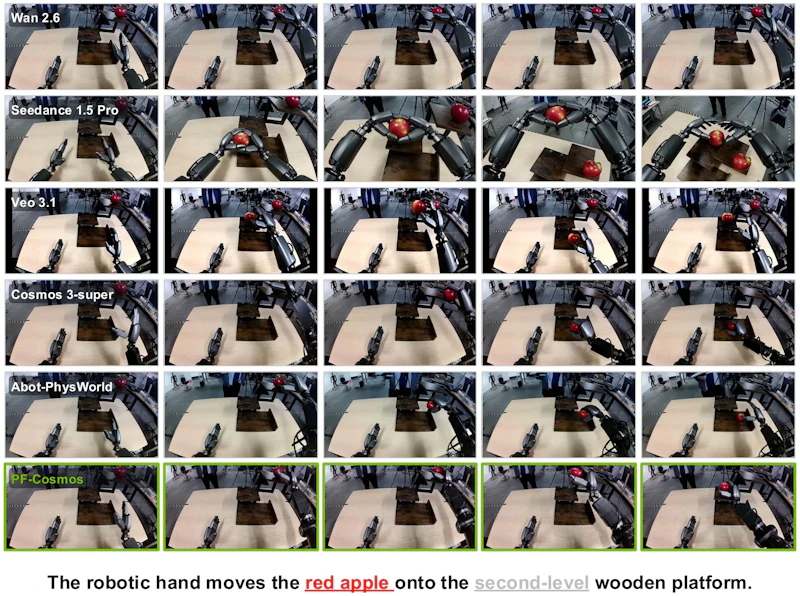
ロボットの実制御への波及効果も確認されています。WorldArena のクローズドループ評価では成功率が16.0%から24.0%に向上し、RoboTwin 2.0 タスクでは平均成功率が68.2%から72.8%に改善しました。
接触が多いカップ配置タスクでは+21.5%という大きな向上が見られており、物理的に正確な映像がロボット方策の学習に直接役立つことを示しています。
物理シミュレーションをニューラルネットワークに組み込む研究は他にも進行しており、PhysiFormerのような3Dメッシュの物理挙動を拡散変換器で予測する手法も報告されています。PhysisForcing は既存の大規模ビデオ生成モデルを微調整するだけで機能するため、モデルのスケールを問わず適用しやすい点が強みです。
まとめと今後の展望
PhysisForcing はビデオ生成モデルの微調整時に2段階の物理的整合性損失を加えるだけで、映像品質とロボット方策の両方を大きく向上させます。補助モデルを推論時に除外できるため、既存の大規模ベースモデルへの適用コストは微調整の計算のみです。
課題としては、バックボーンモデルの能力に性能の上限が左右される点と、現在のオープンソース動画生成モデルが長期的な時間推論において制限を持つ点が挙げられています。また実世界でのロボット動作との整合性検証はまだ限定的で、今後の研究が求められます。
コードは GitHub で公開されており、異なるベースモデルへの適用実験が広がることで、物理的に正確なワールドシミュレータの研究がさらに前進すると考えられます。
論文情報: "PhysisForcing: Physics Reinforced World Simulator for Robotic Manipulation"(Peiwen Zhang et al., 2026) arXiv:2606.28128
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


