 AI-Papers
- OpenAIが自律エージェントのパイプラインでLinuxカーネルを監査し、948件の固有なローカル権限昇格脆弱性を実際に悪用可能な形で検証
- 検出だけでなく概念実証コードの実行、エクスプロイト開発、948件分の修正パッチ生成まで一連の工程を自動化
- エンドツーエンドのAPI利用料は約121万ドル、報奨金換算では16〜55倍の価値に相当すると試算
948件の権限昇格を検証
OpenAIは2026年11月、自律エージェントを組み合わせたセキュリティ研究用のパイプラインでLinuxカーネルを監査し、948件の固有なローカル権限昇格(LPE)脆弱性を発見して実際に悪用できることを確認したと発表しました。ローカル権限昇格とは、低権限のユーザーがカーネルの不具合を突いてroot権限を奪う類型の脆弱性です。
スキャンは2026年10月中旬時点の最新カーネルに対して実施されました。従来のAI活用は脆弱性の「候補を挙げる」段階にとどまることが多かったのに対し、今回は動作する攻撃コードの作成と修正パッチの生成まで含んでいる点が異なります。
OpenAIは同じ構成を段階的に強化してきており、モデルの世代が上がるにつれて検出数が増えています。
時期 | モデル | 固有LPE数 | API費用 |
|---|---|---|---|
2026年6月 | GPT-5.5 Cyber | 24件 | 非公開 |
2026年7月下旬 | GPT-5.6 Sol | 166件 | 513,690ドル |
2026年10月中旬 | 新しいサイバー向けモデル | 948件 | 1,213,430ドル |
パイプラインの構成
パイプラインは役割の異なるエージェントを直列につなぎ、各段で候補を絞り込む設計です。まずScoutエージェントが低権限ユーザーから到達可能で security 上の重要度が高い箇所を選び、約280万行(カーネル全体の約7%)にわたる5,034件の監査対象を3,426ドルで特定しました。続いてAnalystエージェントが12時間で重複排除済みの候補2,308件を挙げ、ここに316,549ドルを要しています。
次の段では、トリアージを担うエージェントが概念実証プログラムを書き、KASAN(カーネルのメモリ破壊検出機構)を有効にした隔離仮想マシンで実行します。特別な権限を必要とせずメモリ破壊が再現したものだけを残し、30時間で1,724件、候補の約74.7%が検証を通過しました。
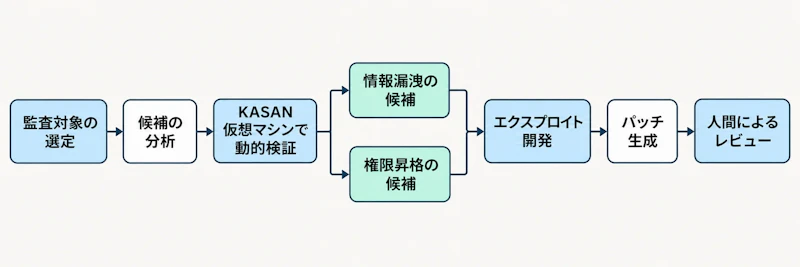
図1のように、検証を通った脆弱性はその後の選別で情報漏洩の候補313件とLPE候補1,238件に分かれます。ExploitDevエージェントがSMEP、SMAP、KASLR、HARDENED_USERCOPYといった標準的な保護機構を有効にした環境で攻撃を試み、情報漏洩の概念実証291件と動作するLPEエクスプロイト1,169件が得られました。最後に脆弱性ごとのパッチを生成し、同種の不具合が他にないかを確認する亜種分析を経て、人間の研究者が内容と深刻度を点検してから報告しています。
費用と見積もられた価値
成功したエクスプロイト1件あたりの開発費は平均約359ドルでした。OpenAIはPwn2OwnやTyphoonPWNの過去の報奨金額を948件に当てはめ、1,890万ドルから6,630万ドル相当、すなわちパイプラインの費用の16倍から55倍にあたると試算しています。
Googleの脆弱性報奨プログラムであるkernelCTFの堅牢化カーネルを対象にした試験では、112時間で情報漏洩25件とLPE 21件を約32,936ドルで獲得し、想定報奨額は約150万ドル、費用の約45倍と見積もられました。この試験では費用の83.7%が探索段階に集中しており、どこを重点的に効率化すべきかも示されています。
検証で判明した弱点
成功と判定された200件のエクスプロイトを精査したところ、20件が割り当てられた脆弱性とは別のゼロデイでroot権限を取得していました。OpenAIはこれを受け、各エクスプロイトが指定の脆弱性を実際に使っているかを独立に検証する工程を追加しています。
パッチの品質にも課題が見られました。初期の生成結果は機能的には正しくても冗長で、カーネルの作法と合わなかったり修正が不完全だったりする例があり、反復と敵対的レビューで改善したとされています。一方で、このパイプラインは人間が書いた既存パッチの不備も検出しました。
失敗要因の分析では、分析自体が誤っていた候補は3.1%にとどまり、多くは必要な権限の壁、再現が難しい競合状態、時間制限によるものでした。1時間進展がなければ打ち切るような撤退規則を入れれば、無駄な試行の費用を抑えられると述べています。足場(オーケストレーション)の必要量はモデルの能力に反比例し、GPT-5.5 Cyberでは103種の攻撃技法を与えることで63候補に対する成功率が76.2%から88.9%に上がった一方、新しい世代では同じ補助の効果が約1.5ポイントにとどまりました。
報告と修正の進捗
報告はLinuxカーネルコミュニティの指針に沿って深刻なものから順に進められ、Patch the Planetの枠組みとパートナー経由で数百件の報告とパッチが送られています。公開スキャンから10日の時点で、61件のLPEは上流に取り込まれ、43件はステージング段階のパッチがあり、299件が公開の場で議論されている状況です。
OpenAIはこの取り組みをオープンソース支援の枠組みであるDaybreakの一部と位置づけ、今後は対象をほかの重要ソフトウェアへ広げ、メンテナーやセキュリティ事業者と協力して自動パッチ適用の信頼性を高める方針を示しています。同社は防御側が先回りして自社ソフトウェアを解析し、攻撃者側の採算が合わない状態を作るべきだとも述べました。GoogleがGemini 4 Carbonでサイバー防御を強化したように、攻撃と防御の双方でモデルの能力が直接的な成果に結び付く段階に入っています。
なお公開された結果は10月中旬のカーネルに対するもので、その後に取り込まれたパッチによって無効になる指摘も含まれるため、再検証が必要だと注意書きが添えられています。新たに見つかった10種の攻撃技法については、安全上の理由から詳細が伏せられました。


