 AI-Papers
- OpenAIはCodexによる並列開発の急増で既存のGitホスティングが限界を迎え、Git互換の独自バックエンド「Pando」を自社開発したと公開しました
- 信頼性が一時90%を下回る状態から、本番導入後は中央値のpush遅延を約5分の1(約80%削減)に改善し、1日あたり約1ペタバイトのGitデータを配信しています
- 設計は1人のエンジニアが担い、実装はエージェントのチームが行い、着手から本番投入まで約10週間だったとしています
Pandoとは何か
OpenAIは2026年11月、社内のモノレポ(単一の巨大リポジトリ)を支えるために自社開発したGit互換バックエンド「Pando」について、技術解説を公開しました。Gitそのものを置き換えるのではなく、Gitのプロトコルとクライアントとの完全な互換性を保ったまま、サーバー側の実装だけを作り直すという方針を採っています。
開発者が使うコマンドやワークフローは従来のままで、裏側のストレージと配信経路を入れ替えた形です。実装言語はRustで、既存システムからの依存を引き継がないゼロからの構築だったと説明されています。
設計目標として挙げられているのは3点です。多数のブランチへの同時pushを前提とした書き込みの水平スケール、クライアントが手元の帯域を使い切れる読み出しスループット、そしてGitプロトコルとの完全な互換性です。
Codexが押し上げた負荷
きっかけはコーディングエージェントCodexの社内普及でした。エージェントによる並列開発が進むと、ブランチ、push、マージの数が増えるだけでなく、開発環境や研究ジョブ、CI(継続的インテグレーション)からのfetchやcloneも同時に増えます。
前年末ごろからモノレポを支える仕組みが追いつかなくなり、fetchとpushの遅延、マージの失敗が発生し、信頼性が一時的に90%を下回ったと記述されています。10回に1回以上の操作が失敗する状態は、エージェントが人間より高い頻度でリポジトリに触れる環境では、開発速度そのものを直接削ぐ要因になります。
Codexの利用拡大は社内に限った話ではなく、OpenAIは一般ユーザー向けにもChatGPTへの統合と利用枠の共通化を進めています。エージェントが書くコードの量が増えれば、同じ負荷は他社の開発基盤にも順に現れると考えられます。
3層で構成される内部構造
Pandoは、受け取ったパックファイル(Gitがオブジェクトをまとめて転送する形式)をそのまま不変のブロブとして保存するストレージ層、ブランチの参照先を管理する水平スケール可能なメタデータストア、そして配信を担うキャッシュ層で構成されます。pushの検証はストリーミング中に行われ、パックを展開せずに処理されます。
ブランチ更新のたびに「ref version」と呼ばれる記録が作られ、新しい先端、対応するパック、依存する過去のバージョンを保持します。参照ポインタの更新は複数キーのトランザクションで原子的に行われ、1回のpushに必要なメタデータ操作はO(1)に収まるとされています。
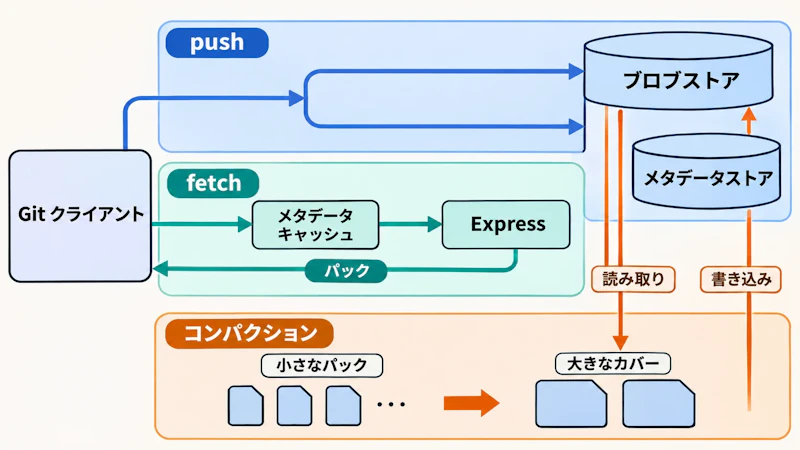
図1のように、読み出しはpushとは別経路をたどります。クライアントのhaves(持っているオブジェクト)とwants(欲しいオブジェクト)をref versionに対応付けたうえで、実際のデータは`packfile-uri`のリンクとして返され、「Express」と呼ばれる地域キャッシュサービスが一貫性ハッシュでパックを配信します。
各pushが生む最小単位は「L0」パックファイルで、背景ワーカーがこれを幾何級数的に大きなまとまりへ統合していきます。LSMツリーのコンパクションに近い考え方で、モノレポでは最大L4までの階層が使われており、ファイル数を抑えてfetch計画の計算量をおおむね対数的に保ちます。
整合性モデルは因果的一貫性で、異なるブランチへの書き込みは互いに独立して進み、個々のrefについては直列化可能性が保証されます。一方でリポジトリ全体の時点スナップショットは提供されません。既定ではpush時にtrunk(主幹ブランチ)のみをベースとして広告するため広告データは小さく済みますが、派生ブランチへのpushでは余分なオブジェクトを送り直す場合があるという割り切りをしています。
本番での効果と数値
Pandoは今年4月から本番トラフィックを処理しており、公開されている主な数値は次の通りです。
項目 | 値 |
|---|---|
中央値のpush遅延 | 約5分の1(約80%削減) |
1日あたりの配信データ量 | 約1ペタバイト |
1時間の最大配信量 | 57テラバイト超 |
ローカルディスクキャッシュ率 | 99%超 |
ブランチpushのパックサイズ | 中央値20KiB未満、99パーセンタイル3MiB未満 |
サーバー側の仕事はネゴシエーションとパック選択が中心のため、特別なハードウェアは不要で、標準的なクラウドVMでもcloneとfetchの検証時に10Gbpsのリンクを飽和させたとしています。同時にpushするクライアントは「数千規模」まで検証済みという記述もあります。
設計検討の段階では、3相コミット方式は負荷時に書き込み遅延が悪化し、WAL(先行書き込みログ)ベースの設計は読み出し遅延が悪化することがシミュレーションで示されたため、現在の構成が選ばれました。検証にはGitの適合性テストスイート、決定論的シミュレーションテスト、LeanとTLA+による形式仕様、エージェントによる継続的なレッドチーミングが組み合わされています。
無停止で進めた移行
移行は既存システムに対する読み書きのプロキシとして始まり、両系統を同期させながらダウンタイムなしで進められました。Pandoへのpushがキャッシュを温める副作用で、旧バックエンドの信頼性も改善したとのことです。
クライアント側はGit CLIを包む社内ラッパーを通じて段階的に切り替え、OpenAI独自のGit配布物を開発機とChatGPTデスクトップアプリに配りました。旧APIやwebhook、ダウンロードに依存していた数百の連携も移行対象となり、開発者自身の環境移行はCodexのスキルが支援したと説明されています。
開発体制も特徴的です。中核の設計は1人のエンジニアが担い、実装はエージェントのチームが行い、デプロイは少数のエンジニアが担当しました。着手から本番投入までは約10週間で、Codexを使って構築したこと自体が成果の一部として示されています。
Git本体への還元
一連の作業の過程で得られた改善の一部は、上流のGitにも取り込まれています。`packfile-uri`の対応強化、パックのダウンロードと生成のトレース、独立したパックの並列ダウンロードとインデックス作成、中断や再開を伴う転送の修正などが含まれます。
「explicit haves」も提案されており、サーバーがブランチの先端と、クライアントが省略してよい履歴を分けて広告できるようになります。これにより`--force-with-lease`の検査をtrunkに対して行えるようになるとしています。
Pando自体のソースコードは現時点で公開されていません。OpenAIは社内の他用途への展開、特に多数のエージェントが1つの共有リポジトリで協働するワークロードへの拡大を進めるとともに、この技術を利用者と共有する方法を検討中だと述べています。
エージェント前提の開発基盤
Pandoの事例が示すのは、コーディングエージェントの普及がモデルやツールの話で終わらず、バージョン管理の基盤設計にまで及ぶという点です。ブランチ単位で独立に書き込みがスケールする設計、リポジトリ全体のスナップショットを諦める割り切り、派生ブランチの転送量を犠牲にして広告を小さくする選択は、いずれも人間の作業ペースを前提にした設計では必要性が薄かったものです。
自社でGitバックエンドを書き直せる組織は限られますが、同時pushの並列度やfetch帯域が将来のボトルネックになるという見立ては、エージェントを本格導入する開発チームにとって検討材料になります。既存のGitホスティング各社がこの負荷にどう応えるかも、今後の判断材料となるでしょう。


