 AI-Papers
- Anthropicが2026年11月2日、AIの応答が指定されたモデルの重みから生成されたことをzkSNARKで証明する「FlashProve」をApache 2.0ライセンスで公開した
- Llama 4 Maverickの4ビット量子化版で、H100 1基あたり毎秒約110トークンの証明生成、1024トークンで証明サイズ約19MB、24コアCPUで約17秒の検証を実現
- 対象はMoEモデルかつ1024トークンまで、貪欲法前提で、改ざんを未然に防ぐのではなく事後に検知する研究プロトタイプという位置づけ
応答の出所を検証する
Anthropicは2026年11月2日(現地時間)、AIの応答が特定のモデルから生成されたことを暗号学的に証明する仕組み「FlashProve」を公開しました。同社のFrontier Red Teamが、スイス連邦工科大学ローザンヌ校(EPFL)とマサチューセッツ工科大学(MIT)の研究者と共同で開発したもので、コードと技術文書がApache 2.0ライセンスでGitHubに置かれています。
現在、API経由でLLM(Large Language Model、大規模言語モデル)を使う利用者には、返ってきた応答が本当に指定したモデルのものかを確かめる手段がありません。想定される問題として、ルーティングサービスがコスト削減のために安価なモデルへ密かに差し替えるケースや、攻撃者が推論サーバを乗っ取って応答を書き換えるケースが挙げられています。
出力の文章を読んだだけでは、どのモデルが生成したのかを判別するのは困難です。多くのモデルは重みが非公開で、仮に重みを入手できたとしても、同じ計算を再現して照合するには一般の利用者や第三者評価機関には用意できない計算資源が必要になります。
zkSNARKによる証明の流れ
FlashProveが使うzkSNARKは、ある計算が正しく実行されたことを、計算の中身を明かさずに短い証明で示す暗号技術です。ブロックチェーン分野で実用化が進んでいる手法を、LLMの推論に適用しています。
手順は2段階に分かれます。モデル提供者はあらかじめ、モデルの重みに対応する短い「指紋」(コミットメント)を公開しておきます。そして応答を返すたびに、「この重みを持つモデルが、このプロンプトからこの出力を生成した」ことを示す証明ファイルを作成します。
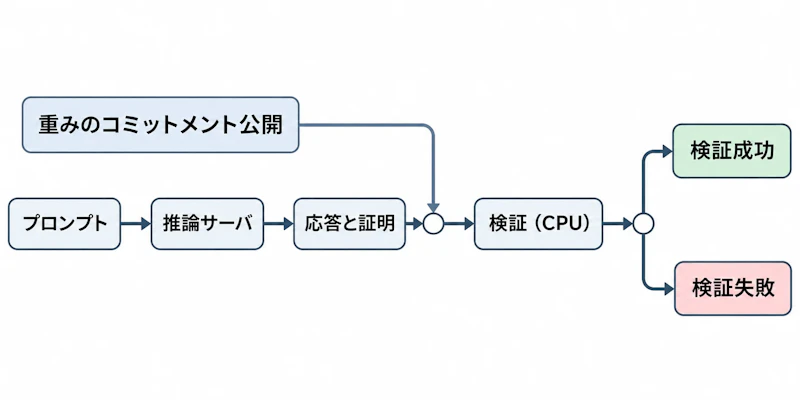
図1のように、受け取った側は公開されたコミットメントと証明を突き合わせることで、GPUを持たないPCでも検証できます。別のモデルが生成した出力であれば検証は失敗します。証明から重みの情報は漏れませんが、モデルのアーキテクチャは秘匿の対象外です。
既存手法との性能差
性能評価にはMetaのLlama 4 Maverickが使われました。4000億パラメータのMixture of Experts(MoE、入力ごとに一部の専門家ネットワークだけを使う構成)の4ビット量子化版です。同じモデルを対象とした既存のオープンソースの取り組みとの比較は次のとおりです。
項目 | FlashProve | 既存OSS |
|---|---|---|
証明生成(約1000トークン) | 約9秒相当(毎秒110トークン) | 14.3時間 |
証明サイズ | 約19MB(1024トークン) | 93.6GB |
検証時間 | 約17秒(24コアCPU) | 記載なし |
証明生成はNVIDIA H100 1基で毎秒約110トークンという速度です。ただし、通常の推論と比べて70〜95倍のGPU時間を要するため、全トラフィックに適用するには依然としてコストが重いと言えます。
Leanによる形式検証
開発プロセスにも特徴があります。従来システムの性能改善はClaudeが担当し、実行コードの多くもAIが生成しました。AnthropicはOpenSSHの攻撃対象領域削減でも同様にClaudeを使っており、セキュリティ領域でのAI活用を進めています。
一方で、AIが構築した大規模で複雑なシステムは、個々の判断の妥当性を人間が評価しにくいという問題があります。そこで主要なセキュリティ性質を形式検証言語Leanで数学的に証明し、第三者が監査できる形で公開しました。
残された制約
FlashProveは研究用のプロトタイプ段階であり、制約が複数あります。対象はMoEモデルに限られ、扱えるコンテキストは1024トークンまでです。証明の対象は整数化したモデルで、常に最も確率の高いトークンを選ぶgreedy decoding(貪欲法)を前提とします。
また、証明は応答を返した後に生成されるため、改ざんを未然に防ぐのではなく事後に検知する仕組みです。想定用途としては、第三者評価機関が評価対象と実際に提供されているモデルの同一性を確認するケース、推論サーバが乗っ取られた際の改ざん検知、承認済みモデルのみの提供を求める規制への準拠確認が挙げられています。
同社の「Frontier Safety Roadmap」には、出力を特定のモデルの重みに紐付けて検証する技術のプロトタイプを9月30日までに開発する目標がありました。この目標は、推論トラフィックに署名して信頼できるサーバで再計算する別プロジェクトで達成済みとされており、FlashProveは同じ目的を暗号学的な手法で追求する取り組みとして位置づけられています。Anthropicは完成品ではなく研究の途中経過の共有だと説明しています。


