 AI-Papers
- GPT-4.1のReActエージェントはAppWorldで平均成功率77.4%だが、5回すべて成功したタスクは53.0%にとどまる
- IBM ResearchのALTK-Evolveは軌跡から指針を自動生成し、この差を24.4ポイントから12.0ポイントに縮小
- Consistency Analyzerは正解データも環境再現も不要で、追加のモデル呼び出し1回で脆い判断箇所を特定する
平均点では見えない不安定さ
AIエージェントの評価では、同じタスクを複数回実行して成功率の平均を取る指標が一般的です。IBM Researchは、この平均値が実運用での信頼性を隠してしまうと指摘しています。
同社が公開した記事によると、GPT-4.1を使ったReActエージェント(推論と行動を交互に繰り返す方式)をAppWorldのテストセット168タスクで評価したところ、5回試行の平均成功率(Mean@5)は77.4%でした。一方で、5回すべてに成功したタスクの割合(Pass^5)は53.0%にとどまります。
差は24.4ポイントです。つまり全体の4分の1近くのタスクは「解けることもあれば解けないこともある」状態であり、平均値だけを見ていると成功したように見えてしまいます。IBMはこの差を一貫性ギャップと呼び、業務に組み込むエージェントでは平均性能よりも再現性が重要になると整理しました。
Mean@kとPass^kの違い
2つの指標の性質は明確に異なります。Mean@kはk回の試行での平均成功率を測るもので、ベンチマークの比較に長く使われてきました。Pass^kはk回すべてで成功したタスクの割合を測るため、1回でも失敗すればそのタスクは不合格になります。
請求処理やカレンダー操作のように、同じ手順を毎日繰り返す業務では、10回のうち8回しか通らないワークフローは実質的に使えません。Pass^kはこうした運用条件に近い評価軸だといえます。
ALTK-Evolveの仕組み
ALTK-Evolveは、エージェントの実行軌跡(trajectory)を再利用可能な指針に変換し、推論時にエージェントへ与えるフレームワークです。モデルの再学習を行わず、蓄積された実行ログから運用知識を抽出する設計になっています。
中核となる診断部品がConsistency Analyzerです。記録済みの軌跡の各ステップについて、その時点の文脈をモデルに再投入し、k個(既定値は5)の候補出力をまとめて生成させます。候補が一致していればその判断は安定しており、ばらついていればそこが失敗の分岐点になり得ると判定します。
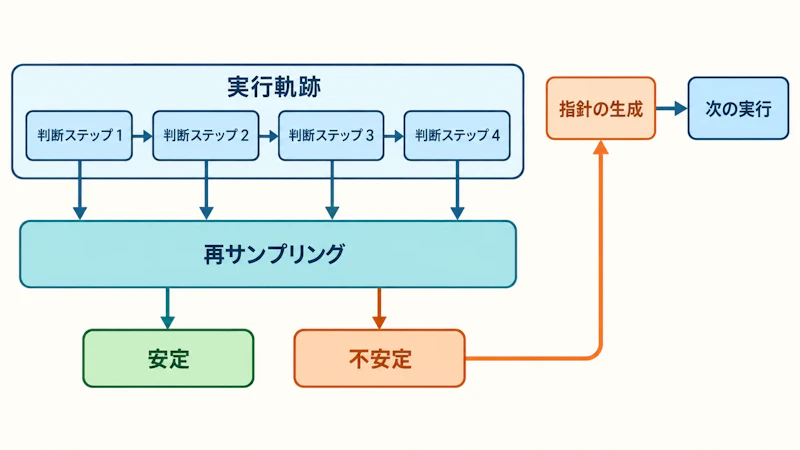
図1のように、この手法には正解ラベルも環境の再現実行も必要ありません。既存のトレース1本と、決定箇所でのモデル出力の再サンプリングだけで済むため、追加コストは1回のモデル呼び出しに抑えられます。長時間かかる環境シミュレーションを回さずに診断できる点が、実務での導入しやすさにつながります。
24.4から12.0ポイントへ
特定された脆弱箇所から生成した一貫性指針をエージェントに与え、改めて5回の試行で評価した結果が以下の通りです。指針はタスクごとに1本のベースライン軌跡から作られ、新規の5回実行で検証されました。
指標 | 指針あり | ベースライン |
|---|---|---|
Mean@5(平均成功率) | 81.0% | 77.4% |
Pass^5(全試行成功率) | 69.0% | 53.0% |
一貫性ギャップ | 12.0pt | 24.4pt |
平均成功率の伸びが3.6ポイントであるのに対し、Pass^5は16ポイント改善しています。つまり、新しく解けるようになったタスクが増えたというより、もともと解けていたタスクを毎回解けるようになった効果が大きいことを示しています。
難易度別では中程度のタスクが22.9ポイント、難しいタスクが14.3ポイント向上しました。さらに、同じシナリオ内の関連タスクへ指針を転用した場合も13.0ポイントの改善が確認されており、1タスク専用のパッチではなく汎用性のある知識として機能していることがうかがえます。過去の実行履歴を資産として再利用する発想は、Dream-RSIのような探索履歴の再活用手法とも共通します。
開発者が試せる形で公開
ALTK-EvolveはオープンソースとしてGitHubで公開され、技術的な詳細はarXivの技術レポートにまとめられています。導入時に押さえておきたい前提は次の点です。
- 入力は記録済みの実行軌跡1本のみで、正解データは不要
- 環境の再実行を伴わないため、診断のコストは追加のモデル呼び出し1回
- 再学習ではなく推論時の指針注入なので、既存のエージェント構成に後付けできる
- 報告値はAppWorldの168タスクとGPT-4.1のReAct構成に基づく
エージェントを業務に組み込む段階では、ベンチマークの平均スコアだけでは失敗コストを見積もれません。Pass^kのような再現性の指標を評価項目に加え、不安定な判断箇所を特定して指針として残す手順は、社内エージェントの品質管理にそのまま応用できる考え方です。


