 AI-Papers
- Googleが音声対話向けの Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking を公開し、Gemini API と Google AI Studio で同日から利用可能になりました
- 会話の途中で97言語を自動判別して切り替え、near-realtime の視覚入力処理で目の前の状況を踏まえた応答を返します
- Extended Thinking は τ-Voice で68.6%、Big Bench Audio で97.7%、Artificial Analysis の音声品質指数で82.6を記録しました
2つのモデルを同時公開
Googleは2026年9月15日、音声対話に特化した2つのモデル Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking を公開しました。いずれも Gemini API と Google AI Studio から開発者が即日利用できます。
2モデルは想定する用途が分かれています。Gemini 3.8 Live は低コストで大規模に展開することを前提に、会話の自然さと視覚的な状況把握を両立させた構成です。一方の Extended Thinking は、複数の手順を踏む複雑なタスクを扱う企業向けで、推論の深さを優先しています。
音声AIの評価軸は、単に発話が自然かどうかだけではありません。会話を止めずにツールを呼び出せるか、相手の言い直しに追従できるか、途中で言語が変わっても崩れないかといった実務的な要素が問われます。今回の発表はその部分に踏み込んだものです。
ベンチマークの結果
Google が公開した数値では、Extended Thinking が複数の音声系ベンチマークで上位を占めています。特に Artificial Analysis の Speech to Speech Quality Index では総合1位となりました。
評価項目 | Gemini 3.8 Live Extended Thinking |
|---|---|
Artificial Analysis 音声品質指数 | 82.6(総合1位) |
τ-Voice エージェント的タスク完遂 | 68.6% |
Sierra τ-Voice-Banking | 35.1% |
Big Bench Audio 推論 | 97.7% |
τ-Voice は音声で与えられた指示を最後までやり切れるかを測る指標で、単発の応答精度とは別の能力を見ます。Big Bench Audio の97.7%は音声入力からの推論がほぼ飽和に近い水準にあることを示しますが、τ-Voice-Banking の35.1%を見ると、金融のように手順と正確性が厳しく求められる領域はまだ余地があります。
軽量側の Gemini 3.8 Live も、人間による比較評価である Speech Agent Arena で2位に入りました。ServiceNow の EVA-Bench では、両モデルが複雑なワークフローにおける性能とコストのパレートフロンティアを押し広げたとしています。
会話中に言語を切り替える
実務でつまずきやすいのが言語の混在です。従来の音声システムは使用言語を事前に指定する前提が多く、会話の途中で別の言語に変わると認識が破綻しがちでした。
新モデルは対応する97言語を自動で判別し、会話の途中でも切り替えます。多国籍のコールセンターや観光案内のように、話者が日本語と英語を混ぜて話す場面で設定変更を挟まずに対応できる点が変わります。
視覚入力についても、near-realtime で処理して文脈に応じた応答を返すとしています。カメラに映した機器を見ながら操作を尋ねるといった使い方が想定されます。スマートフォンやPC上での常時利用という文脈では、GoogleがWindows版Geminiアプリを公開、Alt+Spaceで画面に重ねて呼び出しのような画面共有型の入口との組み合わせも見えてきます。
思考しながら話す設計
Extended Thinking で目を引くのは、推論と発話を同時に進める設計です。従来は深く考えさせるほど応答までの無音が長くなり、利用者が「切れたのか」と不安になる問題がありました。
新モデルは「確認しますね」といった言葉を自ら挟み、進捗を口頭で伝えながら裏で処理を続けます。ツール呼び出しや API 実行も会話を止めずに背景で走らせるため、待ち時間が対話の空白にならない構造です。
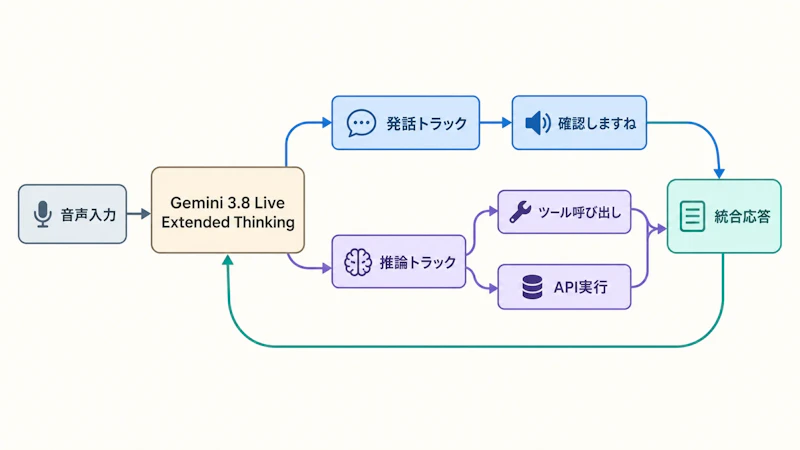
図1のように、発話トラックと推論トラックが並行して動き、最終的に1つの応答へ合流します。並列推論とバックグラウンドでのタスク管理が、前世代からの主な変更点として挙げられています。
提供先と安全対策
開発者向けの API 公開と同時に、一般利用者向けの導線も広がっています。提供範囲は次のとおりです。
- 開発者: Gemini API、Google AI Studio
- 企業: Gemini Enterprise でプライベートプレビュー、顧客対応向けと Google Workspace へ順次展開
- 一般利用者: Search Live、Gemini Live(AI Pro/Ultra 向け)、Gmail と Keep は全加入者
- パートナー: Salesforce、ServiceNow、LiveKit、LangChain など
生成された音声にはすべて、知覚できない電子透かし SynthID が埋め込まれます。AI 生成音声かどうかを後から判定できる仕組みで、音声クローンへの懸念が強まる状況では前提条件に近い措置と言えます。
開発者にとっての意味
音声AIはこれまで、応答の速さと推論の深さのどちらかを諦める選択を迫られてきました。今回の2モデル構成は、コスト重視の Gemini 3.8 Live と複雑な業務向けの Extended Thinking を用途で分け、その選択を設計段階の判断に置き換えるものです。
もっとも、公開されている数値は Google 自身による整理であり、τ-Voice-Banking の35.1%が示すように業務適用の難所は残っています。API が即日使える環境が整ったことで、実際の負荷や遅延がどこまで許容範囲に収まるかは各開発者の検証にゆだねられます。


