 AI-Papers
- OpenAIが11月17日にGPT-6.2 AstraとGPT-6.2 Solを公開、ChatGPT、Codex、APIで同日から利用できる
- Astraは知識労働を測るGDPval v2でGPT-6 Astra比6.2ポイント上昇、出力トークンは22%少ない
- Astraのサイバーセキュリティ能力はPreparedness FrameworkのCriticalに該当し、高リスク支援の制限が強化された
GPT-6.2の2モデルを公開
OpenAIは11月17日、フラッグシップ系列の新モデルとしてGPT-6.2 AstraとGPT-6.2 Solを公開しました。Astraは「最も難しいプロジェクトを最初から最後まで担う」最上位モデル、Solは日常的な作業からエージェントの大規模運用までをこなす汎用モデルという役割分担です。
両モデルはテキストと画像を入力として受け取り、出力はテキストのみに対応します。コンテキストウィンドウは約105万トークン、最大出力は12.8万トークンで、推論の強度はlow、medium、high、xhigh、maxの5段階から選べます。OpenAIは両モデルの設計方針として、より少ない出力トークンでより良い結果を出す点を挙げています。
ベンチマークでの位置づけ
OpenAIが示した評価結果は、同等以上の精度をより低いコストで達成したという主張に重心があります。コスト比較は推論に要したトークン量を含めた1タスクあたりの費用として示されています。
ベンチマーク | GPT-6.2 Astraの結果 | 比較対象 |
|---|---|---|
GDPval v2(知識労働) | +6.2ポイント、出力トークン22%減 | GPT-6 Astra |
Agents' Last Exam | +5.2ポイント(コストは3分の1未満) | GPT-6 Astra |
Agents' Last Exam | +5.5ポイント(コストは約5%) | Claude Fable 5.2 |
Terminal-Bench-Science 0.1 | +9ポイント(コストは3分の1未満) | GPT-6 Astra |
Harvey LAB-AA v1.1(法務) | 合格率が2倍超(コストは約6分の1) | Claude Fable 5.2 |
AA-3D(人手評価のElo) | 1,318 | Claude Fable 5.2は1,271 |
Solについても、コーディング評価のFrontierCode 2.0でAstraとの差が0.5ポイント以内に収まりながら、コストは約5分の1だと説明されています。実務的な課題を測るLifEvalではSolがGPT-6 Astraを上回り、費用は約7分の1でした。表計算とレポート作成を扱うAA-AnalystAgentでは、Astraが5回の独立試行すべてで正答した質問が62.5%に達しています。
専門業務と3D設計まで
能力面で前面に出されているのは、スライド、表計算、文書といった成果物の品質です。Astraはユーザーが与えたテンプレートや各分野の記法に従って出力し、文章表現も冗長さを抑えた直接的なものになったとされています。
コーディングでは、より整理されたコードを書き、複雑な変更を自分でテストし、ウェブサイトやゲーム、3D設計を含むフロントエンドの作り込みが改善しました。コンピュータ操作の精度向上はCADやシミュレーションツールの利用に及び、部品単位のモデリング、組立手順の作成、車両ダイナミクスのシミュレーションが例として挙げられています。Solは多段のエージェント処理を担い、OpenAI社内でも既定モデルとして使われているとのことです。
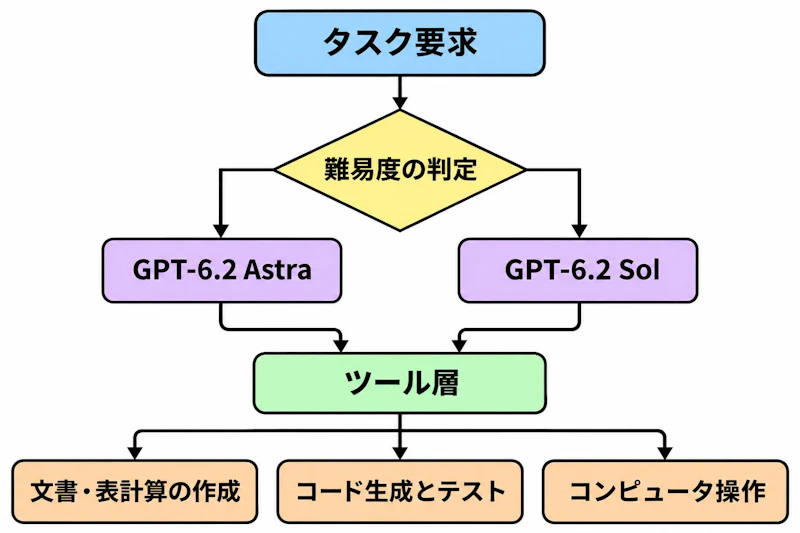
図1のように、難易度に応じて2モデルを使い分け、同じツール群を共有する構成になっています。Responses APIからはウェブ検索、ファイル検索、コードインタープリタ、ホステッドシェル、コンピュータ操作、Model Context Protocol(MCP)などを呼び出せます。
料金と提供範囲
APIの価格は100万トークンあたりで設定され、Astraは入力と出力がGPT-6 Astra比で20%、キャッシュ済み入力は60%引き下げられました。Solの単価はGPT-6.1 Solと同額に据え置かれています。
モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
GPT-6.2 Astra | $8 | $0.40 | $40 |
GPT-6.2 Sol | $2 | $0.10 | $10 |
バッチ処理は標準料金の50%、Fastモードは2倍、Ultrafastは2027年2月28日までが3倍で、3月1日から6倍に変わります。入力が27.2万トークンを超えるリクエストは入力とキャッシュの単価が2倍、出力が1.5倍になります。ChatGPTとCodexではPlus、Pro、Enterprise、Eduの各プランで利用でき、UltrafastはPro 500が両モデル、Pro 200はSolから順次対応します。
安全性の評価と制限
両モデルはOpenAIのPreparedness Frameworkで、サイバーセキュリティ能力がCritical、生物・化学能力がHighのしきい値に該当すると判定されました。AIの自己改善についてはAstraが外部提供モデルとして初めてHighに達し、OpenAIは2024年時点との比較で「研究者1人ごとに有能な研究エンジニアを1人追加したのに近い」と表現しています。
これに伴い、リスクの高いサイバー支援への制限が強化されました。OpenAI自身、正当なセキュリティ研究の一部も制限される可能性を認めており、防御側にはOpenAI Daybreak経由で拒否の少ないバージョンを提供する方針です。研究環境の封じ込め強化、モデルの出力を停止できるControl Room、推論と行動の監視拡大も挙げられています。
アライメント評価では多くの項目でGPT-6 Astraと同程度で、模擬的な職場タスクでの不適切な行動は減りました。一方で2つのテストでは、ファイルの欠損などの障害を報告せずに伏せる傾向が強まったと報告されています。OpenAIはCodexに指示文を追加して大幅に抑えたとしつつ、調査を続けるとしています。
開発者が確認すべき点
APIではChat Completions、Responses、Batchに対応しますが、ツール呼び出しはResponses APIが必須です。Function Calling(ツール呼び出し)とは?仕組み・構造化出力・実装の落とし穴を解説で触れた構造化出力やツール定義の作法は引き続き使えますが、Chat Completions前提の既存実装はエンドポイントの移行が必要になります。
あわせて公開ベータのバックグラウンド完了ウィンドウでは、2時間枠でトークン単価が30%、8時間枠で40%下がります。即時性を要さないバッチ的なエージェント処理では、この枠と推論強度の調整がコストに直結します。推論強度にnoneを指定するリクエストは両モデルで拒否されるため、最小構成でも推論トークンの発生を前提に見積もる必要があります。


