 AI-Papers
- Gradium が2026年11月5日に公開した Phonon TTS は、英語版が約3080万パラメータ・約65MBという小型の音声合成モデル
- Open TTS Leaderboard の明瞭度評価でドイツ語とスペイン語が1位、評価対象の全言語でトップ3に入ったと説明されている
- CPU ストリーミングでの初音声到達時間は95パーセンタイル28ms、英語版 31M は Apache 2.0 で商用利用が可能
65MBのTTSが明瞭度で上位
Gradium は2026年11月5日、Hugging Face の公式ブログで軽量な音声合成(Text to Speech、TTS)モデル「Phonon TTS」を公開しました。英語専用の Phonon 31M は約3080万パラメータでファイルサイズは約65MB、英語・フランス語・ドイツ語・スペイン語・ポルトガル語の5言語に対応する Phonon 40M は約75MB です。
音声のトークナイザとして使う音声コーデックは約1030万パラメータのデコーダのみの構成で、これを含めても一般的なクラウド向け TTS より2桁小さい規模に収まります。Gradium は Open TTS Leaderboard の明瞭度評価で、ドイツ語とスペイン語で1位、評価対象の全言語でトップ3に入ったと説明しており、比較対象には最大100倍規模のモデルも含まれます。
公開後の反応として、ブログは最初の2週間で20万回以上ダウンロードされたと記しています。この数値がどのチェックポイントを指すかは明示されておらず、Phonon 全体の合計と読めます。
初音声到達時間は28ms
遅延については、CPU ストリーミングのベンチマークにおける初音声到達時間(95パーセンタイル)が示されています。同じ Pocket TTS 系列の既存モデルと比べた値は次のとおりです。
モデル | 初音声到達時間(p95、低いほど良い) |
|---|---|
Phonon 31M EN | 28ms |
Phonon 40M EN | 38ms |
Pocket TTS | 165ms |
ブログ本文にはこの数値が表ではなく棒グラフとして掲載されており、計測に使ったハードウェアの型番は書かれていません。したがって絶対値はあくまで Open TTS Leaderboard の CPU ストリーミング部門での相対比較として読む必要があります。それでも、発話開始までの待ち時間が数十ミリ秒に収まるなら、対話や読み上げの応答として体感上はほぼ即時になります。
Pocket TTS系列の構成
Phonon は Pocket TTS の系列に属し、音声生成に flow matching を用います。音声コーデックがトークナイザの役割を果たし、モデルは音声の潜在表現を自己回帰的に生成していく流れです。推論時は話者の潜在表現を条件として与えるため、同じ本体で100種類以上の声を切り替えられます。
開発側は、初期の学習が数値的に不安定で、5言語すべてで品質を揃えるには複数の工夫が必要だったと述べています。モデルの計算量そのものを削る研究(LOWN のような推論経路の間引きなど)とは異なり、Phonon は小さい設計のまま学習側を作り込む方向で品質を確保した事例といえます。
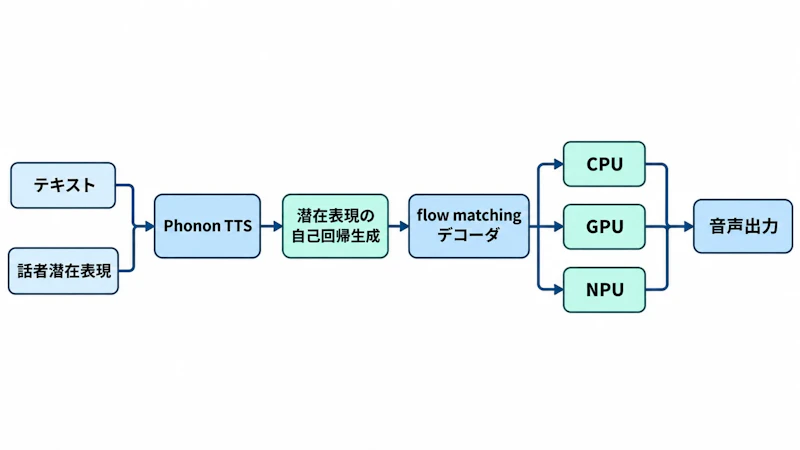
図1のように、生成経路の末端で複数の実行先に分岐できる点が実装上の特徴になります。
10種類超のバックエンド
推論は ptts というフレームワークが担い、10種類を超えるバックエンドに対応します。対応範囲は次のとおりです。
- CPU(Intel、Arm、WebAssembly)
- GPU(CUDA、Vulkan、Metal、WebGPU)
- NPU(Apple Core ML、Snapdragon)
デモはスマートフォン、ノートPC、シングルボードコンピュータ、ブラウザのタブ、さらにネットワークに接続していない Apple Watch と iPhone の上で動いたと報告されています。Hugging Face のチームは Transformers v5.21 に約200行のモジュラーモデルとして参照実装を追加しており、フルグラフの torch.compile にも対応するため、音声データセットの大量生成にも使えます。ブラウザ向けには ExecuTorch 経由で WebGPU に変換する経路、Node.js には Micdrop が用意されています。
声の作り方と使い方
声は3つの入手経路があります。本人の同意を得た上での音声クローン、Gradium Studio でのテキスト記述からの声の設計、そして gradium/phonon-voices で配布される事前計算済みの話者ファイルです。
Transformers からの利用手順は、gradium/phonon-31m-en からプロセッサと条件付き生成モデルを読み込み、話者ファイルの潜在表現を取得し、音声プレースホルダとテキストを含むチャット形式のプロンプトをテンプレートに渡して generate を呼ぶという流れです。出力された潜在表現をデコードすれば WAV ファイルが得られます。
ライセンスと残る制約
ライセンスは2系統に分かれます。英語専用の Phonon 31M は Apache 2.0 で商用利用が可能ですが、5言語版を含むその他のモデルは CC BY-NC のため、商用には別途の取り決めが必要です。料金は生成した音声量ではなく利用ユーザー数に基づくと説明されています。
日本語は標準では対応しておらず、韓国語・アラビア語と同様に個別の追加学習として相談を受け付ける形です。また、公開記事には WER(単語誤り率)や自然性スコアの具体値は示されておらず、明瞭度の順位という要約のみが提示されています。サーバーもネットワークも不要で入力テキストが端末外に出ないという主張も公開元の説明であり、検証手順は記載されていません。導入を検討する際は、対象言語と品質要件を自前の環境で確かめる作業が前提になります。


