 AI-Papers
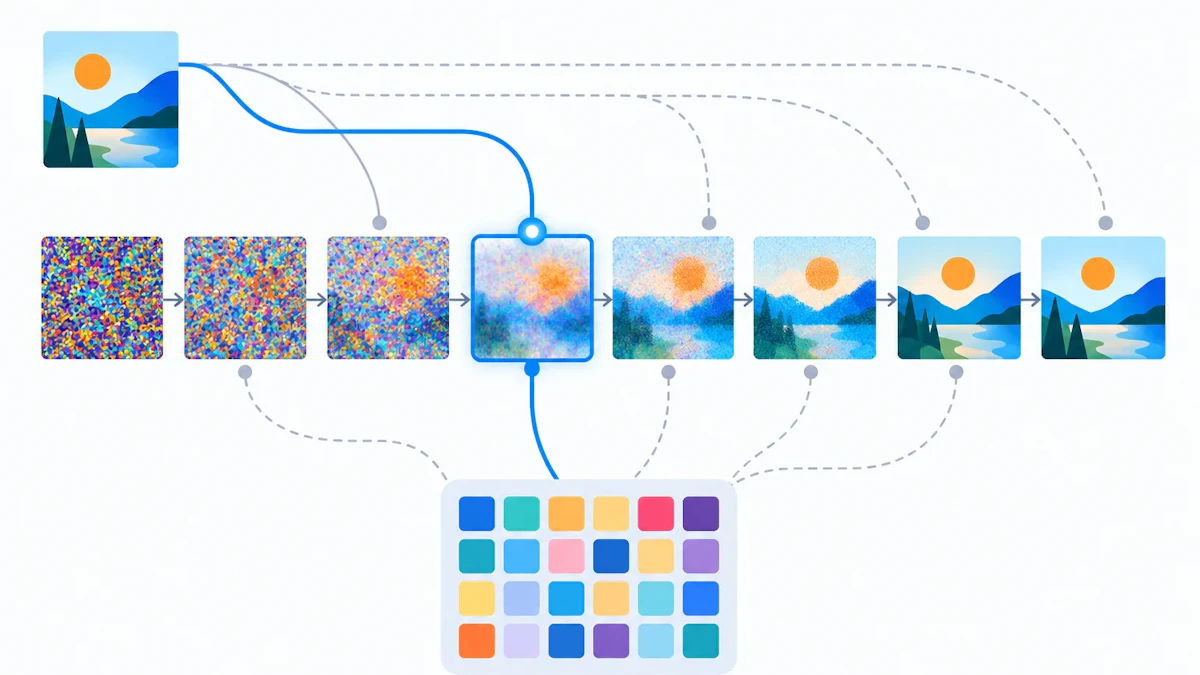
- 拡散VLMでは入力の89〜97%が視覚トークンで、毎デノイズステップで同じ画像を再処理していた
- 画像の有無で予測が変わるステップは平均22.8%だけという分析から、必要な時だけ画像を見る仕組みを設計
- 学習もしきい値調整も不要で、LLaDA-Vの性能99.6%を平均35.3%のデコードFLOPsで維持
研究の背景
画像とテキストをまとめて扱うVision-Language Model(VLM、視覚言語モデル)は、トークンを前から1つずつ出す自己回帰方式が主流でした。これに対して近年研究が進んでいるのが、Diffusion Vision-Language Model(拡散VLM)です。マスクされた出力列を複数回のデノイズステップで段階的に埋めていく方式で、複数トークンを同時に確定できる点が高速化の期待につながっています。
ところが実際のデコードは軽くありません。原因は入力の構成比にあります。論文が評価に使った10個のベンチマークでは、視覚トークンが入力全体の89〜97%を占めていました。拡散VLMは各ステップで入力全体を前向き計算し直すため、デコードの計算量の大半が同じ画像を何度も符号化し直す作業に消えてしまいます。
既存の高速化策としては、重要度の低い視覚トークンを捨てる視覚トークン枝刈り(visual token pruning)が知られています。ただし削った情報は後から取り戻せず、残したトークンは依然として毎ステップ処理されます。削減量を増やすほど画像の細部が失われるという構造的な限界を抱えていました。
画像が効くのは22.8%
著者らはLLaDA-Vを使い、各デノイズステップで「画像を入れた予測」と「画像を外した予測」を突き合わせる分析を行いました。その結果、画像を外すとアンマスクされるトークンが変わるステップは平均22.8%にとどまりました。ベンチマーク別に見ると最小はMMBenchの7.9%、最大はDocVQAの43.8%で、タスクによる差も大きいことがわかります。
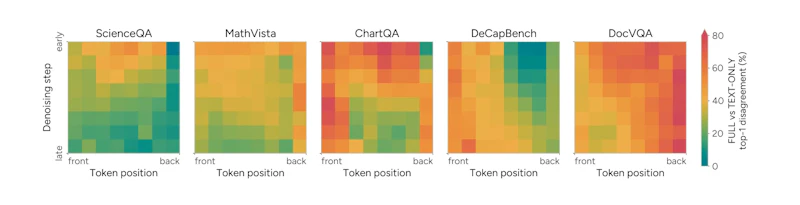
図1を見ると、食い違いは出力の前方と初期ステップに偏っています。画像は答えの骨格を決める場面で必要になり、それ以降は文としての体裁を整える作業が多い、という解釈ができます。必要量がベンチマークごとに違う点も重要で、何ステップごとに画像を見るといった固定スケジュールでは過剰になったり不足したりします。
提案手法LOWN
LOWN(Look Only When Needed)は、2種類の前向き計算を使い分けます。1つは視覚トークンを含む通常の計算(FULL forward)、もう1つは視覚トークンを外し、プロンプトと応答の位置IDはそのまま保った計算(TEXT-ONLY forward)です。
仕組みの鍵は証明書(certificate)という考え方です。直近のFULL forwardが出したマスク位置の予測と確信度をアンカーとして保持しておき、各ステップではまずTEXT-ONLY forwardを走らせます。画像なしの予測がアンカーと一致した位置は、画像を見なくても答えが変わらないことが裏付けられたとみなし、証明済みとして扱います。確信度の高い順に並べたときに先頭から連続して証明済みになっている部分が、証明済みプレフィックスです。
判定規則は単純です。ベースラインが1ステップで確定するトークン数をkとすると、証明済みプレフィックスがk個以上あればそれをそのままアンマスクし、FULL forwardを丸ごと省略します。足りなければFULL forwardを実行してアンカーを更新し、2つの予測が食い違った位置を優先してkトークンをアンマスクします。学習もしきい値調整も必要なく、モデルパラメータやAttentionの構造には手を入れません。
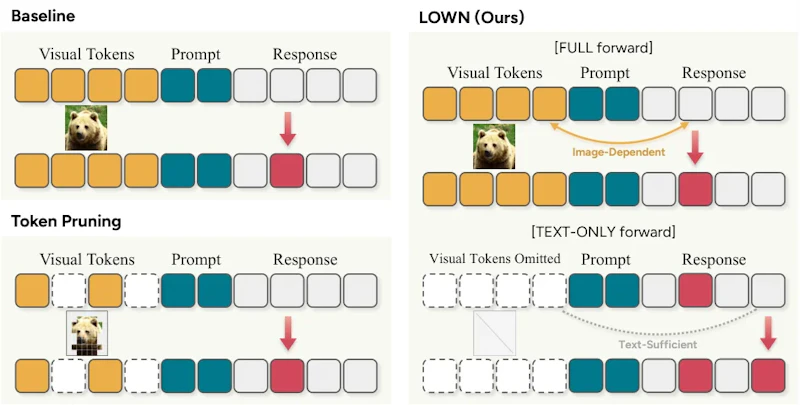
図2が示すように、LOWNは視覚トークンを削る枝刈りとは作用する軸が異なります。枝刈りは1回の計算に渡す画像の量を減らし、LOWNは画像を渡す回数そのものを減らすため、両者は同時に使えます。
実験結果
MathVista、ScienceQA、ChartQA、MME、MMBench、DocVQA、CapArena、LLaVA-Bench、GQA、DeCapBenchの10ベンチマークで、LLaDA-Vを対象に評価しています。スコアはLLaDA-Vを100%としたタスク正規化平均、FLOPsは同モデルに対する比です。既存手法はLOWNと同程度の計算予算に揃えて比較されています。
手法 | 正規化平均スコア | デコードFLOPs比 |
|---|---|---|
LLaDA-V(元のモデル) | 100% | 1.00 |
RedVTP(視覚トークン枝刈り) | 94.2% | 約0.392 |
ZOO-Prune | 91.9% | 約0.405 |
LOWN | 99.6% | 0.353 |
LOWN + RedVTP(50%枝刈り) | 98.3% | 0.223 |
LOWN単体で計算量を約2.8分の1に抑えつつ、10ベンチマークのうち8つで高速化手法の中の最高スコアを記録しました。枝刈りのRedVTPと併用した設定では、FLOPsが0.223まで下がりながら10ベンチマークすべてで併用なしの手法を上回っています。
Key-Valueキャッシュ(計算済みの中間表現を再利用する仕組み)との組み合わせも検証されました。キャッシュを使うFast-dLLMにLOWNを加えると、生成時間が38.1〜50.1%、FLOPsが44.1〜58.9%追加で減りました。キャッシュ再利用の設計自体を扱った研究としてはCache Engineeringもありますが、LOWNは画像を見るかどうかという別の次元で削減を重ねられる点が特徴です。
比較実験では、同じ回数だけFULL forwardを実行するランダムスケジュールに対してLOWNが4.9〜13.0%高い正規化品質を示し、周期的なスケジュールは同程度のコストでさらに劣りました。画像を見る回数を適応的に決める部分だけで27〜68%、アンマスク数を証明済み個数に応じて増やす部分でさらに21〜43%のFLOPsが削られています。証明済みトークンが実際のFULL予測と食い違う割合は2.2〜4.7%で、1ステップ前のアンカーをそのまま使う場合の4.1〜11.0%より低く抑えられていました。LaViDaや動画向けのVidLaDA-8Bでも効果が確認されています。
課題と今後の展望
限界も明示されています。再利用するアンカーの予測は新しいFULL forwardの結果と一致しない場合があり、アンカーが古くなるほど誤りが増えます。チャートや文書の読み取りのように画像への依存が最後まで続くタスクでは、FULL forwardの回数が増えるため節約幅が小さくなります。
加えて、総コストは応答が何回FULL forwardを必要とするかで決まるため、デコード前に確定できません。計算予算を事前に固定したい用途では、枝刈りとの併用で部分的に制御する運用が現実的でしょう。学習不要で既存の拡散VLMにそのまま被せられる点を踏まえると、視覚入力の再処理を見直す方向は他のマルチモーダル生成にも広がる余地があります。
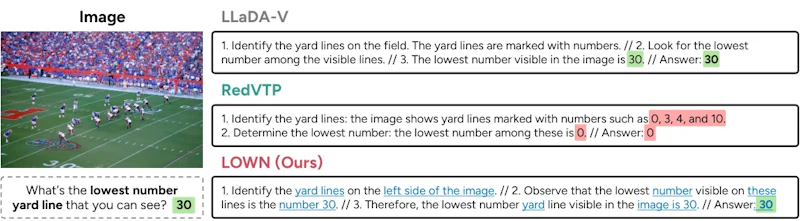
図3の比較例では、LOWNが画像に依存する語だけをFULL forwardで確定し、残りを画像なしの計算で埋めている様子が確認できます。どのトークンが画像を必要としたかが可視化されるため、効率化の内訳を事後に検証しやすいという副次的な利点もあります。
論文情報: "Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs"(Donghyeon Cho et al., 2026) arXiv:2610.36671
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


