 AI-Papers
- 脳活動予測の定石だった「凍結バックボーン+線形読み出し」に対し、LoRAによる低ランク適応を持ち込んで最大104Bのマルチモーダルモデルを適応させた研究
- バックボーンの因果構造を活かして1パスで複数時点の特徴を得ることで、特徴抽出コストを約350分の1に削減
- Qwen3-Omniを使った単体モデルで既存最高手法を上回り、261モデルのアンサンブルがAlgonauts 2025の公開リーダーボードで1位を記録
研究の背景
脳エンコーディングは、映像や音声などの刺激を入力として、人の脳活動(fMRIで測った各領域の信号)を予測するモデルづくりを指します。これまでの標準的な手法は、事前学習済みの大規模モデルを凍結したまま特徴量を取り出し、その特徴から脳活動へのマッピングをリッジ回帰のような線形モデルで学習するものでした。
この設計が選ばれてきた理由は単純で、脳活動データが高価かつ少量だからです。被験者1人からfMRIを長時間取るのは負担が大きく、数十時間分のデータで数十億パラメータのモデルを全体学習すれば、まず過学習します。結果として、バックボーンは「汎用的な特徴抽出器」として固定され、脳データから学べるのは読み出し層だけという前提が続いてきました。
Columbia大学などの研究チームが発表した論文「Scaling Parameter-Efficient Fine-Tuning for Brain Encoding」は、この前提に疑問を投げます。Large Language Model(LLM)の分野で定着したParameter-Efficient Fine-Tuning(PEFT、少数の追加パラメータだけを学習する微調整手法)を使えば、少ないデータでも巨大なバックボーン自体を脳活動に合わせて動かせるのではないか、という発想です。
提案手法
提案手法BrainLoRAの構成は、マルチモーダルバックボーンにLoRA(Low-Rank Adaptation、重みの更新を低ランク行列に制限する手法)を差し込み、その出力に軽量な読み出し層を載せるというものです。学習されるのはLoRAアダプタと読み出し層だけで、Qwen3-Omniの場合に約6120万パラメータにとどまります。既存最高手法のMIRAGEが11億パラメータを学習していたのに対し、およそ5%の規模です。学習パラメータを絞り込んで性能を保つという方向性は、凍結語彙テーブルによる小型LLMの軽量化と同じ系譜にあります。
もう1つの柱は特徴抽出の効率化です。従来はfMRIの1時点ごとに、その直前の刺激ウィンドウを切り出してバックボーンに通していました。ウィンドウは大きく重なるため、同じ入力を何度も符号化する無駄が生じます。BrainLoRAはバックボーンが因果的(各トークンが過去のトークンしか参照しない)である性質を使い、ウィンドウ全体を1回通すだけで全時点の特徴を同時に取り出します。
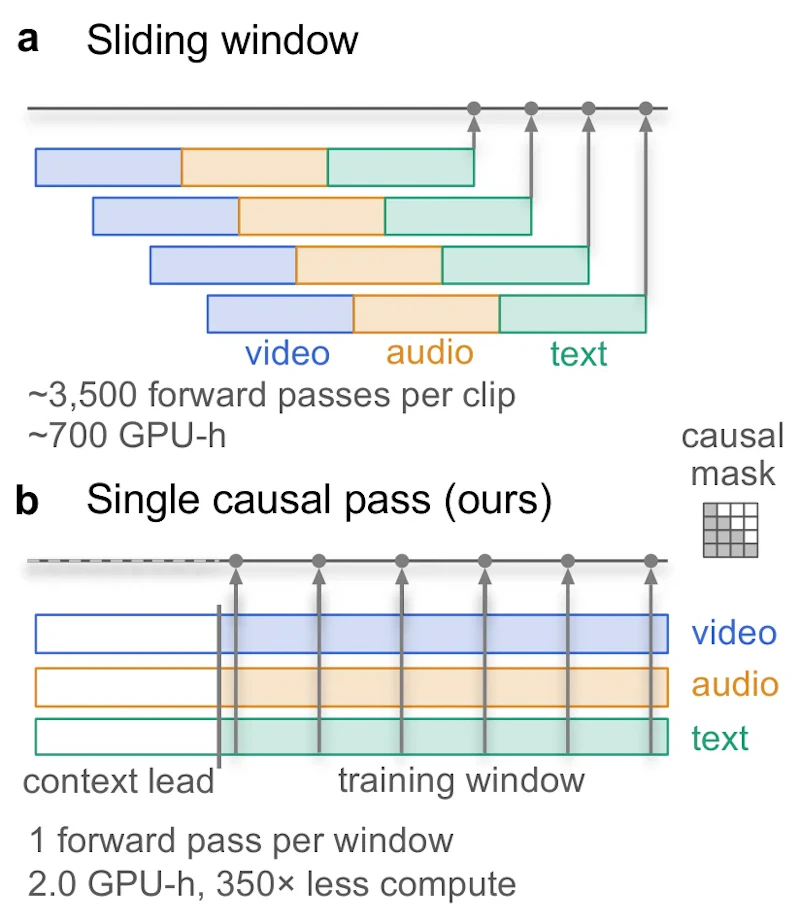
図2が示すこの置き換えによって、特徴抽出コストは約700 GPU時間から約2 GPU時間へ、およそ350分の1に下がりました。学習まで含めた全体でも約702.5 GPU時間から約8.5 GPU時間へと83分の1です。この削減があるからこそ、104Bという規模のバックボーンを現実的な計算資源で適応できるようになっています。
さらに、1つの共有バックボーン上で複数のLoRAを同時に学習するための融合カーネルも実装されました。32個のアダプタを同時に回しても、1ステップの計算コストは単一アダプタの約1.08倍にとどまり、逐次学習に比べて29.8倍の高速化になります。
実験結果
評価にはAlgonauts 2025 Challenge(映画視聴中のfMRIを予測するコンペ)が使われました。4.7Bから104Bまでの9種類のマルチモーダルバックボーンすべてで、LoRAの導入によって平均Pearson相関が0.032から0.066改善しています。主要な比較結果は次のとおりです。
モデル | 学習パラメータ | ID(分布内) | OOD(分布外) |
|---|---|---|---|
TRIBE(従来手法) | - | 0.303 | 0.196 |
MIRAGE(従来最高、単体) | 1.1B | 0.310 | 0.217 |
凍結バックボーン+線形 | 52.3M | 0.287 | 0.187 |
全体ファインチューニング | 20.3B | 0.326 | 0.225 |
BrainLoRA(線形読み出し) | 61.2M | 0.322 | 0.222 |
BrainLoRA(cross-attn) | 61.4M | 0.327 | 0.228 |
BrainLoRA(261モデル集約) | 261×61M | 0.343 | 0.248 |
注目したいのは、61M パラメータのBrainLoRAが20.3Bを学習する全体ファインチューニングとほぼ同等、cross-attention読み出しではわずかに上回っている点です。同じQwen3-Omniを使うMIRAGEに対しても単体で優位に立ち、261モデルのアンサンブルはチャレンジ終了後の公開リーダーボードで1位に到達しました。
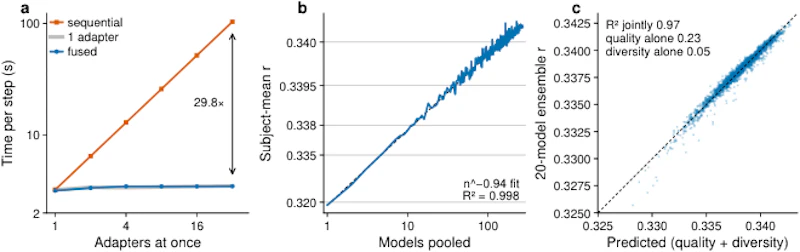
図5の右側は、アンサンブルの性能が「構成モデルの平均精度」だけでも「モデル間の残差相関(多様性)」だけでも説明できず、両者を組み合わせると決定係数0.97で予測できることを示しています。多数のモデルを安く量産できる環境が整ったことで、どう組み合わせるべきかという問いに定量的に答えられるようになった形です。
解釈性の検証も行われています。各モダリティ(映像・音声・テキスト)が予測精度にどれだけ寄与するかをShapley値で分解すると、視覚野・聴覚野・言語領域という感覚トポグラフィが自然に浮かび上がりました。従来研究ではこうした区分けを設計で組み込むことが多かった部分です。
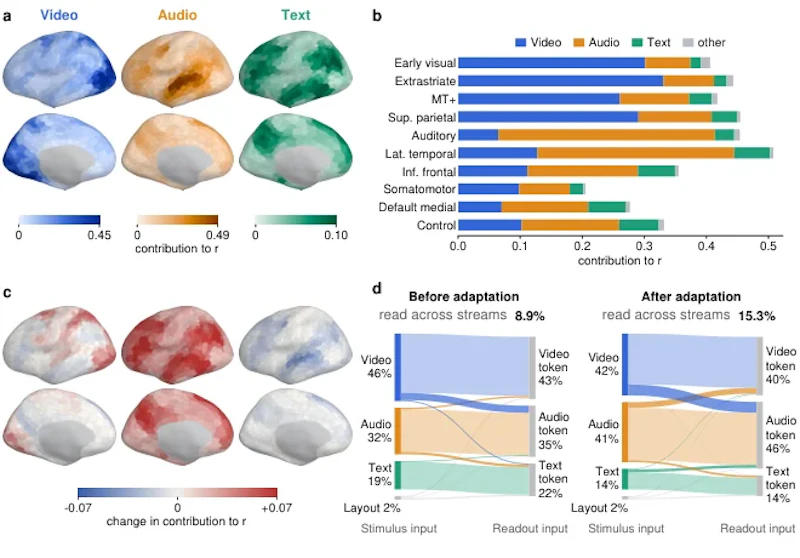
図4が示すように、適応によって音声の寄与が最も大きく増え、テキストの寄与は下がります。さらにバックボーン内部でのモダリティ間の混合がおよそ2倍になっており、脳データに合わせた微調整が単なる当てはめではなく、表現そのものを組み替えていることが読み取れます。
汎化性能については、学習に使っていないNNDbデータセットでゼロショット評価を行い、ノイズ上限(データのばらつきから決まる予測精度の理論的な天井)に対して11.1ポイントの改善を得ました。検証セットでの10.7ポイントとほぼ同等で、未知の被験者でも学習時の改善の97%を保っています。
まとめと今後の展望
BrainLoRAが示したのは、脳エンコーディングにおいて「バックボーンは凍結するもの」という常識が、データ不足そのものではなく手法の制約に由来していた可能性です。PEFTと効率的な特徴抽出を組み合わせれば、限られたfMRIデータでも100B級のモデルを動かせます。コードはGitHubで公開されており、再現性の面でも扱いやすい研究といえます。
一方で限界もはっきり書かれています。学習に使ったのは被験者4人の単一ベンチマークであり、刺激はすべて音声付きの物語映像です。未知の被験者やNNDbへの転移テストも同じ映画視聴という枠内にとどまるため、静止画や言語タスクなど異なる種類の刺激に対してどこまで通用するかは未検証です。また、個人差をアダプタでどう扱うか、アンサンブルに頼らず単体モデルの精度をどう伸ばすかも残された課題です。それでも、計算コストを2桁下げた上でスケールの恩恵を引き出した点は、神経科学とPEFTの双方に実用的な示唆を与えています。
論文情報: "Scaling Parameter-Efficient Fine-Tuning for Brain Encoding"(Zhuofan Josh Ying et al., 2026) arXiv:2610.26802, CC BY 4.0
本記事の図(図2、図4、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


