 AI-Papers
- 画面・音声・動画・操作履歴・端末状態を毎ステップすべて渡すと誤りが累積する「Sequential Distraction」という課題を定義した研究です
- 提案手法FocusGUIは、バックボーンを凍結したまま100万パラメータ台の軽量アダプタだけを学習し、各ステップで有用な入力チャネルを選別します
- 4種のオムニモーダルモデルで平均Type Matchが31.0から64.2へ、Exact Matchは11.2から33.5へ改善しました
研究の背景
スマートフォンやPCを自動操作するGUIエージェントは、扱う入力の種類が急速に増えています。画面のスクリーンショットだけでなく、再生中の音声、動画、これまでの操作履歴、端末の状態といった情報を同時に受け取るオムニモーダル(複数種類の入力を統合して扱う)な構成が一般的になってきました。
ところが、これらをすべて毎ステップ無条件にモデルへ渡すと問題が起きます。本論文「Focused Omni-Modal GUI Agents」(arXiv:2610.26203)は、この現象を Sequential Distraction(逐次的注意散漫) と名付けました。
鍵になるのは、どの入力が役に立つかが時々刻々と変わるという点です。あるステップで判断に不可欠だった音声は、次のステップでは単なるノイズになります。GUI操作では自分が実行した行動がそのまま次のステップの文脈に入り込むため、一度の読み違いが後続の全ステップに引き継がれ、軌跡全体が目的から逸れていきます。
著者らは解決の方向性を Focused Perception として整理し、焦点の表現が満たすべき3条件を挙げました。ステップごとに切り替わること(step-adaptive)、行動を決めるのに十分な情報を含むこと(action-sufficient)、そして元のモデルの経路を壊さないこと(non-intrusive)です。
提案手法FocusGUI
FocusGUIは、既存のオムニモーダルモデルに後付けするアダプタです。バックボーン、デコーダ、言語モデルのヘッドはすべて凍結したまま、追加モジュールだけを学習します。
図2のように、元のモデルの処理経路は手を加えずそのまま残されます。FocusGUIは同じ観測から知覚チャネルを取り出します。統合された隠れ状態、画面の空間情報、そして画面・音声・動画・操作履歴・端末状態といった個別モダリティで、合計7チャネルです。
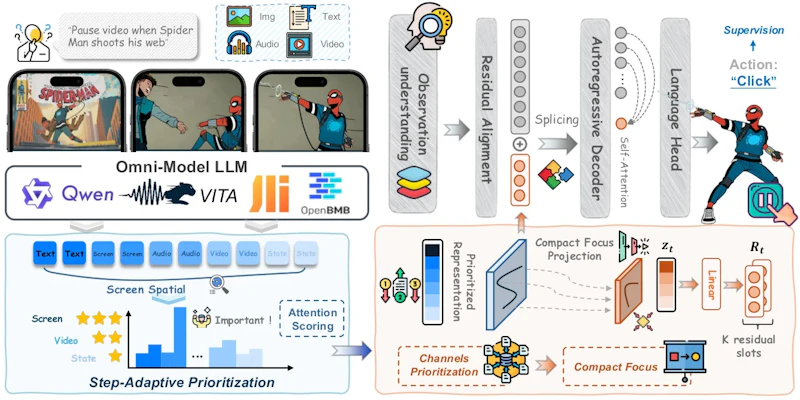
各ステップでは、観測全体の統合表現から「判断の基準」となるベクトルを計算し直し、それと各チャネルを照合して優先度を付けます。選ばれた情報は64次元というかなり小さな潜在表現に圧縮され、行動の生成が始まる直前の4トークン位置に、ゼロ初期化された残差として足し込まれます。
ゼロ初期化は、学習前の時点では元のモデルの挙動を一切変えないという意味を持ちます。そこから行動教師信号だけを使って学習が進みます。「このステップでは音声が重要」といったモダリティ関連性のラベルは一切使いません。学習対象はバックボーンごとに115万から145万パラメータで、AdamWで3エポック回すだけという軽い構成です。
実験結果
評価には、29種のアプリにまたがるスマートフォンのオムニモーダルGUI操作を集めたベンチマーク OmniGUI が使われました。全708エピソード・2572ステップを学習1807・検証257・テスト508ステップに分割しています。指標は行動の種類が合っているかを見るType Match(TM)、座標やテキストまで一致したかを見るExact Match(EM)、タスクの進捗を見るGoal Progress(GP)です。
4種のバックボーンでの全体スコアは次のとおりです。
バックボーン | TM(凍結→FocusGUI) | EM(凍結→FocusGUI) | GP(凍結→FocusGUI) |
|---|---|---|---|
Qwen2.5-Omni | 49.61 → 71.65 | 12.60 → 40.16 | 5.50 → 17.49 |
VITA-1.5 | 13.98 → 58.66 | 9.65 → 26.38 | 6.09 → 6.84 |
MiniCPM-o 4.5 | 36.02 → 67.72 | 13.58 → 41.54 | 7.55 → 16.76 |
Baichuan-Omni-1.5 | 24.41 → 58.86 | 8.86 → 25.98 | 4.32 → 8.73 |
平均するとTMは31.0から64.2へ、EMは11.2から33.5へと約3倍になりました。既存の強化手法との比較でも差は明確です。Qwen2.5-Omni上でDRS-GUI、OmniParser、RegionFocusはいずれもTMが48から49台にとどまり、視覚トークン上に行動ヘッドを学習するGUI-Actorでも50.20でした。画面側の入力を精緻化するだけでは、どのモダリティを見るべきかという問題は解けないことを示す結果です。GUI操作エージェントの評価設計についてはOpenGCUAの記事も参考になります。
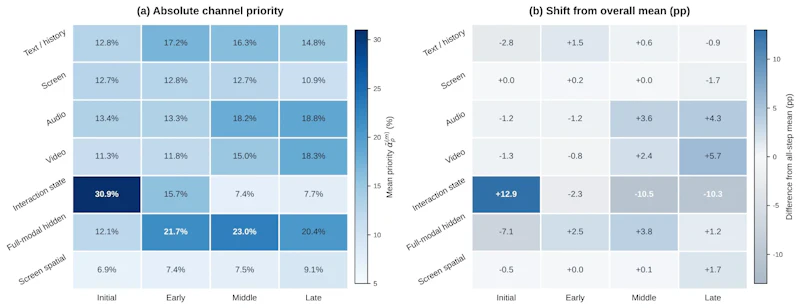
学習されたチャネル優先度の中身も分析されています。図4は、フェーズごとに各チャネルへ割り振られた優先度の平均を示したもので、均等配分であれば14.3%になるはずの値が、局所化・意味理解・クロスモーダル・時間推論といった局面で明確に偏っていました。モダリティのラベルを与えていないにもかかわらず、行動の教師信号だけから局面に応じた使い分けが現れたことになります。
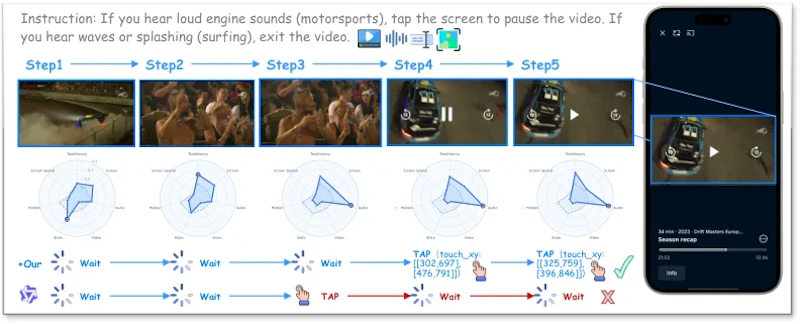
定性的な例として、図5では判断材料が画面にまったく現れないケースが取り上げられています。指示が「聞こえた音に応じて操作する」内容のため、画面はどのステップでも同じまま、決め手は音声側にあります。FocusGUIはエンジン音が届くまで待ってからタップしますが、凍結したバックボーンは視覚的に目立つ要素に反応して早すぎる操作を実行し、その行動が以降の文脈に入り続けるため復帰できません。
アブレーション(構成要素を外す実験)では、チャネル分解を外したときのTM低下が5.39で最大、ステップ適応的な優先度付けを外すと4.27低下しました。GPへの影響はより大きく、どちらも約5から6ポイント落ちています。加算的な残差を、プロンプトを置き換える方式に変えるとEMが5.30下がったという結果もあり、元の経路を壊さない設計が効いていることがうかがえます。境界窓を4、潜在次元を64としたデフォルト設定の周辺では性能がほぼ平坦で、ハイパーパラメータに過度に敏感ではないことも報告されています。
まとめと課題
FocusGUIの要点は、モデルを作り替えるのではなく、入力のどこを見るかを各ステップで絞る小さな部品を足したという点にあります。凍結したバックボーンに対し100万パラメータ台の追加学習だけで成立するため、導入コストは低く抑えられます。
一方で課題も残ります。チャネルの優先度は現在の観測にもとづいて決まるため、これから起こることを見越した配分はできません。著者らも先読み的な信号の導入を今後の課題として挙げています。評価が単一ベンチマークのOmniGUIに限られ、対象も4種のバックボーンと5つの相互作用カテゴリにとどまる点、PC環境を含む広いコンピュータ操作設定での検証が未了である点も明記されています。Baichuan-Omni-1.5ではTemporal GPが6.77から4.09へ下がっており、すべての指標で一様に改善するわけではありません。
とはいえ、ストリーミング入力を受け続けるエージェントで文脈を絞るという設計思想は、GUI操作に限らず応用の余地があります。何を渡すかより、何を渡さないかを設計する発想として読む価値のある論文です。
論文情報: "Focused Omni-Modal GUI Agents"(Fuyao Zhang et al., 2026) arXiv:2610.26203
本記事の図(図2、図4、図5)は解説のため上記論文より引用しています。


