 AI-Papers
- 履歴の要約や削除はKVキャッシュを無効化して再計算を招くという問題に対し、キャッシュ自体を操作対象にする「キャッシュエンジニアリング」を提案
- 注意対象から外すdropと位置エンコーディングを振り直すreposの2操作、およびステートレスAPIでキャッシュを管理するサービングエンジンAKVを公開
- 3モデル4ベンチマークで平均スコア1.7pt向上、平均コスト27.7%削減、P95レイテンシは1.5倍改善
研究の背景
大規模言語モデル(Large Language Model、LLM)を使ったエージェントは、ツールを呼び出しながら何十回も推論を重ねます。その過程で対話履歴(トラジェクトリ)は際限なく伸び、やがてモデルの最大コンテキスト長を超えてしまいます。
この問題への定番の対処は、コンテキストエンジニアリングと呼ばれる履歴の整理です。古い発言を切り捨てたり、要約に置き換えたりして入力を短く保ちます。
清華大学などの研究チームによる論文「Cache Engineering for Agents」は、この定番手法に隠れたコストを指摘しました。LLMの推論では、過去のトークンから計算したKey/Value(KV)キャッシュを再利用することで、同じ計算の繰り返しを避けています。ところがトラジェクトリの前半を書き換えると、それ以降のキャッシュはすべて無効になり、長大な履歴を一から再計算(再プリフィル)する必要が生じます。
さらに、積極的に履歴を削ると情報が失われ、タスクの正答率そのものが下がります。長い軌跡を扱うエージェントでは、KVキャッシュの入出力と保存が支配的なコスト要因になっているため、この損失は無視できません。
提案手法
研究チームの発想は、テキストを編集するのではなく、エージェントが自分のKVキャッシュを直接操作できるようにすることです。残したい部分のキャッシュはそのまま使い続けられるため、再プリフィルが発生しません。操作は次の3つに整理されています。
append: 新しいトークンのKVを追加する、通常の推論と同じ動作drop: 指定したKVエントリを以降のAttentionの対象から除外するrepos: 残したキーの位置インデックスをRoPEの回転で振り直す
重要なのは、dropが論理的なトークン列や残存キャッシュの中身を変えない点です。reposもキーを回転させるだけで値には触れないため、どちらも再計算を伴いません。穴の空いた位置を詰め直すreposを加えることで、位置情報の不連続による性能低下を防ぎます。
この仕組みには厄介な副作用があります。同じトークン列でも、どんな操作を経てきたかによってキャッシュの状態が変わるため、従来のプレフィックス一致によるキャッシュ再利用が正しく機能しません。そこで研究チームは、サービングエンジンAKVを実装しました。
AKVは既存のAPIと互換のステートレスなインターフェースを外に見せ、内部ではキャッシュの常駐・退避・復元を管理します。基数木(radix tree)にdropノードとreposノードを追加して、トークン履歴と操作履歴の両方を照合する点が設計の核です。退避はdrop済みキャッシュを優先し、復元はdrop/reposの境界でクエリを分割するセグメントバッチAttentionによって1回のプリフィルで済ませます。実装はSGLang v0.5.20ベースで、A800 GPU 8枚の環境で検証されています。
どのキャッシュを捨てるか
では、何を落とすべきでしょうか。研究チームはBrowseComp-Plusの軌跡を分析し、レイヤーとメッセージ位置ごとのAttention密度を調べました。
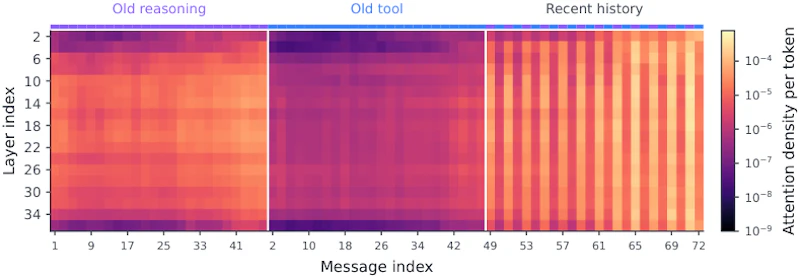
図15に示すように、多くのレイヤーで古いツール応答は古い推論よりも参照されにくく、最近の履歴には強い注意が集まっています。検索結果やファイル内容といったツール応答は、一度読んで要点を推論に書き写した後は見返されないという直感と一致します。
この観察から導かれたのが、最新12件のツール応答と全ての推論を残し、それ以外のツール応答のKVを順次落としていくツール応答ローリングdropです。アブレーションでは、推論側のキャッシュを落とす設定はいずれもスコアを下げました。またBrowseComp-Plusでは、reposを加えることでスコアが55.0から62.0へ改善しており、位置の振り直しが効いていることがわかります。コンテキストの保持戦略という点では、文脈をオブジェクトとして扱うCarryOnのようなテキスト側のアプローチと補完関係にあります。
実験結果
評価はMiniMax-M2.7、GPT-OSS-120B、MiroThinker-1.7-Miniの3モデルで、BrowseComp-Plus、GAIA-Text、SWE-bench Verified、xbench-DeepSearch-2510の4ベンチマークを使って行われました。比較対象は、一定のトークン数に達したら要約する標準設定(Standard)と、より低いしきい値で要約するText Engineeringです。
モデル | 手法 | 平均スコア | 平均コスト(セント) |
|---|---|---|---|
MiniMax-M2.7 | Standard | 52.4 | 5.0 |
MiniMax-M2.7 | Text Eng. | 52.8 | 5.7 |
MiniMax-M2.7 | AKV | 53.7 | 4.4 |
GPT-OSS-120B | Standard | 51.0 | 11.2 |
GPT-OSS-120B | Text Eng. | 48.3 | 10.2 |
GPT-OSS-120B | AKV | 53.1 | 7.3 |
MiroThinker-1.7-Mini | Standard | 44.1 | 20.4 |
MiroThinker-1.7-Mini | Text Eng. | 37.1 | 18.1 |
MiroThinker-1.7-Mini | AKV | 45.8 | 14.8 |
AKVは標準設定に対して平均スコアを1.7pt引き上げ、コストを27.7%削減しました。しきい値を下げて要約を増やすText Engineeringは、GPT-OSS-120BとMiroThinker-1.7-Miniでスコアを大きく落としており、テキストを削る方向には限界があることが読み取れます。
サービング効率の面では、GPT-OSS-120BとSWE-bench Verifiedの組み合わせで、ピークスループット時に出力スループットが1.18倍、入力スループットが1.53倍、P95リクエストレイテンシが1.51倍の高速化を示しました。同じバッチサイズでのAttention時間は59.8%減り、デコード1ステップの時間は16.0%短縮されています。
さらに、キャッシュ方針そのものをエージェントに改善させる再帰的自己改善(RSI)も試されています。反復を重ねた方針は、専門家が設計した方針に対して未知タスクでコストをさらに7.1%削減しました。エージェント自身に削減タイミングを委ねるCache-As-Toolも、BrowseComp-Plusの100タスク部分集合でGPT-OSS-120Bが61.0、MiniMax-M2.7が64.0というスコアを記録しています。
まとめと今後の展望
この研究の貢献は、新しいモデルではなく、エージェント運用の抽象レイヤーを一段増やしたことにあります。コンテキストを「見せる文字列」としてだけ扱ってきた設計を、「どのKVに注意を向けるか」という推論実行時の制御まで広げた点が新しいところです。コードはGitHubで公開されています。
一方で課題も残ります。何を落とすかの方針は、今のところツール応答を狙うという人手の設計や自己改善による探索に依存しており、タスク領域が変わればそのまま使えるとは限りません。drop後も論理的なトークン列は残るため、最大コンテキスト長の制約そのものを解消するわけでもありません。
研究チーム自身も、より多様なキャッシュ操作戦略の探索、キャッシュエンジニアリング前提でのエージェント学習、線形Attentionモデルへのサービング対応を今後の方向として挙げています。エージェントの推論コストが運用の主要な支出になりつつある状況を踏まえると、キャッシュ層の制御は検討に値する選択肢といえるでしょう。
論文情報: "Cache Engineering for Agents"(Tianyu Fu et al., 2026) arXiv:2610.28577
本記事の図(図15)は解説のため上記論文より引用しています。


