 AI-Papers
- 職業的な意図から「情報サポートグラフ」を作り、成果物に必要な情報とその置き場所を逆算して業務タスク環境を自動構築する枠組み
- 仮の解答役(プローブ)に実際に解かせて情報欠落を検出し、依頼文と参考ファイルを修復することで解けないタスクを削減
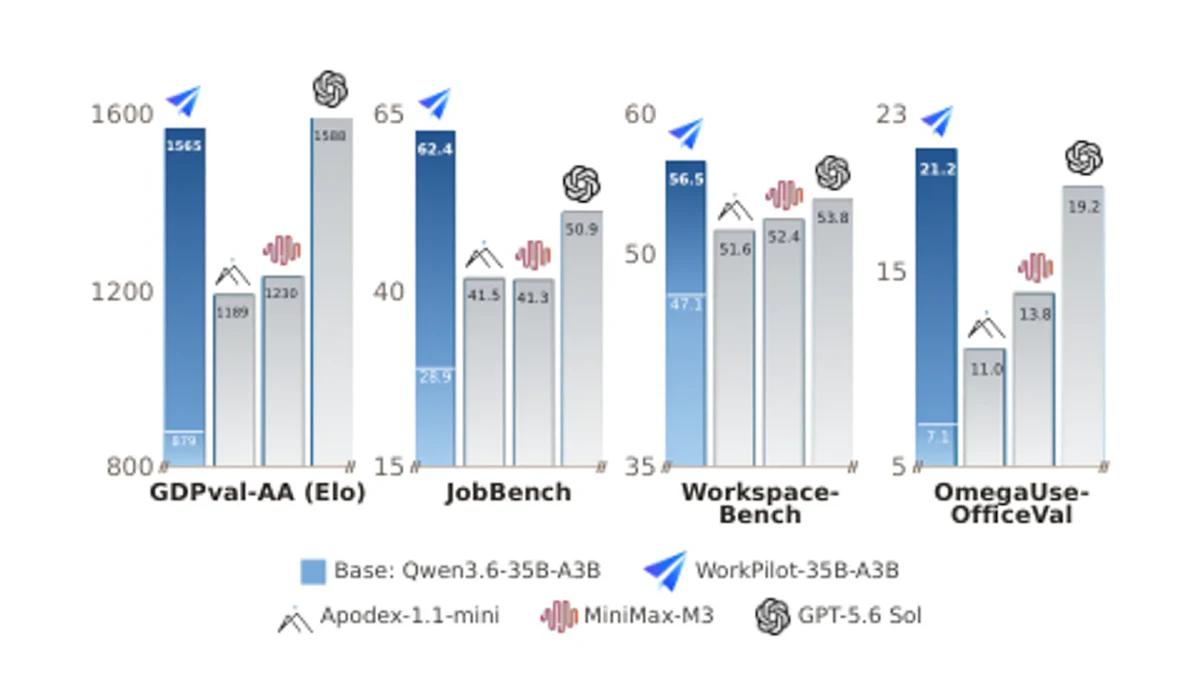
- 612職種11万2686件のタスクで Qwen を微調整した WorkPilot は4つの業務ベンチマークで改善し、GDPval-AA v2.1 の Elo が879から1565へ上昇
研究の背景
スプレッドシートの集計、提案書の作成、見積りの比較といった「実務」をこなす AI エージェントを訓練するには、実際の職場に近いタスクと作業環境を大量に用意する必要があります。しかし人手で作るには費用がかかり、大規模言語モデル(Large Language Model、LLM)に自動生成させると、別の問題が生じます。
依頼文は立派でも、判断に必要な数値が参考ファイルのどこにも書かれていない、複数のファイルで単価や日付が食い違っている、といった状態になりがちです。こうした環境では、教師役の強いモデルでもタスクを完遂できません。結果として学習データに残るのは「途中で詰まった軌跡」ばかりになり、監督信号としての質が落ちてしまいます。
指示の情報が足りないままエージェントが推測で作業を進める危うさは、コーディングAIはあいまいな指示を推測で実行、誤操作率55〜68%でも指摘されている通りです。WorkFactory はこの「情報の欠落」を、データ生成の段階で検出して直すことを狙った研究です。中国の IQuestLab と中国人民大学などの研究者により2026年10月に公開されました。
情報サポートグラフとは
WorkFactory の出発点は、職業階層、文書化されたスキルを組み合わせた複数工程のワークフロー、実在の業務成果物という3つの材料から、職業的な意図を合成することです。LLM の査読役が一貫性・実行可能性・もっともらしさで候補を選別します。
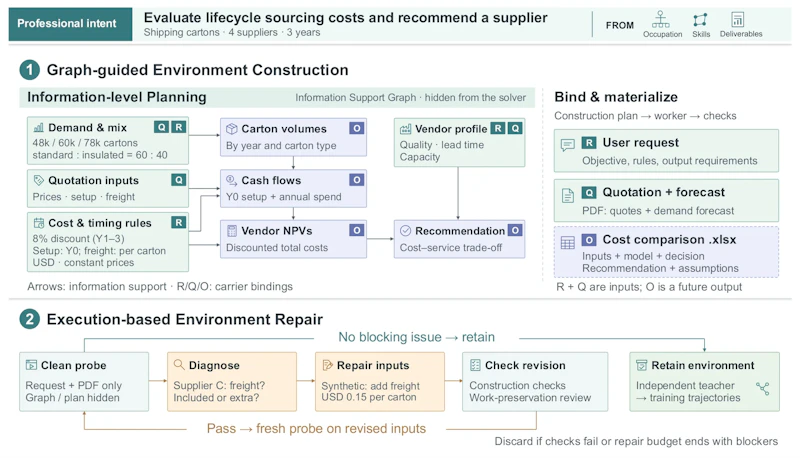
次が中核となる情報サポートグラフです。これは完成させたい成果物から逆向きにたどり、その成果物を作るために必要な情報は何か、その情報はどのキャリア(依頼文、参考ファイル、これから作る成果物)に載るのかを、ノードと支持関係として明示した設計図にあたります。
重要なのは、中間計算や最終的な推奨といった「導出すべき結果」はグラフに書き込まず、解答者側に残す点です。必要な素材はそろえるが答えは与えない、という切り分けによって、解ける一方で自明ではないタスクになります。この設計図に沿って、ファイル群を再利用・改変・新規合成しながら環境を組み立て、プログラム検査と LLM 検査を通します。最大3回までの自動リトライで通らなければ破棄します。
プローブ実行と修復
図2の後半に当たるのが、このパイプラインのもう一つの柱です。組み上がった環境に対し、解答者に見える入力だけを使ってタスクを解くプローブ実行を行い、作業を阻害する水準の不備だけを修復の対象にします。
修復役は依頼文と既存の参考ファイルを編集しますが、ファイルの数や種類は変えません。元の業務内容が保たれているかの審査と構築検査を再び通し、さらに新しいプローブにかけます。修復は最大3回までで、通過した環境だけが残ります。
残った環境に対して、教師モデルの GLM-5.3 がグラフもプローブ結果も見ない状態で改めて挑み、その軌跡を学習データにします。1軌跡あたり平均57.36ターン、62.95回のツール呼び出し、13.6万トークンという長さで、参考ファイルは1タスクあたり平均4.15個です。生成されたコーパスは23の職業大分類、612職種にまたがる11万2686タスクで、成果物の拡張子は53種類に及びます。
実験結果
Qwen3.5-4B、Qwen3.6-27B、Qwen3.6-35B-A3B の3つを教師軌跡で教師ありファインチューニングし、WorkPilot と名付けています。GDPval-AA v2.1 の Elo(対戦形式の相対評価)と、JobBench、Workspace-Bench、OmegaUse-OfficeVal の3ベンチマークで、いずれもベースモデルを上回りました。
モデル | GDPval-AA Elo | JobBench | Workspace-Bench | OmegaUse-OfficeVal |
|---|---|---|---|---|
WorkPilot-4B | 661 → 1375 | 4.67 → 39.87 | 26.92 → 51.30 | 1.71 → 11.77 |
WorkPilot-35B-A3B | 879 → 1565 | 28.91 → 62.35 | 47.12 → 56.53 | 7.14 → 21.18 |
WorkPilot-27B | 975 → 1612 | 37.81 → 63.05 | 49.41 → 59.18 | 10.18 → 26.61 |
最も伸びたのは小さい 4B モデルで、JobBench が4.67から39.87へと大きく改善しました。27B は Elo 1612 に達し、同条件の推定では DeepSeek-V4.1-Flash(1600)をわずかに上回り、教師である GLM-5.3(1646)には34点届いていません。図1はベースモデルとの比較を4つのベンチマークでまとめたものです。
設計要素の切り分け
5000タスク規模の検証では、成果物単位の素朴な計画が Elo 1245、情報サポートグラフの導入で1293、プローブに基づく修復を加えて1326と段階的に上がりました。同時に、プローブで診断された環境不備も減っています。導出の断絶が24.86%から3.26%、ファイル間の矛盾が32.82%から4.84%、実行可能性の問題が10.80%から0.48%へと下がりました。
ただしグラフ単独では、答えの漏れや近道ができてしまう事例がわずかに増えており(1.44ポイント増)、修復工程と組み合わせて初めて8つの不備カテゴリすべてが改善しています。教師モデルを DeepSeek-V4-Flash に替えた3万タスクの比較では生徒の Elo が1248にとどまり、教師の質が結果を左右することも示されました。
まとめと今後の展望
タスクを作ってから実際に解かせ、解けなかった原因を環境側の不備として直すという手順は、エージェント訓練データの設計として素直で応用が利きます。データとモデルは GitHub で公開されており、再現や追試の余地が残されています。
一方で制約もはっきりしています。教師の GLM-5.3 がテキスト入力のみを受け付けるため、訓練と評価はテキストのみで行われ、図表や画像を見て判断する業務は検証されていません。学習も教師ありファインチューニングに限られ、実行フィードバックを使った強化学習は今後の課題として挙げられています。スケールに対する改善幅がモデル依存で逓減している点も、どこまで伸ばせるかを見極めるには追加の検証が必要でしょう。
論文情報: "WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training"(Ziyang Zeng et al., 2026) arXiv:2610.37161, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


