 AI-Papers
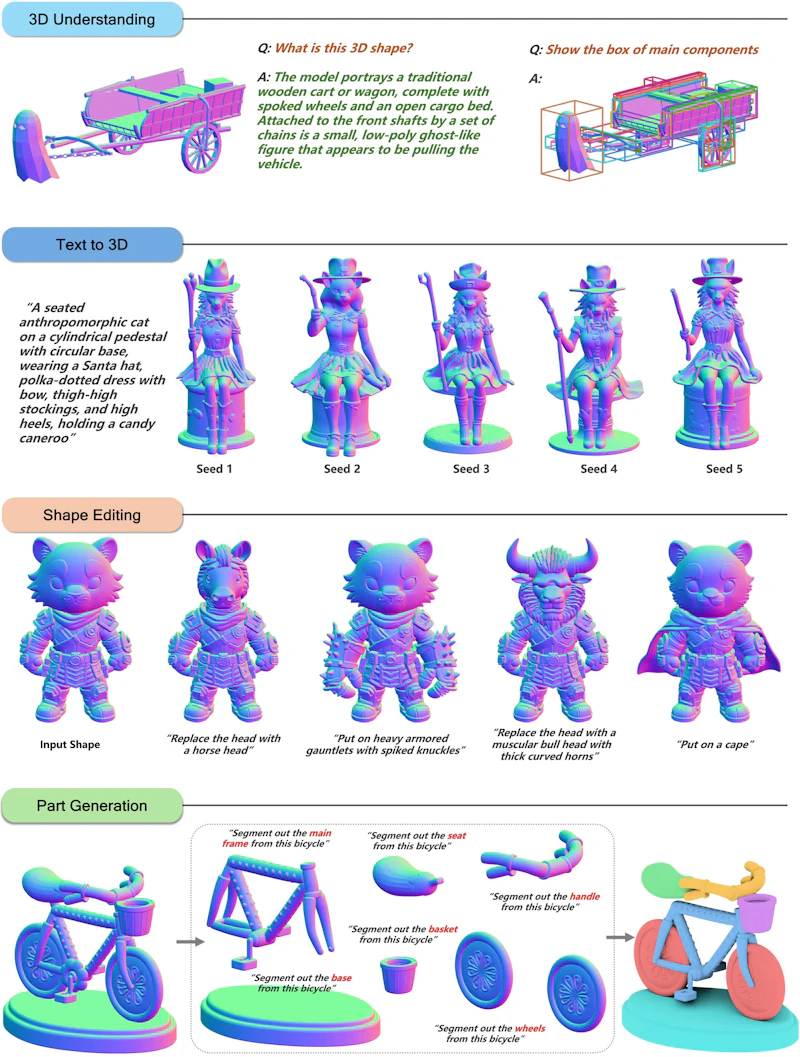
- Tencentが公開した「Hunyuan3D-Buffalo 1.0」は、3Dの理解・生成・編集・パーツ生成を1つのモデルに統合したマルチモーダル基盤モデルです
- 約8700万規模のマルチモーダルデータで学習し、テキストから3D生成でベースライン比約3倍の選好率、編集ではChamfer距離を86.7%削減しました
- テキストから3D生成の能力を鍛えると編集性能も伸びる相乗効果を確認し、低コストなデータ拡張で編集を強化できる道筋を示しました
研究の背景
3Dコンテンツの制作は、ゲームやVR/AR(仮想現実・拡張現実)の普及とともに需要が高まっています。しかし従来は、テキストから3D形状を作る「生成」、形状の意味を読み取る「理解」、既存の形状を作り変える「編集」が、それぞれ別々のモデルとして開発されてきました。
この分業には無駄があります。生成モデルが学んだ形状の知識は編集にも役立つはずですが、モデルが分かれているとその知識を共有できません。近年はテキストや画像の分野で、理解と生成を1つのモデルにまとめる「統合モデル」が主流になりつつあります。
3Dメッシュの高速生成に取り組んだMeshy T2のような専用モデルも登場していますが、複数のタスクを1つにまとめる流れは、まだ3D領域には十分に届いていませんでした。
Tencentが公開したHunyuan3D-Buffalo 1.0は、この統合モデルの発想を3Dへ持ち込んだ研究です。扱うタスクは次の4つです。
- 3D理解
- テキストから3D生成
- 指示にもとづく編集
- テキストで指定したパーツの生成
これら4つを、単一のアーキテクチャで扱えるようにしました。
統合フレームワークの全体像
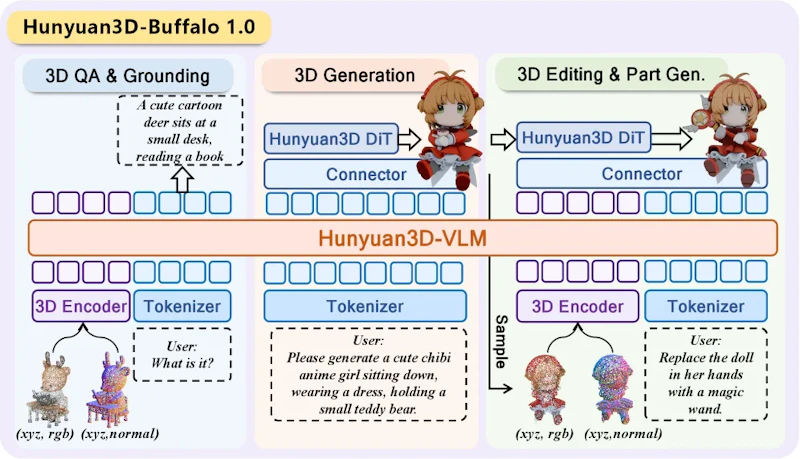
このモデルは大きく2つの部品からなります。1つはHunyuan3D-VLMで、視覚言語モデル(Vision Language Model、画像と言語を同時に扱うモデル)です。自己回帰型(前に出力したトークンを参照しながら1つずつ順番に生成する方式)で動き、形状の意味や構造、空間的な位置関係を読み取る役割を担います。
もう1つはHunyuan3D-DiTで、拡散(ランダムなノイズを段階的に取り除いて形状を作り出す手法)ベースの3D生成モジュールです。テキストから高精細な3D形状を合成する部分を受け持ちます。
2つの部品はどう連携するのでしょうか。まずVLMが計算した中間表現を、MLP-Connectorと呼ぶ小さな変換層で整えます。その出力を3D-DiTへ送り込み、クロスアテンション(生成側が条件情報の必要な部分に注目する仕組み)を通じてノイズ除去の過程を制御します。これにより、言語で受け取った指示がそのまま3D形状の生成へ反映されます。
編集データを作るNano3D-v2
指示ベースの3D編集を学習させるには、「編集前」と「編集後」がペアになったデータが大量に必要です。ところが、こうした編集ペアを人手で用意するには手間もコストもかかります。そこで著者らは、編集ペアを自動生成するツールNano3D-v2を用意しました。
Nano3D-v2は複数の段階で編集データを作ります。まずVLMが編集に適した視点を選び、その視点の2D画像に編集を施します。次に編集前後の2D差分から「どの3D領域を変えるべきか」を予測し、バウンディングボックス(対象を囲む最小の直方体領域)として範囲を定めます。
続いてボクセル(3D空間でのピクセルにあたる立方体の格子セル)単位で形状を編集します。ここで効くのがボクセル結合(voxel-merge)という工夫です。予測した範囲の外にあるボクセルは元の形状に戻すことで、編集が指定領域だけに収まるよう強制します。
最後に細部の形状とテクスチャを整え、自然な編集結果に仕上げます。この仕組みで、約1200万組の編集ペアを構築しました。
実験で示された性能
テキストから3D生成の評価では、強力なベースラインであるOmni123と人間の選好を比べました。結果は次の表のとおりです。
評価項目 | Hunyuan3D-Buffalo 1.0 | Omni123 |
|---|---|---|
テキスト指示との一致度 | 55.2% | 17.5% |
形状の品質 | 57.1% | 21.0% |
総合評価 | 56.6% | 18.4% |
いずれの項目でも、ベースラインの約3倍の支持を集めました。
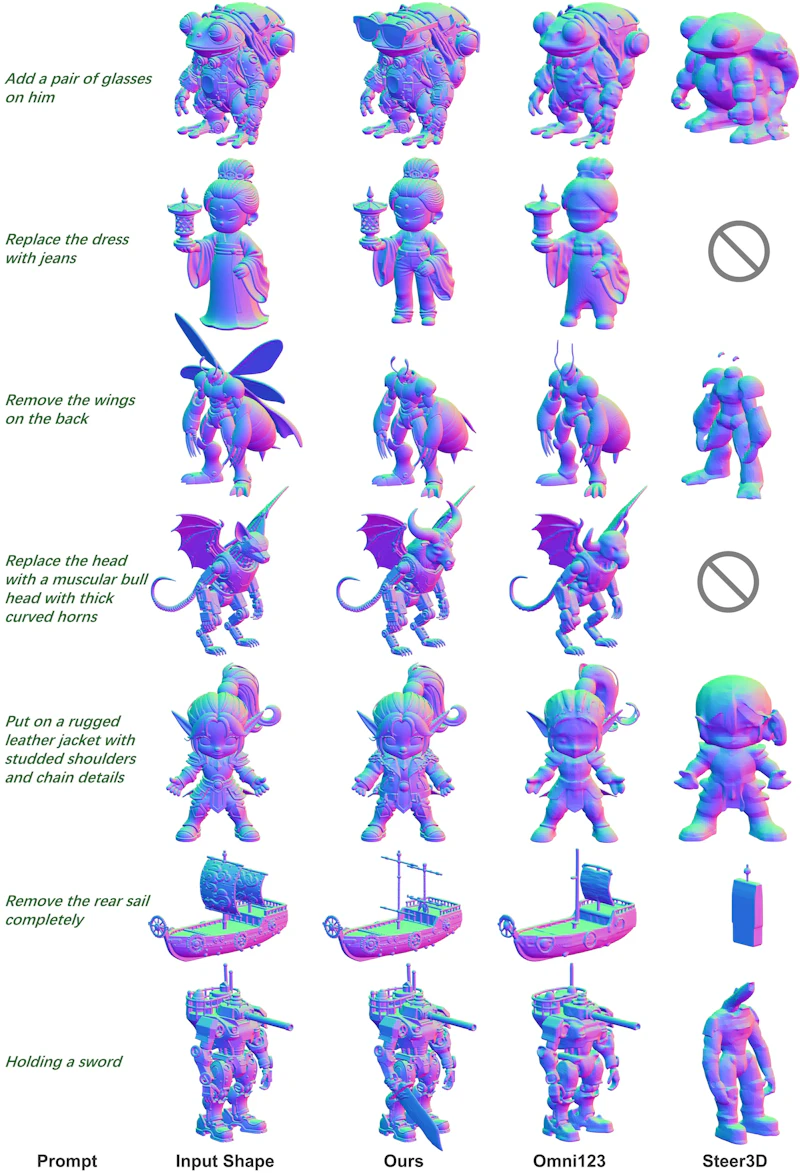
3D編集ではEdit3D-Benchで評価しています。編集前後の形状のずれを測るChamfer距離(2つの点群の近さを表す指標で、小さいほど元の形を保っている)は、Omni123の0.0684から0.0091へと86.7%削減されました。変えるべきでない部分をしっかり保ちつつ、指示された箇所だけを的確に変えられていることを示します。別の指標であるF1スコアでも、Steer3D比で2.39倍の改善を達成しました。
生成が編集を強化する発見
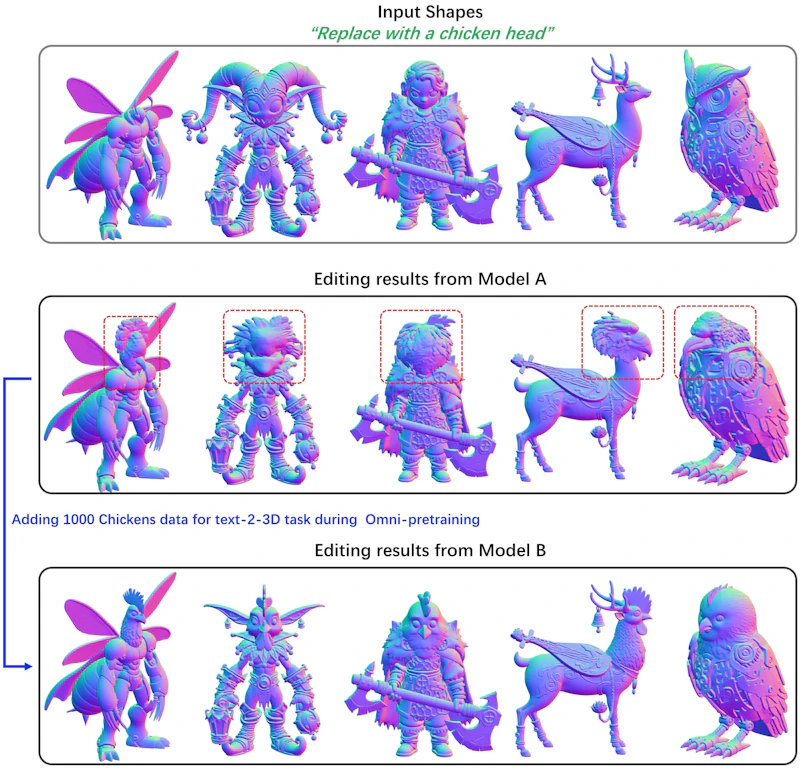
本研究は、生成能力の向上がそのまま編集能力の向上につながることも示しました。著者らは、頭を鶏の頭に置き換える編集に失敗するモデルを用意しました。そのうえで編集用のデータは一切足さず、テキストから3D生成の学習に鶏のサンプルを1000個だけ追加しています。
すると、このモデルは鶏の頭への置き換え編集に成功するようになりました。生成で「鶏の頭とは何か」を学んだ知識が、編集にも転用されたわけです。編集ペアの作成はコストが高い一方、テキストから3D生成のデータは比較的安く用意できます。生成データを増やすことが、編集能力を鍛える現実的な近道になるという指針を示しています。
まとめと今後の展望
Hunyuan3D-Buffalo 1.0は、3Dの理解・生成・編集・パーツ生成を単一モデルに統合し、各タスクが互いを強化し合う相乗効果を実証しました。パーツ生成については、形状の分割を「条件付き生成」として定式化することで、同じモデルが必要に応じて部品を切り出せるようにしています。
一方で課題も残ります。8700万規模のデータと、Nano3D-v2のような複雑な多段パイプラインに支えられており、再現には相応の計算資源と手間がかかります。評価も特定のベンチマークが中心で、実際の制作現場でどこまで通用するかは今後の検証が必要でしょう。
それでも、統合モデルの発想を3Dへ広げ、生成と編集の関係を定量的に示した意義は大きく、ゲームやVR/ARのコンテンツ制作を支える基盤技術としての発展が期待されます。
論文情報: "Hunyuan3D-Buffalo 1.0: A Unified Multimodal Model for Scalable 3D Generation, Understanding, and Editing"(Junliang Ye et al., 2026) arXiv:2608.02711
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


