 AI-Papers
- 頂点ごとに1つの連続潜在トークンへ符号化するvertex-set VAEと、Flow Matchingを組み合わせたネイティブ3Dメッシュ生成手法です
- ボクセルからメッシュへの2段カスケードにより、画像からメッシュまでを中央値6秒で生成し、自己回帰手法の10倍以上高速です
- 面数の直接制御やマルチパート資産に対応し、コードと重みがGitHub(meshy-dev/meshy-t2)で公開予定です
研究の背景
ポリゴンメッシュは、映画やゲーム、インタラクティブな3Dアプリケーションで標準的に使われる表面表現です。頂点と辺、面のつながり方(トポロジー)が制作者の意図どおりに整った高品質なメッシュを生成できるかどうかは、実際のアセット制作の現場で大きな意味を持ちます。
これまで主流だった手法は、メッシュをトークンの列に直列化し、自己回帰的(1つずつ順番に予測する方式)にデコードするものでした。この方式は推論が遅く、途中の予測誤差が後段に累積しやすいという弱点を抱えています。1つ前のトークンに依存して次を決めるため並列化が難しく、対話的なアセット作成には実用的でないという課題がありました。
本記事で紹介するMeshy T2は、Tencentなどの研究チームが提案した、Flow Matchingに基づく高速なネイティブメッシュ生成フレームワークです。順番に生成するのではなく、メッシュ全体を並列的に合成することで、この速度と誤差累積の問題を根本から解決しようとしています。
提案手法
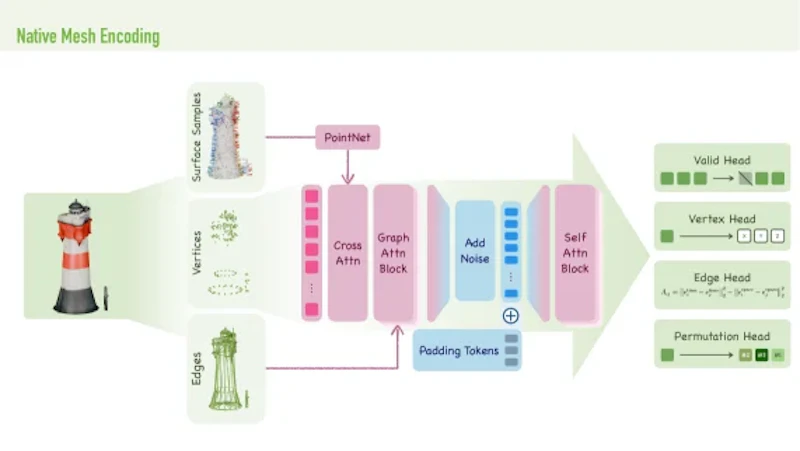
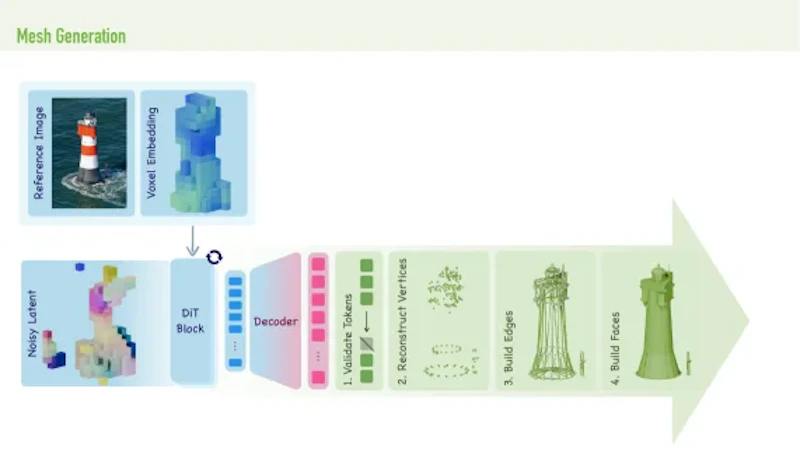
Meshy T2の中核は、メッシュを頂点ごとに1つの連続した潜在トークンへ符号化するvertex-set VAE(頂点集合オートエンコーダ)です。従来手法のような頂点の量子化(座標を離散値に丸める処理)や溶接(重複頂点の統合)を行わず、頂点座標、辺の接続関係、面の向き(winding order)を1回のデコードで一括して復元します。
エンコーダは、表面をサンプリングしたボクセル(3次元の格子状の情報)から得た文脈と、各頂点を表すクエリを組み合わせ、実際のメッシュの辺に沿ったグラフAttention(つながりのある頂点同士に注目する仕組み)を通じて、正解の頂点ごとに1つの潜在トークンを構築します。デコーダはこの潜在トークンから、頂点座標、無向辺、そして局所的なハーフエッジの並び順を復元し、最終的なメッシュを組み立てます。
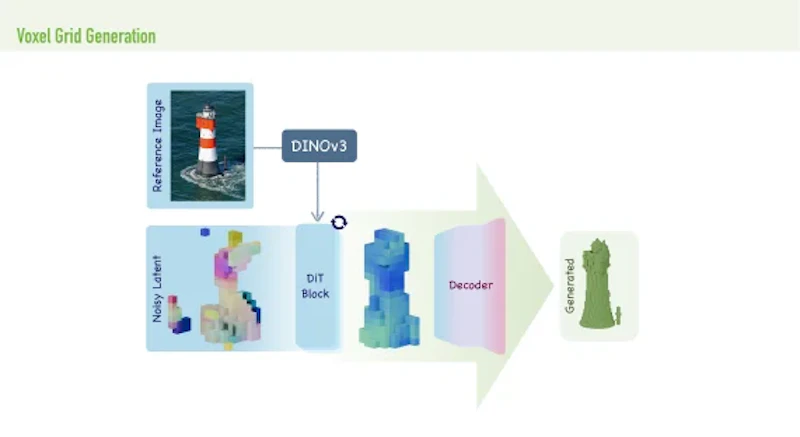
生成のプロセスは、粗いものから細かいものへと段階的に進む2段のカスケードで構成されます。まず、画像を条件とするボクセルFlowが、対象全体のおおまかな形状を粗い占有スキャフォールド(骨組み)として描き出します。次に、メッシュFlowがそのスキャフォールドに頂点ごとの潜在トークンを埋め込んでいきます。
1段目のボクセルVAEは、制作者が作ったメッシュから直接ボクセル化した64の3乗の占有格子で学習され、16の3乗の解像度で空間的な潜在表現を作ります。この潜在をFlow Matchingで生成する際は、DINOv3(画像の特徴を捉える視覚モデル)による画像条件付けを用います。Flow Matchingは、ノイズから目標の分布への滑らかな変換(速度場)を学習する生成手法で、拡散モデルの一種と考えるとわかりやすいでしょう。
2段目のメッシュ生成では、単一ストリームのDiT(Diffusion Transformer)が、潜在トークン、画像トークン、ボクセルトークンをまとめて処理します。ここで工夫されているのが、順序を持たない潜在トークンへの位置情報の割り当てです。Sobol OTと呼ばれる最適輸送(Optimal Transport)に基づく方法で、Sobol列という均等に分布する点列を使って空間的な位置エンコーディングを対応付けます。あわせて、生成する頂点の予算(budget)を指定することで、出力する面数を直接コントロールできます。
実験結果
Meshy T2は、幾何学的な忠実度(元の形状をどれだけ正確に再現できるか)で最先端の性能を達成しつつ、画像からメッシュまでのエンドツーエンドの生成を中央値6秒で完了します。これは自己回帰型のベースライン手法と比べて10倍以上高速な水準です。順番に1トークンずつ生成する方式では避けられなかった遅さを、並列的なFlowベースの合成によって大幅に改善しました。
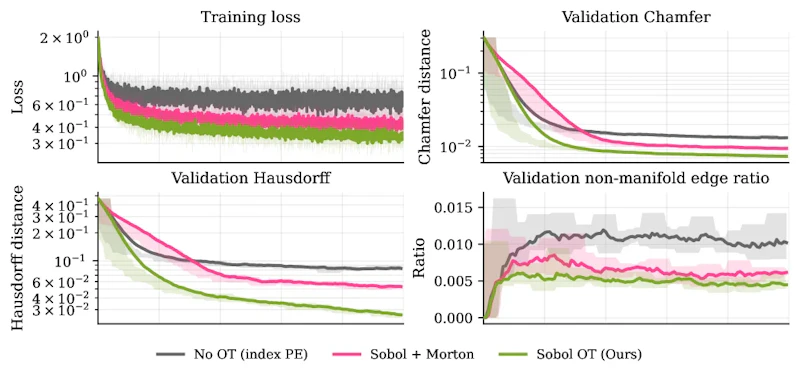
位置エンコーディングと最適輸送に関する検証では、Sobol OTがインデックス順の位置エンコーディングやMorton順のペアリングよりも、検証時のChamfer距離やHausdorff距離、非多様体辺の比率(メッシュの破綻を示す指標)を低く抑えられることが示されています。順序のない頂点トークンに空間的な意味を与える工夫が、生成品質の向上に効いていることがわかります。
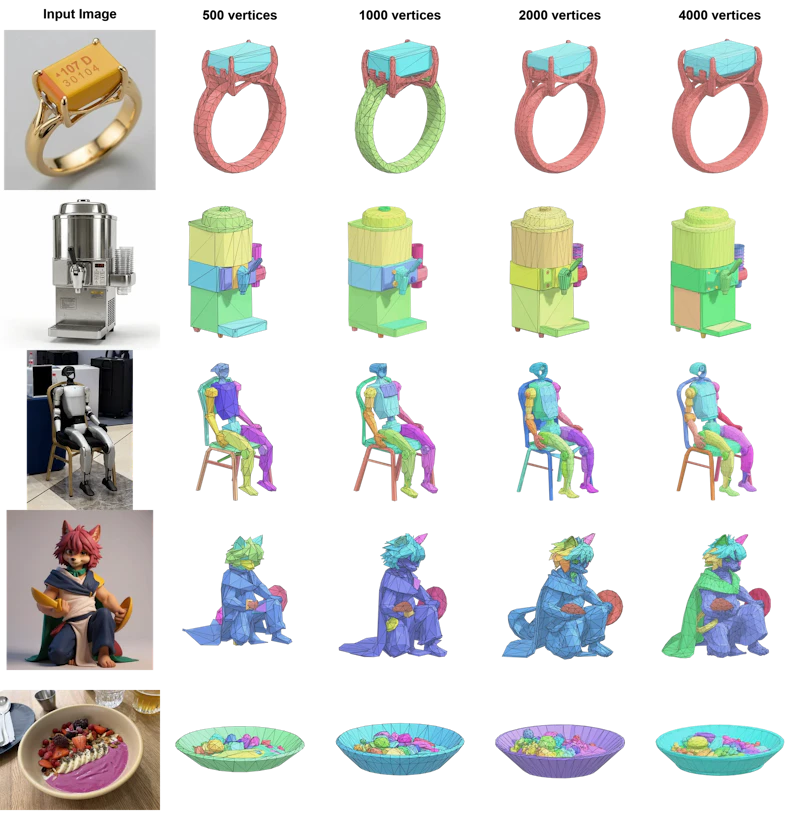
実用面での特徴もあります。要求する頂点予算を通じて面数を実効的に制御できるため、用途に応じた軽量なメッシュから細かいメッシュまで柔軟に出力できます。さらに、頂点と辺を同時に生成する設計により、複数のパーツからなるマルチパート資産が、生成された接続情報から連結成分として自然に分解されます。パーツごとに別々の生成処理を行う必要はありません。
関連する動画生成の高速化手法としては、Chimeraのように拡散Transformerの効率を高めるアプローチも研究されています。
まとめと今後の展望
Meshy T2は、頂点集合をベースとしたVAEとFlow Matchingを組み合わせることで、自己回帰手法が抱えていた推論速度と誤差累積の課題に正面から取り組んだ手法です。量子化や頂点溶接を避けながら制作者スタイルのトポロジーを保ち、6秒という対話的な速度でメッシュを生成できます。ゲームや3Dアセット制作の現場にとって現実的な選択肢になり得るでしょう。
一方で、生成品質は入力画像の条件付けやボクセルスキャフォールドの精度に依存する部分があります。複雑な内部構造を持つ形状や、極端に細かいディテールが求められる場面での限界については、今後さらなる検証が必要でしょう。
コードと重みはGitHub(meshy-dev/meshy-t2)で公開予定とされており、再現性の高さも研究や実務への波及を後押しすると考えられます。3D生成の高速化と制御性の両立に向けた、実務寄りの一歩として位置づけられる研究です。
論文情報: "Meshy T2: Fast Native Mesh Generation with Flow Matching"(Jiale Xu et al., 2026) arXiv:2607.28675
本記事の図(図1、図2、図4、図5、図6)は解説のため上記論文より引用しています。


