 AI-Papers
- ロボット基盤モデルが照明やカメラ位置の変化に弱い原因を、タスクと無関係な視覚手がかりに頼る「視覚と行動の近道」と診断した研究です
- 画像なしで行動方策を先に学習し、姿勢で教師づけした潜在インターフェース経由でのみ視覚を注入する2段階学習LITを提案しています
- 4種のアーキテクチャでLIBERO-Plusを3.87〜10.70pt、未知の照明やカメラ配置の実機タスクで13.30〜16.70pt改善しました
研究の背景
カメラ画像と言語指示からロボットの動作を直接出力するVision-Language-Action(VLA)モデルは、学習時と同じ環境では高い成功率を示します。ところが照明を変えたり、カメラの取り付け位置をずらしたり、机の上に関係のない物体を置いたりするだけで成功率が大きく落ちる現象が知られています。
この論文は、その原因を学習の仕組みそのものに求めます。行動を予測するモジュール(action expert)を画像表現に直接条件づけて学習させると、モデルは「この背景の見え方のときはこう動く」といった、タスクの意味とは無関係な視覚と行動の相関を近道として覚えてしまうという診断です。
近道を封じるには視覚情報を弱めればよさそうに思えますが、物体や手先の位置といった空間情報は動作生成に不可欠です。単に視覚を絞るだけでは、必要な情報まで落ちてしまいます。ロボット制御をVLMに任せる別のアプローチについてはShow-Harnessの解説記事も参考になります。
LITの2段階学習
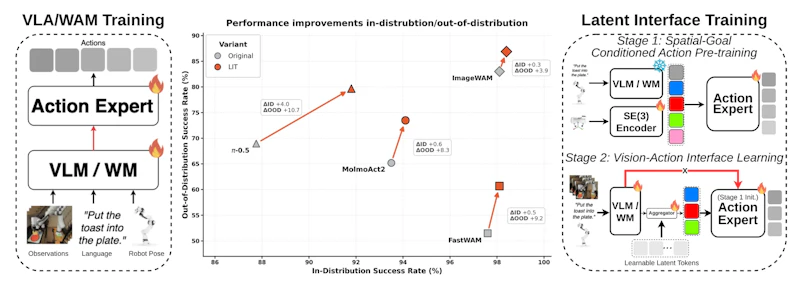
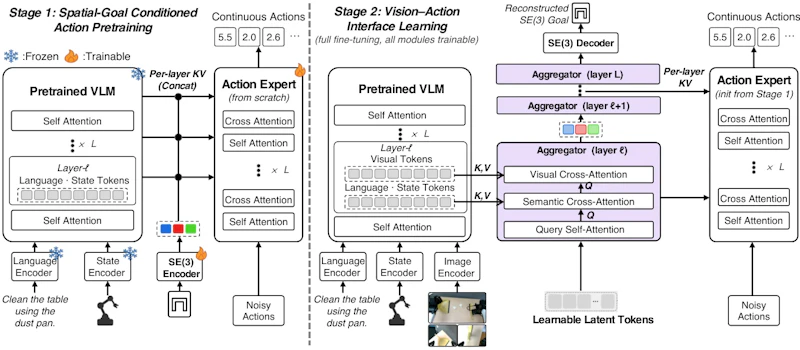
提案手法のLatent Interface Training(LIT)は、特定のモデルに依存しない2段階の学習戦略です。図1が示すように、視覚条件づけの入り方が従来の学習と根本的に異なります。
第1段階では、画像をいっさい使わずに行動方策を学習します。行動モジュールに与えるのは言語指示、ロボットの状態、そして各デモの行動チャンクが最終的に到達する手先の姿勢(SE(3)、3次元位置と3次元姿勢にグリッパ状態を加えた8次元)だけです。空間的なゴールから動作列を導く事前分布を、視覚との相関を持たない形で先に作ってしまうわけです。
第2段階で視覚を導入しますが、経路は1つに限定されます。100個の学習可能な潜在トークンが、バックボーンの視覚表現と意味表現を自己注意と交差注意で集約し、そのトークンだけが行動モジュールを層ごとに条件づけます。さらにこのトークンには、第1段階と同じ最終姿勢を復元させる損失がかかります。
つまり視覚情報は「空間的なゴールを復元できる形」に絞り込まれてから行動側に渡ります。近道の温床になる生の視覚特徴への直接アクセスを断ちつつ、タスクに必要な空間情報は保持する設計です。
実験結果
評価にはπ0.5、MolmoAct2、FAST-WAM、ImageWAMという4種類のアーキテクチャが使われました。視覚条件を変動させたLIBERO-Plusと、標準的なLIBEROの両方で比較しています。
アーキテクチャ | LIBERO-Plus(ベース→LIT) | LIBERO(ベース→LIT) |
|---|---|---|
π0.5 | 68.97% → 79.67%(+10.70) | 87.75% → 91.80% |
MolmoAct2 | 63.62% → 71.92%(+8.30) | 93.50% → 94.10% |
FAST-WAM | 51.44% → 60.63%(+9.19) | 97.60% → 98.10% |
ImageWAM | 83.02% → 86.89%(+3.87) | 98.10% → 98.40% |
分布外での改善幅は3.87〜10.70ptで、同時に学習分布内のLIBEROでも成功率が下がっていません。汎化のために既知環境の性能を犠牲にする、というトレードオフが起きていない点は評価できます。もっともImageWAMのように元から強いモデルでは伸び幅が小さく、効果はベースラインの弱さに依存する面があります。
MolmoAct2を対象にした構成要素の切り分けでは、第1段階の画像なし事前学習を外すと3.69pt、姿勢の教師づけを外すと3.06pt、潜在トークンを迂回して視覚に直接アクセスさせると4.18pt下がりました。3つの要素がそろって初めて効果が出る構成といえます。
実機での検証
実機評価では、以下の3つの操作タスクを、学習時と同じ条件に加えて照明変化、未知のカメラ配置、無関係な物体の設置という3種類の視覚変動のもとで実行しています。
- Keep LEGOs(ブロックを外して箱に入れる)
- Wipe trash(ちりとりで机の上を掃除する)
- Transfer egg(フライパンから器に卵を移す)
集計した成功率は、照明変化で53.3%から70.0%、カメラ配置の変更で30.0%から46.7%、無関係な物体がある条件で50.0%から63.3%へ改善しました。特にカメラ配置の変更はベースラインが30%まで落ち込む厳しい条件で、それでも16.7pt積み増しています。
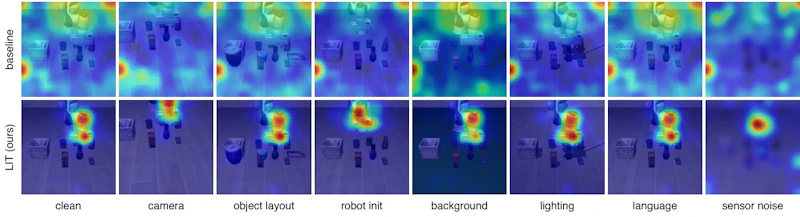
行動から画像への注意の可視化も行われています。図4のように、ベースラインは条件が変わるたびに注意先が大きくぶれるのに対し、LITはロボットと対象物という、タスクに関係する領域に注意を向け続けていました。
まとめと今後の課題
LITは、視覚と行動の近道をアーキテクチャ側の制約で断ち切るという方針を、4種類のモデルに共通して適用できる形でまとめた研究です。追加のアノテーションは手先の姿勢という既存のデモから得られる情報で済み、導入の敷居も比較的低いといえます。
一方で課題も残ります。著者自身が、より大規模な実世界環境での評価は未着手だと述べています。実機検証は3タスクにとどまり、学習データの多様性を大きく広げたときに同じ効果が保たれるかは今後の検証待ちです。また2段階学習である以上、学習コストは単純な一括学習より増えます。
論文情報: "Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models"(Jianman Lin et al., 2026) arXiv:2609.12641
本記事の図(図1、図2、図4)は解説のため上記論文より引用しています。


