 AI-Papers
- HopChainは視覚インスタンスを論理的に連鎖させる4段階パイプラインでマルチホップ推論データを自動合成し、VLMの訓練品質を高める
- Qwen3.5モデルで24ベンチマーク中20個の性能改善を達成。超長CoT推論領域では応答長に比例して改善幅が拡大し、50ポイント超の向上を記録した
- 特定アーキテクチャに依存しない汎用設計で、既存VLMのファインチューニングデータ拡充に広く活用できる実用性の高いフレームワーク
研究の背景と課題
近年のビジョン言語モデル(Vision-Language Model、VLM)は、画像とテキストを組み合わせた複雑な推論タスクで急速な発展を遂げています。しかし、長い思考連鎖(Chain-of-Thought、CoT)を要するタスクになると、知覚エラー・推論の誤り・知識の欠如・幻覚といった複合的な失敗パターンが顕在化するという課題がありました。こうした問題は単体のエラーではなく複数の要因が絡み合うため、一般的な改善手法では対処しにくいとされています。
Qwen研究チームはこの課題を分析した結果、訓練データの質的欠如こそが長CoT推論の性能を制約する根本要因だと結論づけました。単純な1段階の問答データでは、複数の視覚的手がかりを論理的に組み合わせて答えを導く「マルチホップ推論」の能力を十分に育てられません。そこで提案されたのが、マルチホップ推論データを自動合成するフレームワーク「HopChain」です。
HopChainの仕組み
HopChainは、生の画像から検証済みのマルチホップ質問を自動生成する4段階のパイプラインです。各ステップが前段階の出力を受け取って次へ渡す連鎖構造となっており、人手によるアノテーション(正解データの付与)を最小化しつつ高品質なデータを合成できます。
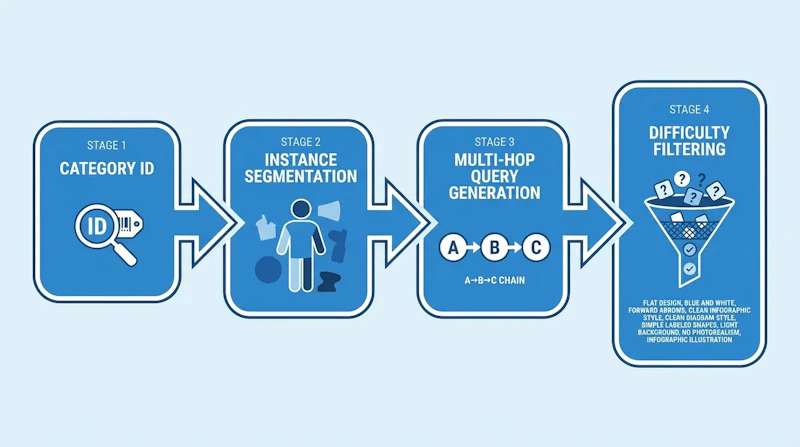
第1段階(カテゴリ識別)では、Qwen3-VL-235Bが画像内に存在する意味カテゴリを列挙します。第2段階(インスタンスセグメンテーション)では、識別されたカテゴリに基づいて個別インスタンスの境界ボックスとセグメンテーションマスクを生成します。論文ではSAM3(Carion et al., 2025)を活用して各インスタンスの正確な位置情報を取得しています。
第3段階(マルチホップクエリ生成)がこのパイプラインの核心です。3〜6個のインスタンスを組み合わせて選び、前のホップの答えが次のホップの前提条件となる論理依存チェーンを構築します。「A→B→C」という形で、Aを解かなければBに進めない依存関係を持つ複合的な質問が生成される仕組みです。
最後の第4段階(難易度キャリブレーション)では、4人の注釈者が独立して各クエリを解答し、全員が一致した数値回答のみを保持します。弱いモデルで100%の精度を達成できる簡単すぎるクエリは除外し、適切な難易度水準を維持します。
このパイプラインは特定のモデルアーキテクチャに依存せず、検出可能なインスタンスを含む幅広い画像コレクションに適用できます。Penguin-VLのようにVLMのアーキテクチャ自体を刷新するアプローチとは異なり、HopChainは訓練データの品質改善という観点からモデルの推論能力向上を目指しました。
実験結果
HopChainで合成したデータをQwen3.5モデルのファインチューニングに活用した結果、STEM推論・視覚的質問応答(VQA)・テキスト認識・動画理解にわたる24のベンチマーク中、20個で性能改善が確認されました。主要なベンチマークのスコアは次のとおりです。
モデル | ベンチマーク | HopChain適用後 | 適用前 |
|---|---|---|---|
Qwen3.5-35B-A3B | MathVision | 76.05 | 73.71 |
Qwen3.5-35B-A3B | CharXiv | 73.10 | 69.00 |
Qwen3.5-397B-A17B | MathVision | 83.71 | 81.68 |
Qwen3.5-397B-A17B | CharXiv | 77.20 | 74.60 |
CharXivはグラフ理解を測るベンチマークで、小規模モデルでも4ポイント以上の伸びが出ています。ホップ数を減らすアブレーション実験(構成要素を削って効果を確かめる実験)では、次の表のように平均スコアが段階的に低下しました。
構成 | 平均スコア |
|---|---|
マルチホップ | 70.4 |
シングルホップ | 66.7 |
ホップなし | 64.3 |
多段階のチェーン構造そのものが性能に寄与していることが、この比較から読み取れます。
推論の応答長と改善幅の関係も分析されています。論文のFigure 6によれば、応答トークン数が増えるほどマルチホップデータの効果が際立ち、超長CoT領域では50ポイントを超える改善が記録されました。一方、MMMU・MathVista(mini)・HallusionBench・LVBenchの4ベンチマークでは改善が見られておらず、これらのタスク特性に対応したデータ設計の最適化が今後の検討課題として残っています。
今後の課題と展望
HopChainには現時点でいくつかの制約があります。パイプラインがインスタンスセグメンテーションに依存しているため、検出可能なオブジェクトが少ない画像や高度に抽象的な図表では適用が困難です。論文では次のステップとして、セグメント化しにくい画像向けの補完的なデータ構築ルートの開発を明示的に挙げています。
また、合成データが持つ品質の上限も課題の一つです。自動生成されたクエリの多様性や難易度分布が実際の試験問題と乖離する可能性があり、ベンチマーク間の性能差に影響している可能性があります。ホップ数の最適な設計や、タスク種別に応じたチェーン構造のカスタマイズについても、さらなる探究の余地があります。
今後の研究方向としては、動画や3D空間など時系列・立体情報を含む視覚データへの拡張が期待されます。現在の評価はQwen3.5モデルが主な対象ですが、他アーキテクチャのVLMへの適用検証を広げることで、フレームワークの汎用性をさらに実証できるでしょう。
まとめ
HopChainは、複数の視覚インスタンスを論理的に連鎖させるマルチホップ推論データを自動合成してVLMのファインチューニングに活用するフレームワークです。アーキテクチャに依存しない設計と、24ベンチマーク中20個での性能改善という結果は、データ品質の向上がモデル能力に直結することを示しています。
長い推論連鎖が求められるタスクほど恩恵が大きく、超長CoT領域での50ポイント超の改善はその可能性を端的に示す成果です。インスタンス検出が困難なシーンへの対応や他アーキテクチャへの展開といった課題はあるものの、VLMの複雑推論能力を底上げするデータ中心のアプローチとして、幅広い応用が見込めます。


