 AI-Papers
- On-Policy蒸留で生徒を教師に近づけるのではなく、強化学習が生んだ表現の変化を「方向」として取り出し、教師より先まで外挿する手法RIDEが提案されました
- 出力(ロジット)空間での外挿が言語モデルヘッドによって減衰し不安定になる問題を、隠れ状態の残差を直接使うことで回避します
- 規模もアーキテクチャも異なる4組のベース・RL教師ペアすべてで、生徒がRL教師に匹敵または超過しました
研究の背景
大規模言語モデル(Large Language Model、LLM)の学習済みモデルを小さなモデルに移す方法として、On-Policy蒸留(On-Policy Distillation、OPD)が広く使われています。生徒モデル自身が生成した文(軌跡)の上で、教師モデルの次トークン確率分布に合わせるように学習させるやり方です。生徒が自分で踏む経路の上で教師の判断を学べるため、教師の出力をそのまま真似る従来型の蒸留より安定した改善が得られてきました。
ただし、この枠組みでは生徒の到達点は教師で止まります。そこで近年は、教師とベースモデルの出力確率の差を「暗黙の報酬」とみなし、その差の方向に生徒をさらに押し出す外挿型の手法が試されてきました。生徒が教師を超えられる可能性を持つ点で魅力的な発想です。
ところが本論文は、この出力空間での外挿が構造的な弱点を抱えていると指摘します。強化学習(Reinforcement Learning、RL)によって教師の内部表現に生じた変化は、最後の言語モデルヘッド(隠れ状態を語彙上のスコアに変換する線形層)を通る際に方向ごとに不均一に減衰します。隠れ状態に強く刻まれた変化の多くが、ロジットに届く段階ではごく一部の重みしか残らないのです。さらに、サンプリングされたトークンの対数確率の比に依存する手法は、その比に含まれるノイズを外挿が増幅してしまい、学習が不安定になります。
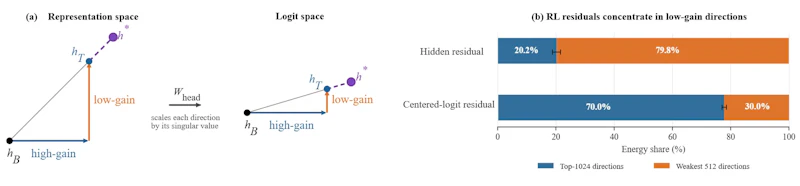
図1は、この減衰が方向ごとに偏っていることを示しています。隠れ状態の段階では教師とベースの差(残差)が大きなエネルギーを持つ方向であっても、ヘッドを通過したあとのロジットではその寄与が大きく削られるケースがあります。出力だけを見ていては、教師が強化学習で獲得した変化の全体像をつかめないわけです。
提案手法
提案手法のRIDE(RL-Induced Direction Extrapolation)は、外挿を行う場所を出力空間から表現空間へ移します。まずRLで訓練された教師と、そのRL前のチェックポイント(ベースモデル)を用意し、同じ入力に対する隠れ状態の差を各層・各トークン位置で測ります。この差が、強化学習によって引き起こされた表現の変化、すなわち教師が進んだ「方向」です。
RIDEは生徒の隠れ状態を、教師の位置そのものではなく、その方向に沿って教師より先へずらした目標点に向けて回帰させます。論文の表題にある「教師は到達点ではなく方向である」という主張がここに集約されています。この学習は、教師を中心とした二次ペナルティのもとで、残差方向に沿った線形の報酬を最大化することと等価だと整理されています。つまり、教師から離れすぎないよう抑えながら、教師が向かっていた先へ生徒を押し出す設計です。
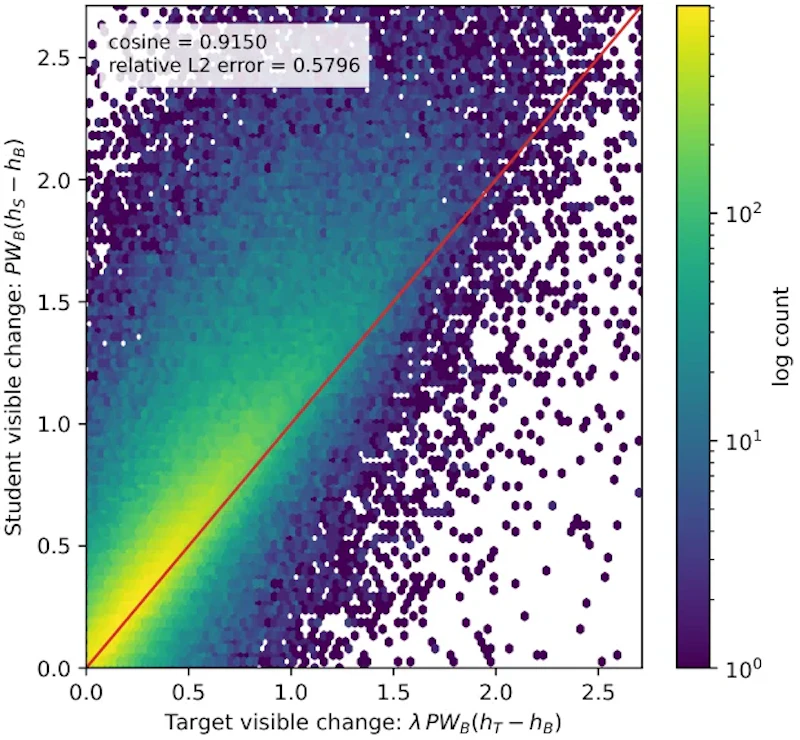
隠れ状態で変位を測る利点は、勾配が決定的になり、サンプリング由来のノイズが入り込まないことです。図2が示すように、生徒の変化は目標とする変化に素直に追従します。出力空間の外挿が確率比の揺らぎに振り回されるのに対し、RIDEは安定した更新を得られます。On-Policy蒸留そのものの基礎については知識蒸留とは?LLM小型化の仕組みとオンポリシー蒸留、量子化との違いを解説も参考になります。
実験結果
評価には、規模・アーキテクチャ・事前学習の系統が異なる4組のベースとRL教師のペアが使われました。
- R1-Distill-1.5B と JustRL-DeepSeek-1.5B
- Qwen3-4B と Just-Qwen3-4B
- Llama-3.2-3B と Just-Llama-3.2-3B
- Phi-4-mini と Just-Phi-4-mini
ベンチマークは数学推論の AIME 2024、AIME 2025、および AMC 2022-2023 を含む AIMO です。比較対象は、表現空間で教師に一致させるだけの OPRD と、出力空間で外挿する ExOPD です。
結果として、RIDEは4組すべてでRL教師に匹敵または超過し、平均値で教師を上回った唯一の手法となりました。教師に単に一致させる OPRD は一貫して教師に届かず、出力空間で外挿する ExOPD は、教師がベースモデルから大きく離れていない場合に生徒の性能をかえって損なう傾向を示しました。教師とベースの差が小さいとき、確率比に含まれるノイズの割合が相対的に大きくなり、外挿がそれを増幅してしまうためと考えられます。
限界と今後の展望
著者らは適用条件の制約を明示しています。RIDEはRL前のチェックポイントが手元にあること、そして教師と生徒が表現空間を共有していることを前提とします。教師の公開が最終モデルだけに限られる場合や、語彙や内部次元が大きく異なるモデル間では、そのまま適用できません。
また、外挿の強さは単一のグローバル係数で制御されており、層やトークン位置ごとに調整する余地が残されています。評価は数学推論タスクと1種類のRLレシピに限られているため、コード生成や対話など性質の異なるタスクへ一般化するかは未検証です。生徒の確率の校正(出力確率の信頼度の妥当さ)や安全性に関する振る舞いも、実運用の前に個別に確かめる必要があると述べられています。
教師の内部表現の変化を方向ベクトルとして扱う考え方は、蒸留に限らずポストトレーニング全般に転用しやすい発想です。コードはGitHubで公開されており、手元のモデルペアで追試しながら前提条件の緩め方を探る余地は広いと言えます。
論文情報: "The Teacher Is a Direction, Not a Destination: Extrapolating RL-Induced Representation Residuals in On-Policy Distillation"(Hao Li et al., 2026) arXiv:2609.36484
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


