 AI-Papers
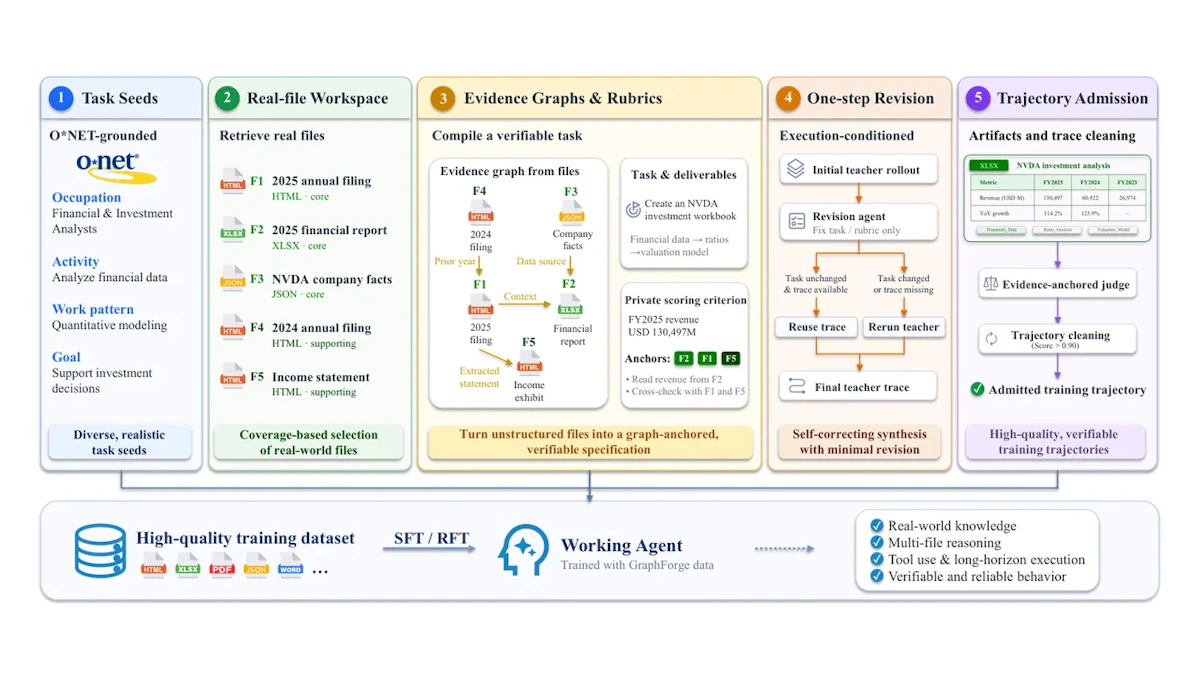
- 実ファイルの関係を「証拠グラフ」として構築し、課題文と採点ルーブリックの両方をファイルに接地させる訓練データ合成パイプライン
- わずか2,169件のトラジェクトリで教師ありファインチューニングし、GDPVal(OpenHands)で65.7ポイント、SpreadsheetBench IIで13.7ポイント改善
- 同じルーブリックをリジェクションファインチューニングの選別信号に再利用でき、データとモデルは公開済み
研究の背景
実務で役に立つAIエージェントには、形式の異なる多数のファイルを読み、複数のツールを連携させ、最終的に成果物(deliverable)を作り上げる能力が求められます。表計算、文書、スライド、画像などが混在したワークスペースを扱う作業は、Webブラウジングや単発のコード生成とは性質が異なります。
こうした「ワーキングエージェント」を訓練するには、多数の実ファイルの上に組まれ、かつ結果を検証できる課題が大量に必要になります。ところが論文の著者らが指摘するとおり、この種のデータを合成するパイプラインはほとんど存在しませんでした。
従来の合成アプローチの弱点は、課題文も検証基準もモデルが文章として作文してしまう点にあります。架空のファイル名や存在しない数値を前提にした課題ができあがり、採点基準もワークスペースの実態と噛み合わないという問題が起きます。GraphForgeは、この接地(grounding)の欠如を正面から扱った研究です。
提案手法
GraphForgeのパイプラインは、職業分類データベースO*NETに由来するシード(種となる職務設定)から始まります。シードごとにエージェントが実ファイルを集めてワークスペースを組み立て、各ファイルには「どの役割を担うファイルか」という情報が隠された状態で配置されます。
次にモデルが、ファイル間の関係を表す証拠グラフ(evidence graph)を構築します。そしてこのグラフから課題仕様をコンパイルし、採点ルーブリックの各基準をグラフのノード、つまり検証に必要な具体的ファイルに結び付けます。課題の要求はワークスペースのファイルに裏打ちされ、採点基準も「どのファイルを見れば判定できるか」が明示されるという構造です。
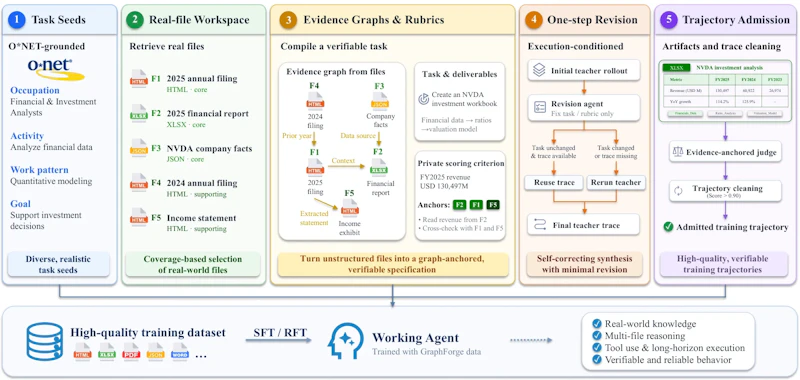
図1に示すとおり、ここで一度ティーチャーモデルによるロールアウト(試行)が入ります。この初回実行は課題が実際に遂行可能かを検証する役割を持ち、その結果をもとに課題仕様を1ステップだけ修正します。作れない課題や曖昧な指示を、データ収集の前に取り除く仕組みです。
最終的に得られたトラジェクトリは、証拠に紐づいた判定器(evidence-anchored judge)で採点され、基準を満たしたものだけが訓練データとして採用されます。生成から選別までが一貫して同じルーブリックに乗っているのが特徴です。
この設計の副産物として、ルーブリックは学習後にも使えます。著者らは教師ありファインチューニング済みモデル自身のロールアウトに対し、同じ証拠接地ルーブリックで候補を選別するリジェクションファインチューニングを行い、さらなる改善を得ています。採点の仕組みを評価と学習の両方で使い回せる点は、エージェント学習の運用コストを下げる要素です。評価側で状態を直接見る発想は、Microsoftがデータベース状態でエージェントの信頼性を測るThinkingBoxとも共通します。
実験結果
著者らはQwen 3.6-27Bを、GraphForgeで合成した2,169件のトラジェクトリでファインチューニングしました。3つのベンチマークでの結果は次のとおりです。
ベンチマーク | 実行環境 | スコア | 改善幅 |
|---|---|---|---|
GDPVal | OpenHands | 1445.7 | +65.7 |
Workspace-Bench-Lite | Claude Code | 63.7 | +7.7 |
SpreadsheetBench II | Claude Code | 24.0 | +13.7 |
GDPValは経済的に価値のある実務タスクを対象とした評価で、スコアの絶対値が大きい指標のため、1445.7という値そのものより65.7ポイントという伸び幅が要点になります。SpreadsheetBench IIでは10.3から24.0へと倍以上に伸びており、表計算という難度の高い作業で効果が大きく出ています。
2,000件強という規模でこれだけの改善が出たことは、データ量よりも課題の接地性と検証可能性が効いている可能性を示します。ただし比較対象となるベースラインの訓練条件や、スコアの伸びがどこまで評価環境(OpenHands、Claude Code)に依存するかは、再現実験で確かめる余地があります。
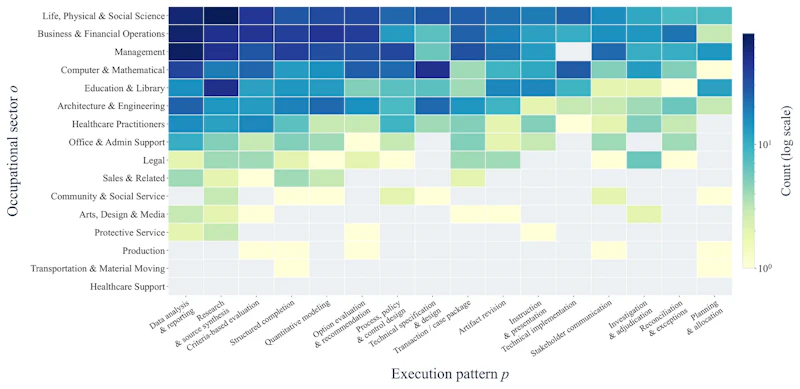
図2は、生成されたデータが職業セクターと実行パターンの両軸でどれだけ広がっているかを示したものです。灰色のセル、つまり観測されていない組み合わせが残っており、O*NET由来のシードを使っても網羅性には偏りがあることがわかります。
まとめと今後の展望
GraphForgeの要点は、課題と採点基準を同じ証拠グラフから導き、実ファイルに接地させたことにあります。合成データの品質問題を「作文の巧拙」ではなく「検証可能性の構造」として扱った点が、他の合成パイプラインとの違いです。
一方で課題も残ります。証拠グラフの構築やティーチャーロールアウトを含むパイプラインは生成コストが高く、図2が示すように職種と実行パターンの網羅には空白があります。また改善幅の検証がQwen 3.6-27Bという1つのベースモデルに限られているため、他のモデル規模やアーキテクチャでも同じ効果が出るかは未確認です。
データとモデルが公開されているため、追試や拡張は進めやすい状態にあります。実ファイルを扱うエージェントの訓練データ不足は多くの開発現場に共通する制約であり、検証基準をデータ生成と選別の両方で使い回す設計は、他のドメインにも応用しやすいと考えられます。
論文情報: "GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis"(Qisheng Su et al., 2026) arXiv:2609.38923, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


