 AI-Papers
- 学習済みのWan2.1-14BのDiffusion TransformerをそのままピクセルΩ空間へ移し、VAEデコーダを畳み込みヘッドに置き換えた動画生成モデルPixVid
- 速度ではなくクリーンな動画を予測し、ノイズシフトを大きく取る設計で画質を確保。VBench総合で84.78を記録し潜在モデルを上回った
- 1フレーム単位の生成により制御入力への応答遅延が34ミリ秒まで短縮され、同一トークン数で2倍の解像度を扱える
研究の背景
現在の主要な動画生成モデルは、動画をそのまま扱わず、VAE(変分オートエンコーダ)で圧縮した潜在空間で拡散過程を回しています。空間方向に8分の1、時間方向に4分の1といった圧縮をかけることで計算量を抑え、最後にVAEデコーダでピクセルへ戻す構成です。
この設計は効率的ですが、3つの制約を生みます。解像度を2倍にするとトークン数が4倍に膨らむこと、条件付けが複数フレームをまとめた単位でしかかけられないこと、そして自己回帰生成では1ブロック分のフレームが揃うまで応答が待たされることです。
対話的な動画生成やワールドモデルでは、この「ブロック単位でしか動けない」性質が体験を直接損ないます。Back to Pixelsと題された本論文は、潜在空間を経由せず全フレームをピクセル空間で直接生成するPixVidを提案し、ゼロから学習し直さずに既存の潜在モデルを移植する手順を示しました。
学習済みモデルをピクセルへ移す
PixVidの出発点は、ゼロから巨大なピクセル空間モデルを学習するのは現実的でないという認識です。そこで著者らは、Wan2.1-14BのDiffusion Transformer(DiT)本体の重みを保持したまま、入口と出口だけを取り替えるという方針を取りました。
入口では、ピクセルのパッチと対応するVAE潜在トークンの間の線形変換をあらかじめ500本のクリップから推定し、学習済みのパッチ埋め込みと合成します。これにより、ピクセルを入力しても元のモデルが慣れ親しんだ表現に近い値がDiTに届きます。
さらに、ピクセル空間と潜在空間ではノイズの効き方が違うため、入力の振幅とタイムステップを定数倍で補正する「タイムステップ校正」を挟みます。DiTが学習時に見ていた信号対雑音比を再現するための調整です。
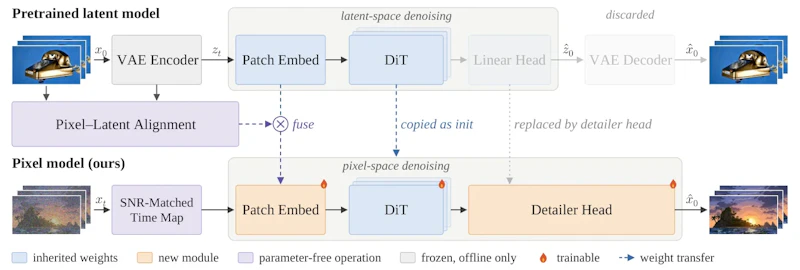
図2の下段に示されているように、出口側ではDiTの線形出力層とVAEデコーダをまとめてdetailer headと呼ぶ3次元畳み込みヘッドに置き換えます。パッチサイズに応じた段数のアップブロックを重ねて解像度を倍々に戻す構造で、14Bモデルでは3.37億パラメータです。
このヘッドの時間方向の畳み込みは因果的に設計されており、出力フレームは自分より過去の2フレームしか参照しません。フレームごとの逐次生成でも、直前2フレームをキャッシュしておけばそのまま動く仕組みです。
予測対象とノイズ設計の知見
論文が実装上の要点として強調するのは、何を予測させるかという選択です。近年のFlow Matching系モデルで一般的な速度予測をピクセル空間でそのまま使うと、出力がざらついたままになります。
著者らの計測では、推定されるピクセルノイズの中央値が速度予測で62.25、クリーン動画を直接予測する場合で0.78と、80倍近い差が出ました。あわせてノイズシフトの大きさも重要で、シフト値15(実効3.97)がVBench総合で最良でした。出力ヘッドについても、線形ヘッドではパッチ境界の格子状の継ぎ目が目立ち、継ぎ目の指標は118.6から畳み込みヘッドで13.3まで下がっています。
サンプラーの数値精度にも落とし穴がありました。bf16で状態を保持するとUniPCでは色が抜けてfp32比で彩度が91%に落ちるため、彩度をほぼ維持するEulerを採用しています。
解像度とトークン数の関係
ピクセル空間の利点が最も素直に現れるのが解像度です。潜在モデルでは解像度を上げるとトークン数が増えますが、PixVidはパッチサイズを16から32へ倍にすることで、トークングリッドを変えずに扱える画素数を4倍(縦横それぞれ2倍)にできます。
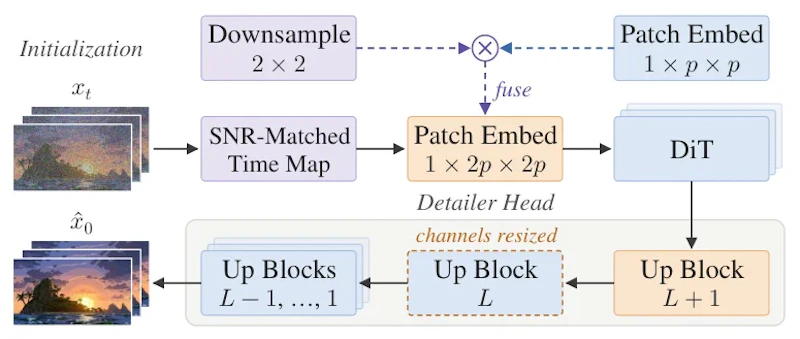
図3のように、新しいパッチ埋め込みは2×2の平均ダウンサンプリングを既存の埋め込みに融合して初期化し、detailer headには最近傍補間として初期化したアップブロックを1段足します。学習済みの知識を壊さずに入出力の縮尺だけを変える発想です。
結果として960×1664の生成が、DiT側のコストをほぼ据え置きで可能になりました。960pでは1クリップ32,760トークン・192秒で、Wan2.1の潜在モデルの37,440トークン・176秒と同程度の計算量に収まっています。
実験結果
テキストから動画を生成する課題では、Wan2.1が生成した約640万本の風景クリップを480×832に揃えて20K反復、B200を64枚で約57時間学習しています。評価はVBenchで行われ、元の潜在モデルを上回りました。
モデル | 総合 | 品質 | 意味 |
|---|---|---|---|
Wan2.1-T2V-14B | 84.05 | 84.91 | 80.63 |
PixelUMM (8B) | 83.72 | 84.19 | 81.86 |
PixVid 480p | 84.78 | 85.44 | 82.15 |
PixVid 960p | 85.09 | 86.19 | 80.68 |
Movie Gen Video Benchの100プロンプトを10人の評価者に見せた人間評価でも、すべての対戦組み合わせでPixVidが好まれています。ただしVBenchは評価時にフレームを512画素以下に縮小するため、高解像度で増えた細部そのものは測れていない点に注意が必要です。
深度条件付きの動画編集では差がより明確に出ました。時間圧縮のある潜在モデルは速い動きの被写体を滑らせたりぼかしたりしますが、PixVidは動き誤差が17.9から10.7へ改善し、保持できた動きの割合は83%から98%に上がっています。深度誤差やtLP、FVMDも改善した一方、FVDは91から118へ悪化しており、万能な改善ではありません。
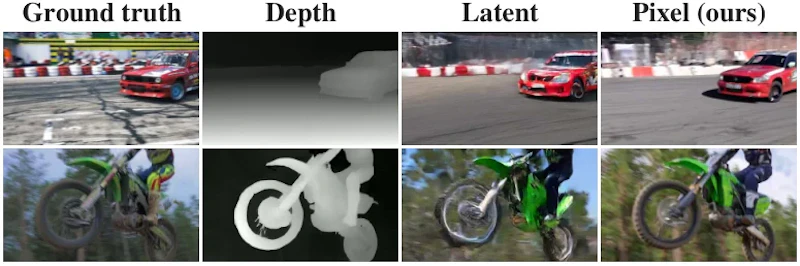
図5が示すのは、時間圧縮の副作用が動きの速い領域に集中するという点です。生成物理の破綻を言語モデルの知識で補正するPhysLoopのような後段の工夫とは異なり、PixVidは表現空間そのものを変えることで整合性を取りにいっています。
応答遅延と対話性
自己回帰生成の評価では、SolarWM-5BをSelf Forcingで4ステップに蒸留した因果モデルと比較しています。潜在モデルは12フレーム単位で生成するため制御入力が反映されるまで待ちが生じますが、PixVidは1フレーム単位です。
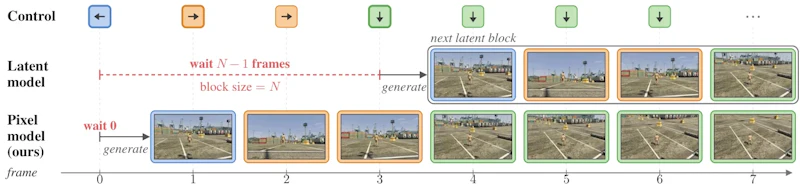
図6の色分けは、どの制御がどのフレームに反映されたかを表しています。中央値の遅延はSolarWMの495ミリ秒に対しPixVidは34ミリ秒で、旋回の追従指標も0.70から0.95へ改善しました。FVDも51.1と同等以上です。
一方でスループットは72.0fpsから29.4fpsへ落ちます。長いロールアウトではカメラ回転誤差が4.24度から5.44度へ、並進誤差も0.231から0.312へ悪化し、姿勢のドリフトが蓄積する課題が残っています。
まとめと今後の展望
PixVidは、潜在空間の圧縮が解像度・条件付けの粒度・応答遅延という3点を同時に縛っていたことを示し、学習済みDiTを流用しながらピクセル空間へ移す具体的な手順を提示しました。約130万クリップ規模の追加学習で潜在モデルと同等以上に到達した点は、この移植が現実的なコストで済むことを裏づけています。
ただし時間圧縮を捨てた代償として、480×832では1秒あたりのトークン数がWan2.1の約3.9倍に増えます。短く低解像度のクリップではむしろ割高になり、FVDの悪化やカメラドリフトも未解決です。
画像生成の分野で進んでいたピクセル空間拡散が動画へ広がった事例として、対話的な生成やワールドモデルの設計に影響を与えそうです。圧縮をどこまで捨てるべきかという問いは、用途ごとに答えが分かれることになるでしょう。
論文情報: "Back to Pixels: Lifting Latent Video Diffusion into Pixel Space"(Yanke Song et al., 2026) arXiv:2611.17336
本記事の図(図2、図3、図5、図6)は解説のため上記論文より引用しています。


