 AI-Papers
- 16体のAI研究エージェントが線形Attention構造を自律探索し、Context-First DeltaNet(CFDN)を発見した
- 1.3B規模で言語モデリング、常識推論、検索の全カテゴリでGated DeltaNet-2(GDN2)を上回った
- 学問的背景、私的な研究履歴、適応的な担当選択のいずれを外しても発見品質が落ちることを確認した
研究の背景
Transformerの自己Attentionは系列長に対して計算量が二次的に増えるため、線形Attention(状態を固定サイズのメモリに圧縮して逐次更新する仕組み)が長文処理の代替として研究されてきました。DeltaNet系の手法やその改良版であるGated DeltaNet-2(GDN2)は、この流れで到達した強いベースラインです。
こうしたアーキテクチャの改良は、研究者が仮説を立てて実装し、学習させて結果を読み解くという試行錯誤の積み重ねで進んできました。Large Language Model(LLM)に探索を任せる試みも増えていますが、単一のエージェントに探索させると早い段階で改善が止まりやすいという問題がありました。
カリフォルニア大学サンタバーバラ校などの研究チームは、この停滞を「個人の能力」ではなく「研究組織の設計」の問題として捉えました。異なる学問分野を背景に持つ研究者を並べ、記憶の持ち方と担当の割り振り方を設計することで、探索が続く仕組みを作ろうとした研究です。
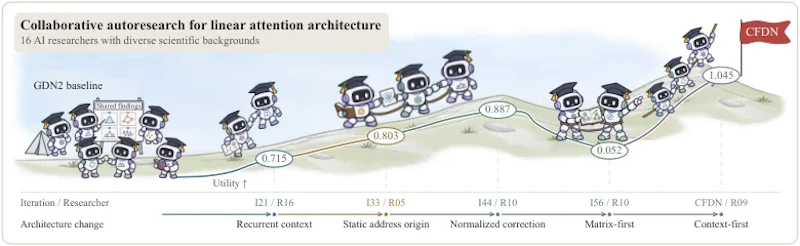
図1は研究の構図を示しています。多様な背景を持つエージェント群がGDN2を出発点に探索し、言語モデリングと常識推論、合成および実世界の検索タスクで改善された構造へたどり着く流れです。
16体の研究チームを組む
チームは16体の研究エージェントで構成されます。全員が同じ基盤モデルを使いますが、2000語程度の異なる科学的プロフィール(適応フィルタリング、予測表現、線形Attentionなど)で初期化され、それぞれが自分だけの研究履歴とメモを保持します。提案、レビュー、実験結果、そこから得た教訓はチーム全体で共有され、ディレクター役が10回の振り返りごとに教訓を整理します。
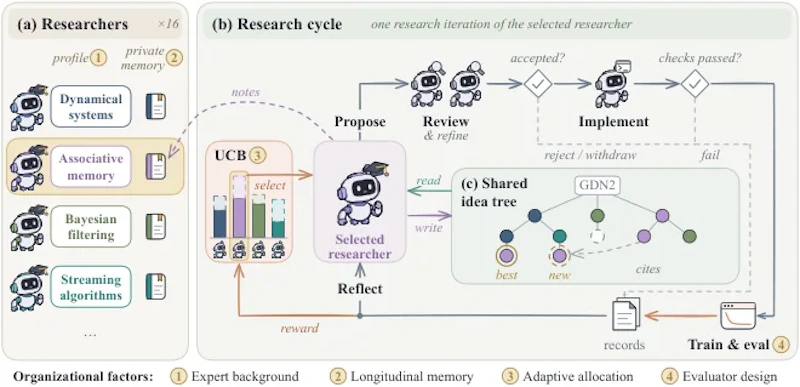
図2に示すように、1回の反復では担当者が1人選ばれ、仮説を提案し、技術面と文脈面のレビューを受けて改良し、承認されれば実装と実験に進みます。実装はGDN2の1.2倍以内のステップ時間に収まることを確認し、計算量を揃えて学習したうえで結果を振り返って共有します。
担当者の選び方には Discounted UCB を使い、実測された貢献度と、まだ試されていない研究者に機会を与えることのバランスを取ります。報酬はその反復の開始時点で最良だったモデルからの改善量で、負の値はゼロに丸められます。主要な探索は80反復で、そのうち63件が候補の実評価に至りました。評価指標は言語モデリング、常識推論、検索の正規化された改善量を等重みで平均した効用値です。
発見されたCFDNの仕組み
探索の結果として得られた Context-First DeltaNet(CFDN)は、GDN2の行列メモリに再帰的なコンテキストベクトルを追加したものです。行列メモリはクエリに応じた読み出しを返しますが、追加されたベクトルはどのクエリにも同じ項を寄与します。つまりメモリが「全体で共有される文脈」と「クエリ固有の補正」の2チャネルに分かれます。
手法名の由来は更新の順序にあります。各トークンでまずコンテキストベクトルを予測誤差に基づいて修正し、残った誤差だけを行列メモリの更新に回します。共有される情報を先に処理し、行列は文脈だけでは説明しきれない部分を学ぶという分担です。ヘッドごとに参照原点と2チャネルの重みを学習し、原点の移動による影響を補正するスケーリングも入ります。著者らによれば、この変更でGDN2に対する計算コストの目立った増加はなく、並列学習との両立も保たれます。
論文はCFDNの発見経緯も記録しています。線形Attention専門の研究者がコンテキストベクトルを導入し、別の研究者が参照原点の学習を加え、適応フィルタリングを背景とする研究者が補正の正規化を担い、予測表現に詳しい研究者が中間結果の悪化を受けて更新順序を反転させた、という4者の積み重ねです。再帰的な構造の設計という点では、PARとは?ループ型LLMの反復深度を揃え訓練長16倍の状態追跡を実現で扱った研究とも関心が重なります。
実験結果
探索中のフィードバックに使う簡易評価スイート(約150Mの探索スケール)では、言語モデリングのperplexity(予測の不確かさを表す指標、低いほど良い)が12.21から11.90に、常識推論の正解率が44.48%から44.63%に、検索タスクの正解率が28.91%から50.00%に変化しました。ただしこの検索スコアは生成文を採点するのではなく、固定した64例に対する教師強制での一致を測る代理指標です。
探索後の完全な評価では、同じ150M規模でWikiTextのperplexityが34.93から33.84へ、Needle-in-a-Haystack(長文からの情報抽出、NIAH)の正解率が25.79%から29.76%へ改善しました。一方で常識推論は43.60%から43.29%へわずかに低下しており、改善が一律ではないことも示されています。効用値ではCFDNが1.04でGDN2を上回りました。
1.3B規模まで広げた比較では、CFDNが全カテゴリで最良でした。NIAHでの差は小さい一方、perplexityと常識推論では明確な差が出ています。
モデル | WikiText ppl↓ | LAMBADA ppl↓ | 常識推論↑ | NIAH↑ | 実世界検索↑ |
|---|---|---|---|---|---|
GDN | 16.27 | 12.04 | 53.73 | 54.99 | 33.17 |
KDA | 16.05 | 11.66 | 53.90 | 59.11 | 32.47 |
GDN2 | 16.05 | 11.22 | 52.65 | 66.86 | 32.52 |
CFDN | 15.74 | 11.04 | 54.53 | 67.29 | 33.41 |
実世界検索はSWDE、SQuAD、FDA、TriviaQA、Natural Questions、DROPの6タスクでの平均です。探索の目標設定を変えた比較では、言語モデリングだけを目標にするとLAMBADAのperplexityは46.40まで下がる一方、常識推論と検索では3目標の探索に劣りました。何を測るかが何を見つけるかを決める、という関係がはっきり出た結果です。
組織の要素を外すと
チーム設計の各要素を外した探索も行われました。各条件で到達した最良の効用値は次の通りです。
条件 | 最良効用値 |
|---|---|
全要素あり | 1.04 |
学問的背景なし | 0.54 |
私的履歴なし | 0.56 |
一様な担当選択 | 0.76 |
背景を外した条件では22回目の反復で最良値に達し、その後は改善が止まりました。全要素ありの条件が68回目で最良に達したのとは対照的で、背景の多様性が局所解からの脱出に効いていると解釈されています。私的履歴を持たない条件は、同じ共有証拠を見ていても進捗が鈍りました。
まとめと今後の展望
この研究が示したのは、AIによるアーキテクチャ探索では個々のエージェントの性能だけでなく、記憶の分け方や担当の割り振りといった組織の設計が結果を左右するという点です。発見されたCFDNも、人間の設計した強いベースラインを複数の軸で上回っています。
一方で評価には限界があります。アブレーションは各条件1回の探索で、1.3Bの比較もモデルごとに1チェックポイントです。探索中の検索指標は代理指標であり、提案の親子関係も著者らが「宣言された関係」と述べるにとどまり、知識の継承が証明されたわけではありません。論文内でも本文と表で数値が食い違う箇所があり、引用時には出典の確認が必要です。棄却や失敗に終わった提案も予算を消費するため、探索効率の面では改善の余地が残ります。
論文情報: "Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures"(Yujian Liu et al., 2026) arXiv:2610.28887, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


