 AI-Papers
- ループ型言語モデルの第k反復に「k手実行後の状態」という明確な役割を与えるProgress-Aligned Recurrence(PAR)を提案
- Qwen2.5-0.5Bを32手までで訓練し、512手(16倍)の置換タスクで95.5%、比較手法のRLTは55.7%、明示的CoTは0.8%
- 中間ラベルがない場合もprefix自己蒸留で代替でき、停止判定もモデル自身が学習する
研究の背景
Transformerの層を使い回して何度も同じ計算ブロックを通す「ループ型(再帰型)言語モデル」は、推論時に反復回数を増やすだけで計算量を上積みできる構造を持ちます。深い思考が必要な問題には反復を増やせばよい、という発想です。
ところが実際には、反復を増やしても長い問題が解けるようになりません。原因は訓練の与え方にあります。最終解答だけを教師信号にすると、各反復が問題をどこまで進めるべきかが一切指定されないため、モデルは訓練時に見た長さに合わせた内部手続きを身につけてしまい、未知の長さへ外挿できません。
さらに、重みを共有したブロックを繰り返し適用すると再帰状態のスケール(ノルム)が反復ごとに膨らんだり縮んだりし、訓練で見た反復回数を超えた領域で表現が壊れます。PARはこの2点に正面から処方を与えた研究です。
提案手法
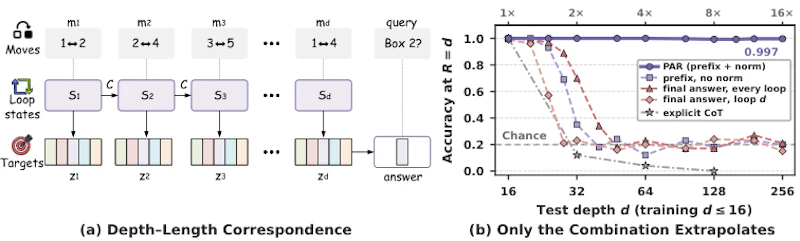
PARの中心は、図1の左に示された深さと問題長の対応づけです。状態追跡タスク(操作を1手ずつ適用して最終状態を答える問題)では、第k反復の出力が「最初のk手だけを実行した後の中間状態」になるよう教師信号を与えます。これにより、1反復=1操作という意味が明示され、問題が長くなれば反復を増やすという推論時の振る舞いが自然に成立します。
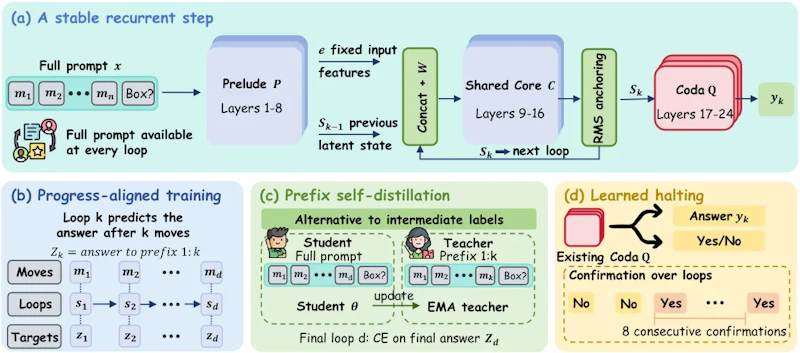
土台にはQwen2.5-0.5Bを流用し、1〜8層をprelude(前処理)、9〜16層を重み共有するcore(反復部分)、17〜24層をcoda(読み出し)に組み替えます。入力特徴と直前の状態を結合してcoreへ戻すアダプタは、初期状態で元のモデルと同じ関数を計算するよう初期化され、既存モデルからの移行がなだらかになるよう設計されています。
手法を支える要素は次の4つです。
- 進捗整合の目標設定(第k反復をk手後の状態に揃える)
- RMSノルム固定(各トークンの状態を第1反復時のノルムに再スケール)
- 学習型の停止判定(codaが完了をYes/Noで予測し、8回中6回の確認窓で終了)
- prefix自己蒸留(最終解答のみから中間状態の教師信号を作る)
停止判定は追加パラメータなしで実装され、問題の長さを外から与える必要がありません。prefix自己蒸留では、EMA(指数移動平均)で更新した教師モデルに短く切り詰めた入力を読ませ、その出力をKL(分布の差を測る指標)で第k反復に写します。中間ラベルを人手で用意できない現実的な設定への橋渡しになっています。
実験結果
主要な評価は対称群S5上の置換タスク(要素の入れ替えを繰り返し、最終配置を答える問題)です。32手までで訓練したモデルを512手で試すという、訓練長の16倍に相当する条件で比較しています。
手法・設定 | 512手での全状態正解率 |
|---|---|
PAR | 95.5%(±11.0) |
PAR(学習型停止判定) | 92.9%(±16.2) |
PAR(正解の深さを与えた上限値) | 93.2%(±16.3) |
RLT | 55.7%(±25.8) |
明示的なChain-of-Thought(CoT) | 0.8% |
停止深度を外から与えない学習型の停止判定でも、正解の深さを教えた場合とほぼ同じ精度に収まっています。中間ラベルを使わないprefix自己蒸留だけでも深度256で85%に達し、外挿倍率は16倍以上を維持しました。
構成要素の寄与も切り分けられています。ノルム固定を外すと外挿倍率は16倍から2.2倍未満へ落ち、進捗整合の目標を最終解答のみの監督に置き換えた場合は最大8倍までにとどまりました。固定深度・重み非共有の4倍core・ランダムな反復回数といった比較設定は、いずれも2倍未満です。2つの処方が揃って初めて外挿が成立する、という読み方になります。
より大きな土台でも試されており、深度256でQwen2.5の1.5Bが71.7%、3Bが57.8%、7Bが80.7%、Qwen3では0.6Bが36.2%、4Bが53.0%でした。固定深度の26.5%以下を上回る一方、シード間のばらつきが大きくモデルサイズに対する単調な改善は見られません。
まとめと今後の展望
PARは「反復の意味を訓練目標として明示する」という設計指針を、小型モデルで検証可能な形にまとめた研究です。推論時の計算量を問題の長さに応じて伸ばすという潜在推論の目標に対し、進捗整合とノルム固定という実装しやすい2つの処方を示した点に実用的な価値があります。長い手順を扱う工夫という観点では、文脈側を整理するCarryOnのようなアプローチと方向性が補完的です。
限界は著者自身が整理しています。評価はアルゴリズム的・テンプレート的な状態追跡タスクに限られ、自由な自然言語推論での効果は未検証です。グラフ到達可能性の課題では全手法が3.5倍未満にとどまり、逐次的な構造を持たないタスクは手法の適用範囲外だと述べられています。
加えて、停止判定・ラベルなし設定・置換タスクの主要結果はいずれもQwen2.5-0.5Bのみでの検証であり、大きな土台での再現性にはばらつきが残ります。反復深度の設計を訓練課題として扱う発想がどこまで一般の推論タスクに広がるかが、次の検証対象になるでしょう。
論文情報: "PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking"(Pan Wang et al., 2026) arXiv:2610.27628
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


