 AI-Papers
- メモリ管理を「学習可能な認知スキル」として定式化し、スキャフォールド最適化と習熟度トレーニングの2段階で自動改善するAutoMemフレームワークを提案
- Crafter・MiniHack・NetHackの3ゲーム環境でエージェント性能が約2〜4.4倍向上し、32Bオープンウェイトモデルがフロンティアモデルと同等水準に達した
- Qwen2.5-32BモデルがAutoMem最適化のみでClaude Opus 4.5・Gemini 3.1 Pro Thinkingと競争力ある性能を達成
研究の背景
LLMエージェントが長期タスクを遂行するには、過去の経験や知識を適切に記憶・参照する仕組みが欠かせません。しかし従来のアプローチでは、何をどのように記憶するかという「メモリ管理の設計」はエンジニアが手動で行うことが前提とされており、エージェント自身がこのスキルを学習できるとは考えられていませんでした。
認知科学では、人間が何を記憶すべきか・いつ思い出すべきかを判断する能力を「メタメモリ」と呼びます。AutoMemはこの概念をLLMエージェントに応用し、メモリ管理を学習可能な認知スキルとして定式化した点が核心的な貢献といえるでしょう。
AutoMemの2ループ設計
AutoMemは、エージェント本体を動かす「インナーループ」と、メモリ構造を改善する2つの「アウターループ」で構成されます。インナーループではファイルシステムをメモリとして使用し、エージェントはWRITE・READ・SEARCHなどのコマンドで情報を読み書きします。
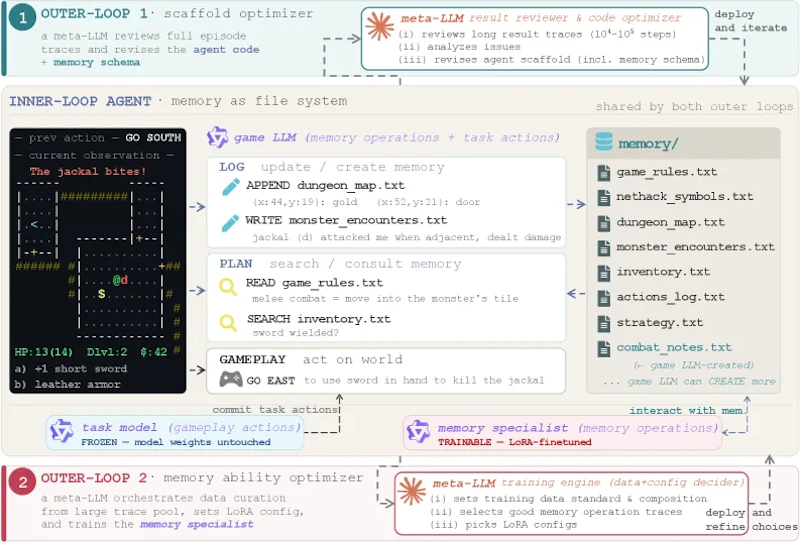
第1アウターループ(スキャフォールド最適化)では、強力なメタLLMがエージェントの全エピソード記録を分析し、プロンプト・ファイルスキーマ・操作語彙の3要素を反復的に改訂します。改訂が実際に性能を向上させた場合のみ採用する「ゲート制御」を設けているため、不必要な変更が蓄積されません。
第2アウターループ(メモリ習熟度トレーニング)では、良質なメモリ操作の事例を複数エピソードから収集してファインチューニングデータとし、タスク実行モデルを固定したまま「メモリ専門家モデル」だけを訓練します。この分離設計により、タスクの推論能力に影響を与えずにメモリ管理のみを強化できます。
評価環境
実験にはCrafter・MiniHack・NetHackという3種類の手続き生成ゲームを使用しました。エピソードごとに異なるマップが生成されるため事前学習の知識に頼れず、真の汎化能力が試される設定です。
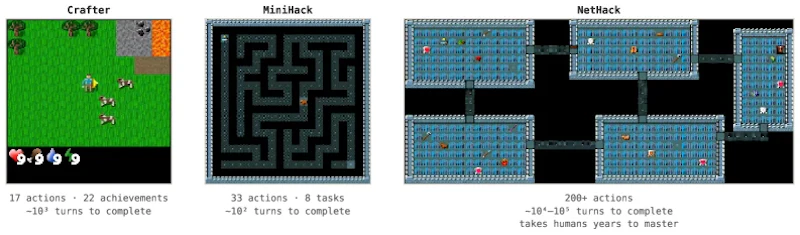
3環境の性格は次のように分かれます。
- Crafter: サバイバルとクラフトを扱う環境
- MiniHack: 迷路やパズルを解く環境
- NetHack: 1万〜10万ターンに及ぶ超長期探索環境
なかでもNetHackは難度が高く、人間のプレイヤーでも習熟に数年かかるとされます。このような極端に長い時間軸を持つ環境こそ、メモリ管理の重要性が際立つ舞台です。
実験結果
Qwen2.5-32B-Instructをベースモデルとして評価した結果、スキャフォールド最適化のみで3環境すべての性能が大幅に向上しました。さらにメモリ習熟度トレーニングで追加の改善が得られています。
環境 | ベース | スキャフォールド最適化後 | +メモリ訓練後 | 改善倍率 |
|---|---|---|---|---|
Crafter | 25.0% | 47.3% | 51.4% | 約2.1倍 |
MiniHack | 7.5% | 27.5% | 30.0% | 約4.0倍 |
NetHack | 0.42% | 1.57% | 1.85% | 約4.4倍 |
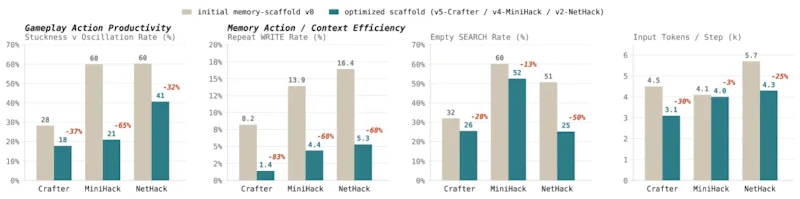
改善倍率はCrafterで約2.1倍、MiniHackで約4.0倍、NetHackでは約4.4倍となりました(全体として約2〜4.4倍の改善)。スキャフォールド最適化の効果を詳しく見ると、無駄な行動(立ち往生・往復)の割合が32〜65%減少し、冗長な書き込みは68〜83%削減されています。
最適化済み32Bモデルはフロンティアモデルとも比較されており、Claude Opus 4.5(Crafter 49.5%・MiniHack 27.5%・NetHack 2.0%)やGemini 3.1 Pro Thinking(Crafter 55.0%・MiniHack 27.5%・NetHack 2.6%)と競争力ある性能を示しています。ASPIREのようなエージェント型スキル学習の研究と同様に、学習の仕組み自体を工夫することで小規模モデルの実用性を大きく引き上げられることが改めて示されました。
まとめと今後の展望
AutoMemは、メモリ管理をエンジニアの設計事項から「エージェント自身が学習できるスキル」へと転換した研究です。スキャフォールド最適化とメモリ習熟度トレーニングの2段階が相補的に機能し、オープンウェイト32Bモデルをフロンティアモデルと同等の水準へ引き上げました。
今回の評価はゲーム環境に限定されており、文書作成や長期プランニングといった現実的なタスクへの汎化については今後の検証が必要です。一方で実験コードと結果は公開されているため、エージェント開発者がAutoMemを既存のシステムへ組み込む際の参考として直ちに活用できる点には実践的な価値があります。
論文情報: "AutoMem: Automated Learning of Memory as a Cognitive Skill"(Shengguang Wu et al., 2026) arXiv:2607.01224
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


