 AI-Papers
- LLMを次状態予測エンジンとして機能させる「言語世界モデル」を提案。7ドメイン・1,000万件超の実環境軌跡データで学習した汎用基盤を構築
- CPT(継続的事前学習)→SFT(教師ありファインチューニング)→RLの3段階パイプラインにより、AgentWorldBenchでGPT-4o・Gemini 2.5 Proを含む既存最先端モデルを超える総合スコアを達成
- 35B-A3Bと397B-A17Bのスパース構造モデルをGitHubで公開。実環境APIコストなしにエージェントRLの訓練データを生成できる汎用基盤として活用可能
研究の背景
言語エージェントが実際の環境で強化学習(RL: Reinforcement Learning)を行うには、膨大な試行錯誤が必要です。しかし、現実の環境でAPIを繰り返し呼び出したり、GUIを実際に操作したりしながら学習データを集めるのは、時間・コスト・セキュリティの観点から大きな障壁となります。
この問題を解決するアプローチとして注目されているのが「世界モデル(World Model)」です。環境の振る舞いを学習したモデルが「次の状態を予測する」ことで、実環境を使わずに訓練データを生成できます。ロボット制御や動画生成の分野では世界モデルの研究が進んでいますが、言語エージェント向けの汎用的な世界モデルは不足していました。
Qwenチームが発表したQwen-AgentWorldは、大規模言語モデル(LLM)そのものを言語世界モデル(LWM: Language World Model)として機能させる研究です。エージェントが行動を入力すると、次の環境状態をテキストで予測する「環境シミュレーター」を、単一のモデルで7つのドメインにわたって実現しています。
7ドメイン統合と3段階学習パイプライン
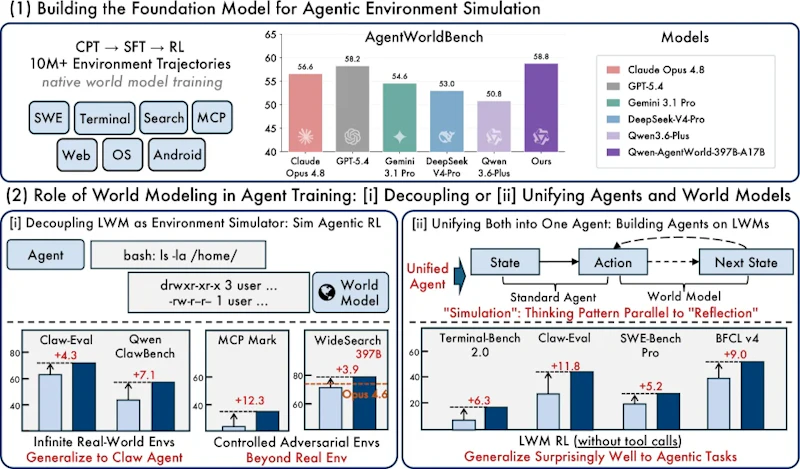
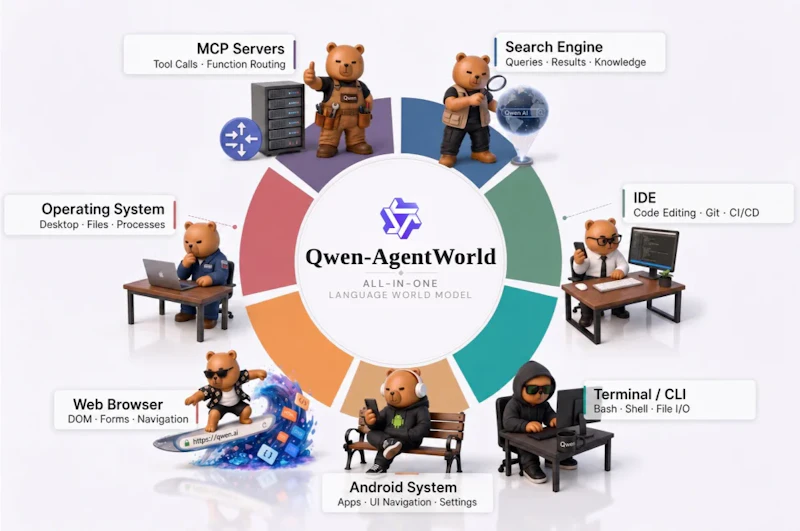
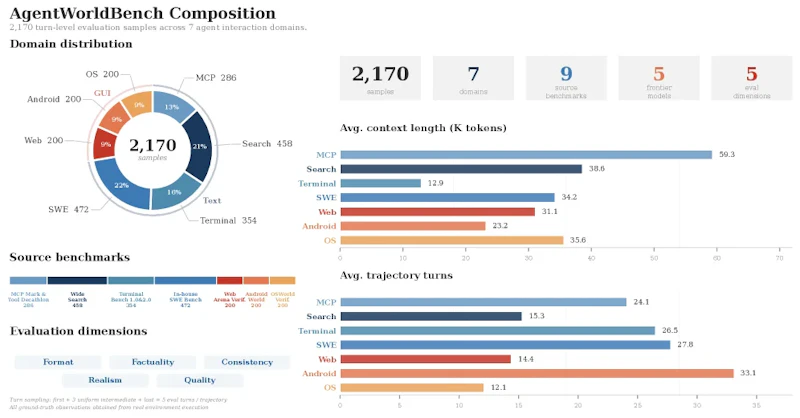
Qwen-AgentWorldが対応する7つのドメインは、ターミナル操作(Terminal)、ソフトウェアエンジニアリング(SWE)、Androidアプリ操作(GUI)、OS操作、Webブラウジング、MCP(Model Context Protocol)ツール呼び出し、Web検索(Search)です。これら7ドメインにわたる1,000万件超の実環境インタラクション軌跡を学習に使用しています。
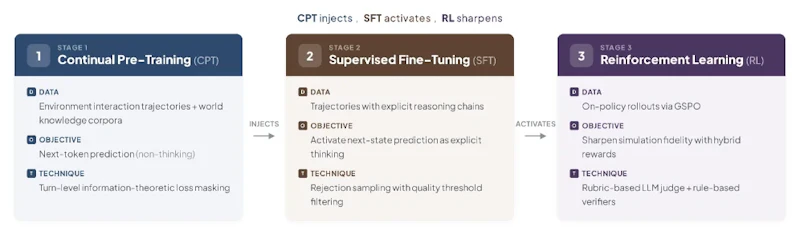
学習は以下の3段階のパイプラインで行われます。
- Stage 1(CPT: Continual Pre-Training、継続的事前学習):環境の状態遷移に関する世界知識を大量データから注入する段階
- Stage 2(SFT: Supervised Fine-Tuning、教師ありファインチューニング):「次の状態を予測する」という思考パターンをモデルに定着させる段階
- Stage 3(RL: Reinforcement Learning、強化学習):ハイブリッドスコアリング報酬フレームワークを使って出力の精度を引き上げる段階
Stage 3の強化学習では、5つの評価軸を使ってモデルの出力を採点します。Format(出力形式の正確さ)、Factuality(事実との整合性)、Consistency(文脈との一貫性)、Realism(実際の環境出力らしさ)、Quality(総合的な品質)です。この5次元の報酬シグナルにより、単純なテキスト一致では捉えられない細かい精度改善を実現しています。
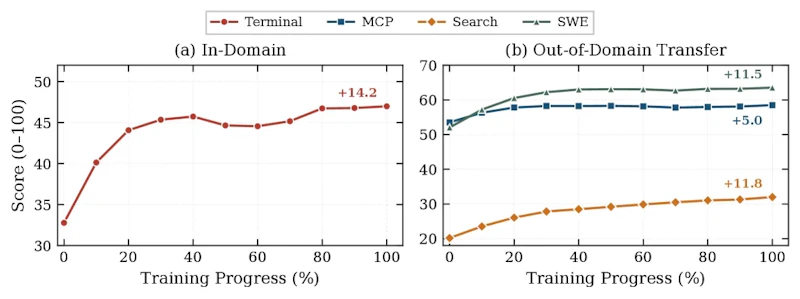
Terminal領域のデータのみでRL学習を行った場合でも、MCP(+5.0ポイント)、SWE(+11.5ポイント)、Search(+11.8ポイント)という形で、ドメイン固有の学習信号を受けていない領域にまで改善が波及することが確認されています。これはこの3段階パイプラインが特定ドメインへの過適合ではなく、汎用的な環境理解能力を育てていることを示しています。
AgentWorldBenchによる評価
評価には、7ドメイン・9つのベンチマークを統合したAgentWorldBenchを使用しています。すべての正解観測データは実環境を実際に実行して取得したものです。
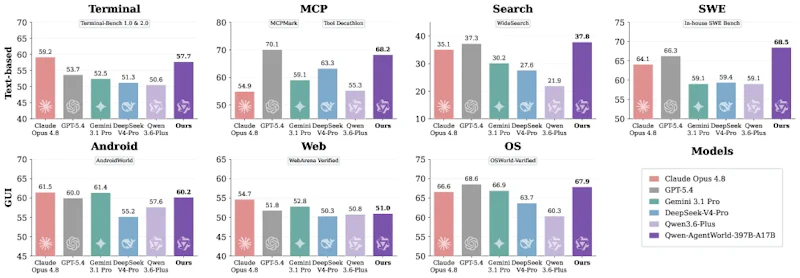
主要な評価結果では、Qwen-AgentWorld-397B-A17BがAgentWorldBench全体の平均スコアで最高値を達成しました。比較対象として、OpenAIのGPT-4o、Googleの Gemini 2.5 Pro、Claude 3.7 Sonnetなどの主要フロンティアモデルが含まれており、テキストベースのドメイン(Terminal・SWE・Search・MCP)では特に顕著な優位性を示しています。GUIドメイン(Android・OS・Web)では同等以上の競争力を持ちつつ、全体平均でほぼすべての比較対象を上回っています。
また、Terminal領域のみでRL訓練を行った際のドメイン横断汎化実験では、RL前後の差として学習対象外の3ドメインでも大幅な改善が確認されています。ロボットエージェント学習でも同様のスキル転移効果が報告されていますが、Qwen-AgentWorldではそれが純粋にテキストベースの世界モデル学習から生じている点が特徴的です。
2つの活用戦略
論文では、世界モデルをエージェントに活用するための2つの異なる戦略を提案しています。
1つ目はDecouple(分離型)です。世界モデルが環境シミュレーターとして機能し、エージェントは実環境の代わりにこのシミュレーター上でRLを行います。実APIへのアクセスコストや待機時間を大幅に削減しながら、豊富な訓練シグナルを得られます。
2つ目はUnify(統合型)です。世界モデル自体をエージェントの基盤モデルとして使用します。環境の次状態を理解する能力が、エージェントとしての行動生成にも直接貢献するという考え方です。
主要な実験では35B-A3Bモデルをエージェントとして使用していますが、両戦略ともに既存手法に対して有意な改善を示しています。
公開モデルとアーキテクチャ
リリースされたモデルは2種類あります。Qwen-AgentWorld-35B-A3Bは総パラメータ数35Bのうち推論時に3Bのみ有効化するスパースMoE(Mixture of Experts: 複数の専門モジュールを状況に応じて切り替えるアーキテクチャ)構造です。Qwen-AgentWorld-397B-A17Bは総パラメータ数397Bのうち17Bを有効化する大規模版です。
MoE構造を採用することで、大きなモデル容量を持ちながら推論コストを抑えられます。両モデルともGitHubで公開されており、自前のエージェントRLパイプラインの環境シミュレーターとして組み込むことが可能です。
まとめと今後の展望
Qwen-AgentWorldは、LLM自体を言語世界モデルとして訓練するという方針で、エージェントRLの訓練データ不足という実用上の大きな課題に取り組んでいます。7ドメイン・1,000万件超の実軌跡データを3段階パイプラインで学習した結果、主要なフロンティアモデルを上回る環境シミュレーション精度を実現しました。
一方で課題もあります。現状の評価はテキストベースの出力精度に重点を置いており、実際にこの世界モデルを使ったエージェントRLが実タスクでどれほど効果的かは、さらなる検証が必要です。また、7ドメイン外への汎化性能や、より複雑な複数ステップ軌跡への対応についても今後の研究課題として残っています。実環境インタラクションを代替するシミュレーターとして成熟すれば、エージェント開発のコストと安全性の両面で大きな恩恵をもたらす可能性があります。
論文情報: "Qwen-AgentWorld: Language World Models for General Agents"(Yuxin Zuo et al., 2026) arXiv:2606.24597
本記事の図(図1、図2、図5、図6、図7、図8)は解説のため上記論文より引用しています。


