 AI-Papers
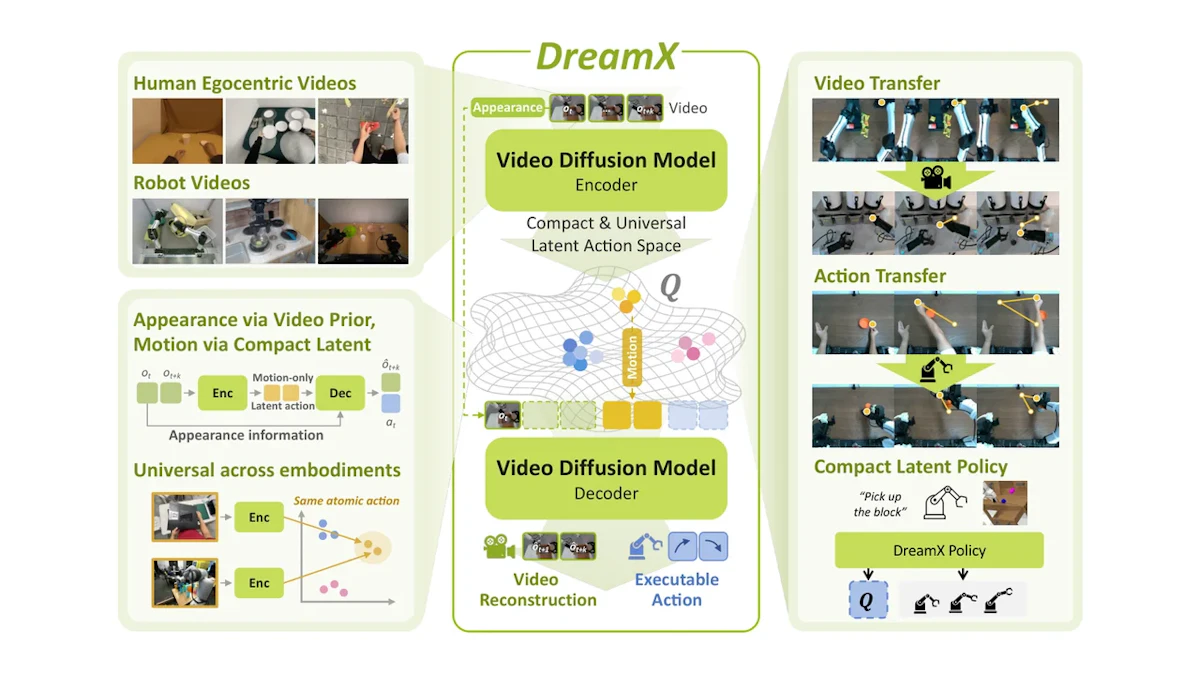
- 事前学習済み動画拡散モデル Cosmos-Predict2.5 をエンコーダ兼デコーダに転用し、身体構造や見た目に依存しない潜在アクションを学習する手法 DreamX が提案されました
- 潜在フレーム1枚あたり1,200トークンを4トークンへ約300倍圧縮しつつ、LARYBench の行動回帰で平均MSE 0.17(DiLA 0.38)を達成しています
- 人間とロボットの対応付きデータなしで、ゼロショットの人間→ロボット動画転移で FVD 57.44(AdaWorld 170.19)を記録しました
研究の背景
ロボットに新しい作業を覚えさせるには、通常その身体で集めた操作データが必要です。一方で、人間が一人称視点で撮った動画は大量に存在します。この差を埋める考え方として近年注目されているのが潜在アクション(連続するフレーム間で何が起きたかを少数の特徴量で表した表現)です。
動画から「どう動いたか」だけを抜き出せれば、人間の動作をロボットの指令に読み替える共通の言語になります。しかし既存の潜在アクションモデルは、動作の情報と見た目の変化が混ざってしまう傾向がありました。背景が変わっただけで表現が揺れてしまうと、人間からロボットへ、あるいは別のロボットへ動作を移すことが難しくなります。
KAIST などの研究チームが2026年11月に公開した論文「DreamX: Video Diffusion Model is a Universal Latent Action Learner」は、この問題に対して少し意外な道具を持ち込みます。動画生成のために事前学習された拡散モデルを、そのまま潜在アクションの学習器として使い回すという発想です。
動画拡散モデルを転用
ベースになるのは動画拡散トランスフォーマーの Cosmos-Predict2.5 2B です。本体の重みは凍結したまま、エンコーダ側とデコーダ側にそれぞれ rank 16 の LoRA(少数の追加パラメータだけを学習する手法)を挿します。
エンコーダでは、潜在フレーム1枚につき4個の学習可能なクエリトークンを動画トークンに付け足し、時空間方向の注意機構を通して情報を読み出します。これにより1,200トークン分の情報が4トークンへ、約300倍圧縮されます。クエリから動画への注意はフレーム因果的に制限され、未来を覗き見しない構造になっています。
デコーダは同じ事前学習済みモデルから初期化され、最初の1フレームと潜在アクションだけを手がかりに後続の動画を再構成します。ここでテキスト指示は与えません。言葉に頼らず動きだけで未来を復元させることが、潜在アクションに動作情報を集める圧力になります。ロボットデータのように行動ラベルがある場合は、関節状態から行動列を復元する補助的な損失も加え、Flow Matching による動画の損失と重み付きで足し合わせます。
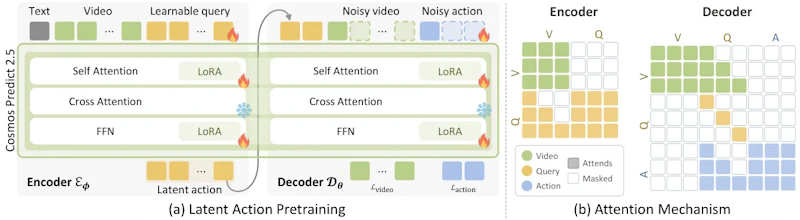
図2の(b)に示されているように、デコーダ内では動画トークンと行動トークンは互いを参照せず、どちらも潜在アクションのクエリだけを読みます。動画と行動という異なる出力を、同一の潜在アクションを介して結びつける設計です。
学習データは EgoDex と EgoVerse の人間動画469時間に、Bridge、DROID、AgiBot などのロボットデータを加えた計約2,190時間です。480×640解像度で78,000ステップ学習しています。動画生成モデルの事前知識を別タスクへ流用する流れは、FrameForgeとは?動画モデルの時間知識を使い画像生成を統合する新手法でも見られるもので、DreamX はその対象をロボット制御側へ広げた例といえます。
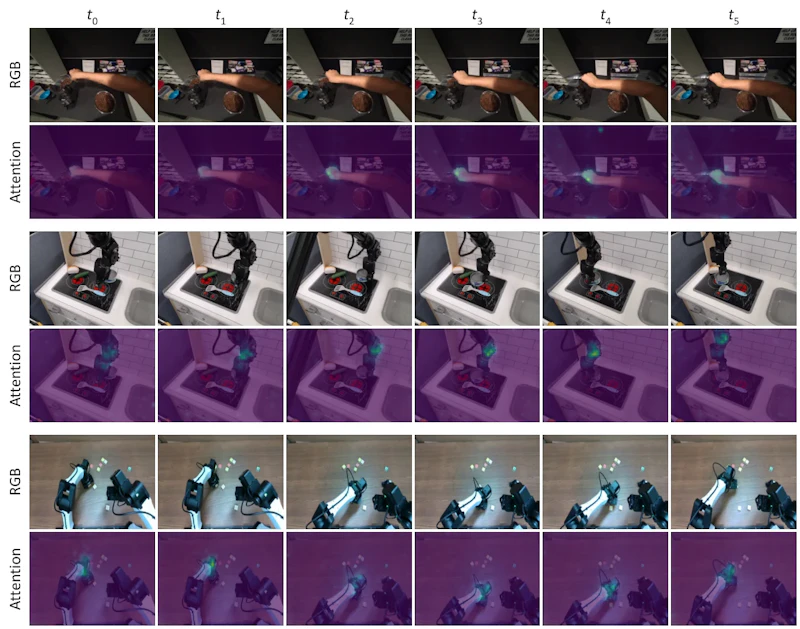
学習された表現が本当に動作を捉えているかは、図8の注意マップから読み取れます。人間のデモでもロボットのデモでも、クエリは動いている手やグリッパーといった領域に注意を向けていました。さらに潜在アクションに摂動を加えると、場面の見た目は保たれたまま動きだけが変化します。
潜在アクションの3つの使い道
共通の表現が得られると、学習し直さずにいくつかの応用が開けます。1つめはAny-to-Any 動画転移で、元動画から抽出した潜在アクションを、別の場面やロボットの初期フレームに与えて動画を生成します。2つめは行動転移で、同じ潜在アクションを対象ロボットの状態と組み合わせ、実行可能な低レベル行動へ復号します。いずれも人間とロボットの対応付きデータを使いません。
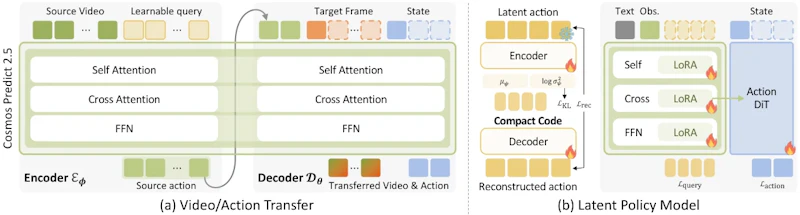
3つめが図3の(b)にある方策学習です。変分ボトルネックで各潜在トークンを2,048次元から32次元へ絞り、現在の観測と指示を条件に潜在コードを生成しつつ、別の DiT 行動ヘッドが低レベル行動を出します。動画拡散モデルをそのまま方策に使う方式に比べ、扱うトークン数が大幅に減る点が利点です。
実験結果
潜在アクション表現の評価には LARYBench を使っています。モデルを凍結したまま共通のプローブを学習させ、細かな動きを復元できるか(回帰)と動作の意味を区別できるか(分類)を測る設計です。DreamX は既存の潜在アクションモデルを上回りました。
手法 | 回帰 平均MSE ↓ | 分類 平均精度 ↑ |
|---|---|---|
DreamX | 0.17 | 69.67% |
DiLA | 0.38 | 62.25% |
MoTo | 0.44 | 51.01% |
LAPA(DINOv3版) | 0.60 | 49.17% |
AdaWorld | 0.69 | 44.29% |
UniVLA | 0.87 | 18.75% |
ゼロショットの人間→ロボット動画転移は、21タスク1,008クリップからなる HumanAndRobot ベンチマークで評価されました。人間の動画とロボット側の初期フレームだけを与え、生成された19フレームをロボットの参照動画と比べる手続きです。
手法 | FVD ↓ | LPIPS ↓ | PSNR ↑ | SSIM ↑ |
|---|---|---|---|---|
DreamX | 57.44 | 0.179 | 26.52 | 0.917 |
AdaWorld | 170.19 | 0.344 | 22.95 | 0.846 |
VideoWorld2 | 241.92 | 0.299 | 22.53 | 0.881 |
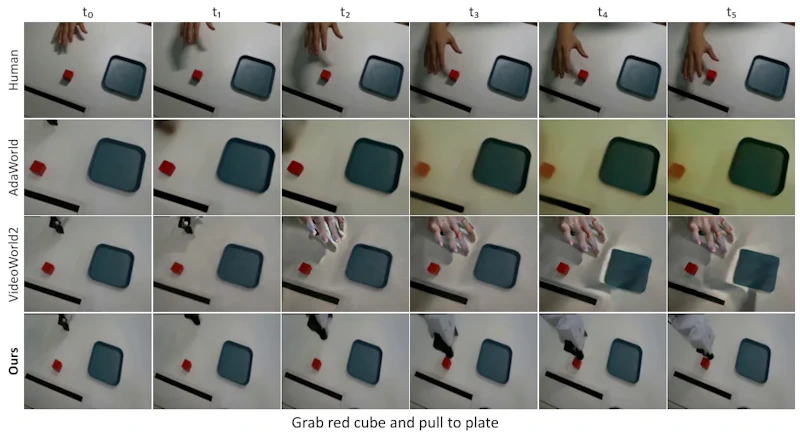
図5を見ると差の中身が分かります。比較手法では画質が崩れたり、ロボットであるはずの映像に人間の手が混ざり込む現象が起きていました。DreamX は動きだけを移し、対象ロボットの外見を保っています。
実機の方策評価では、引き出しを閉じる課題でサブゴール成功率が平均96.7%、1回の推論が約1,474ミリ秒でした。動画生成を直接使う Mimic-Video は成功率50.0%、28,226ミリ秒で、推論速度は約19倍の差がついています。シミュレータの CALVIN でも、潜在アクションを条件に加えることで平均達成系列長が2.378から2.643へ伸びました。
課題と今後の展望
数値は良好ですが、評価範囲は限られています。実機の方策検証は引き出しを閉じる単一タスク、学習軌跡45本、各設定10試行という規模です。また行動転移は視覚フィードバックを伴わない開ループ実行で、著者自身も評価設定の外では転移や方策が失敗しうると述べ、実運用前の安全性検証を求めています。
推論1回に約1.5秒かかる点も、接触を伴う素早い操作には重い水準でしょう。興味深いのはアブレーションの結果で、エンコーダへの行動ラベル監督を加えても回帰MSEは0.24から0.23とわずかな改善にとどまりました。動作の情報は動画だけからおおむね取れているという解釈で、ラベルのない人間動画を活かす方向性を支持する材料になります。
コードは現時点で公開が確認できませんが、ベースの Cosmos-Predict2.5 は公開済みであり、追試の見通しは立てやすい構成です。動画生成モデルの事前知識をロボットの行動表現として使う筋道が、ラベル不足という制約にどこまで効くのかが次の焦点になります。
論文情報: "DreamX: Video Diffusion Model is a Universal Latent Action Learner"(Jisoo Kim et al., 2026) arXiv:2611.05377, CC BY 4.0
本記事の図(図2、図3、図5、図8)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


