 AI-Papers
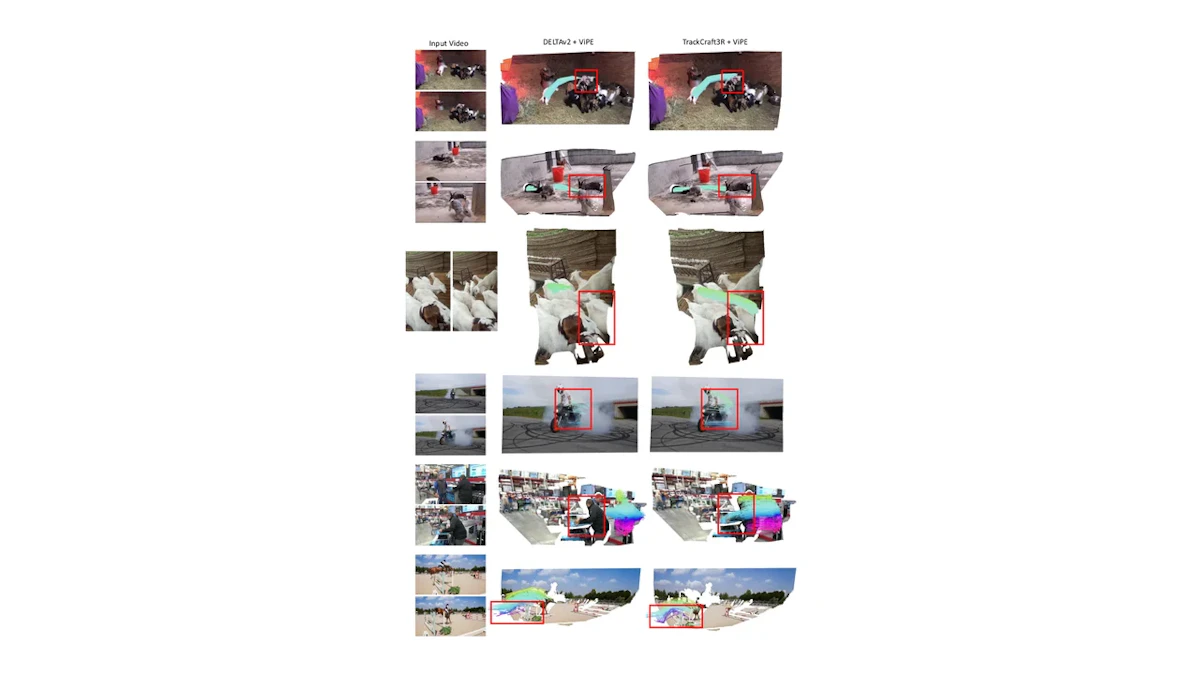
- Wan 2.1-T2Vビデオ拡散Transformerの事前学習知識を密な3D追跡に転用した初の手法で、4つのベンチマークでSOTAを達成
- デュアル潜在表現とTemporal RoPEアライメントにより、参照フレーム固定の高精度な3D軌跡の復元を実現
- DELTAv2比でメモリ使用量4.6倍削減・推論速度1.3倍高速化を達成し、単一GPUでの実運用が現実的に
研究の背景
動画中の全ピクセルを3次元空間で時系列追跡する「密な3D追跡(Dense 3D Tracking)」は、自律走行・ロボット操作・AR/VRなど幅広い応用で核心的な技術です。遮蔽や大きな物体の動きへの頑健性が求められる一方、高精度な推定には大量の計算資源が必要とされてきました。
近年、動画生成モデルは膨大な映像データから豊かな時空間的知識を獲得しています。ただしその知識は「各フレームの内容を新たに生成する」という目的で蓄積されたもので、「参照フレームの点が後続フレームでどこに移動したか」を出力する追跡タスクとは定式化が根本的に異なります。この乖離こそが、生成モデルを追跡に転用する際の最大の壁でした。
TrackCraft3Rの提案手法
Googleの研究チームが提案するTrackCraft3Rは、Wan 2.1-T2Vと呼ばれるビデオ拡散Transformer(動画生成のための大規模モデル)を密な3D追跡器として転用した初の試みです。「フレーム固定型生成」から「参照固定型追跡」への定式化変換を、デュアル潜在表現とTemporal RoPEアライメントという2つの設計で解決しています。
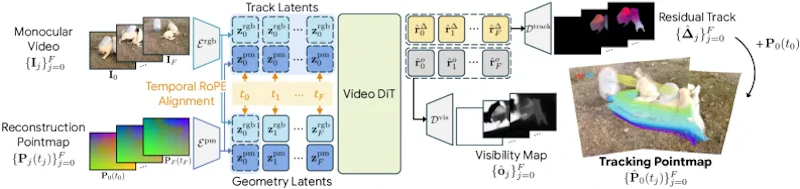
幾何潜在(Geometry Latent)は、各フレームのRGB情報とその時刻における3D座標(ポイントマップ)をチャンネル方向に結合した表現です。シーンの幾何学的な状態を各タイムスタンプで記述する役割を持ちます。一方の追跡潜在(Track Latent)は、参照フレーム(第1フレーム)の幾何潜在を全タイムスタンプに複製したもので、「最初のフレームにある点が各時刻でどこに移動したか」を出力するための密なクエリとして機能します。
2つの潜在表現はトークン次元で結合されてビデオDiTに入力されます。ここで鍵となるのがTemporal RoPE(回転位置埋め込み)のアライメントです。各追跡潜在に「目標とするタイムスタンプ」を割り当て、Transformerの注意機構が時系列的に対応する幾何潜在へ優先的に注目するよう誘導します。このRoPEアライメントは精度向上への寄与が最も大きく、除いた場合のAJスコア低下(0.5609→0.4450)はほかのどの設計要素よりも大きくなりました。
出力側では、追跡潜在を専用のVAEデコーダで変換して残差追跡(Residual Track)と可視性マスクを取得します。残差予測の採用により、大きな動きがある場面での安定性も確保されました。
学習にはLoRAを用いた2段階の微調整を採用しています。第1段階でLoRAと入出力射影層を調整した後、第2段階でVAEエンコーダ・デコーダ全体を解凍してエンドツーエンドで学習します。
実験結果
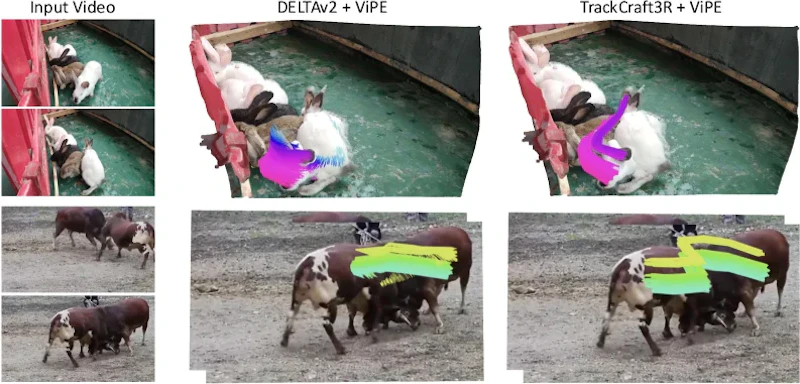
TrackCraft3Rは、TAPVid-3D・ADT・PStudio・PointOdysseyの4つのベンチマークで既存手法を上回る精度を記録し、密な3D追跡の新たな最高水準に達しました。平均APD3D(3D追跡精度の主要指標)は0.7931で、比較対象のDELTAv2(0.6858)を大きく超えています。
計算効率の改善も大きく、12フレームの処理でDELTAv2と次の表のような差がつきました。
項目 | TrackCraft3R | DELTAv2 |
|---|---|---|
平均APD3D | 0.7931 | 0.6858 |
処理時間(12フレーム) | 3.91秒 | 5.00秒 |
メモリ使用量 | 7.63GB | 35.46GB |
処理時間は1.3倍高速、メモリ使用量は4.6倍削減にあたります。単一GPUでの運用が現実的な水準に達しており、実用化へのハードルを大きく引き下げました。
頑健性の評価では、フレーム間の動きが大きいケース(ストライドs=12)においても性能の低下がDELTAv2より緩やかです。また学習時の長さ(12フレーム)を大幅に超える120フレームの長尺動画への汎化も確認されており、実世界の多様なシナリオへの適応力が示されています。
設計要素の貢献
アブレーション実験では、各設計要素が性能に与える影響を個別に検証しています。Temporal RoPEアライメントの除去がAJスコアを最も大きく低下させ(0.5609→0.4450)、参照フレーム固定を外した場合も大幅な低下(0.5609→0.5135)が見られました。残差予測の削除でもAPD3Dが0.6790から0.6172へ低下しており、いずれの設計も精度維持に不可欠であることが明らかになっています。
VAEの時間圧縮を有効にした場合には全指標が低下しました。動画生成モデルが時間軸を圧縮して処理する通常の構成では、追跡タスクに必要なフレームレベルの時間解像度が失われてしまうためで、この点においても追跡と生成の定式化の違いが浮き彫りになっています。
まとめと今後の展望
TrackCraft3Rは、動画生成モデルの事前学習知識を幾何学的知覚タスクへ活用する方向性を示した研究です。AnyFlowなど動画拡散モデルの関連研究と同様に、事前学習済みモデルの知識を別タスクへ転用する動きが加速しており、TrackCraft3Rはその方向性に確かな成果を加えるものです。
現在の制約として、性能は入力する深度情報とカメラ姿勢の品質に依存します。グラウンドトゥルースの深度を用いた場合はAPD3Dが0.8635まで向上しますが、実運用では単眼深度推定器(DA3)を用いた0.7931が現実的な上限です。
単眼深度推定の精度向上や複雑な遮蔽シナリオへの対応が、今後の発展の鍵となるでしょう。3D追跡にとどまらず光学フローや深度推定など隣接領域への展開も期待される手法です。
論文情報: "TrackCraft3R: Repurposing Video Diffusion Transformers for Dense 3D Tracking"(Jisu Nam et al., 2026) arXiv:2605.12587, CC BY 4.0
本記事の図(図1、図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


